按标签浏览
# 多模态桥接 / multimodal bridge(15)
为纯文本模型提供图像理解能力,通过可配置的视觉模型(默认智谱 GLM-4V-Flash)将图片转为文字描述并回传至 DSH 会话。
插件通过调用视觉模型将图片转换为文字描述,使纯文本模型能在对话中处理图片。
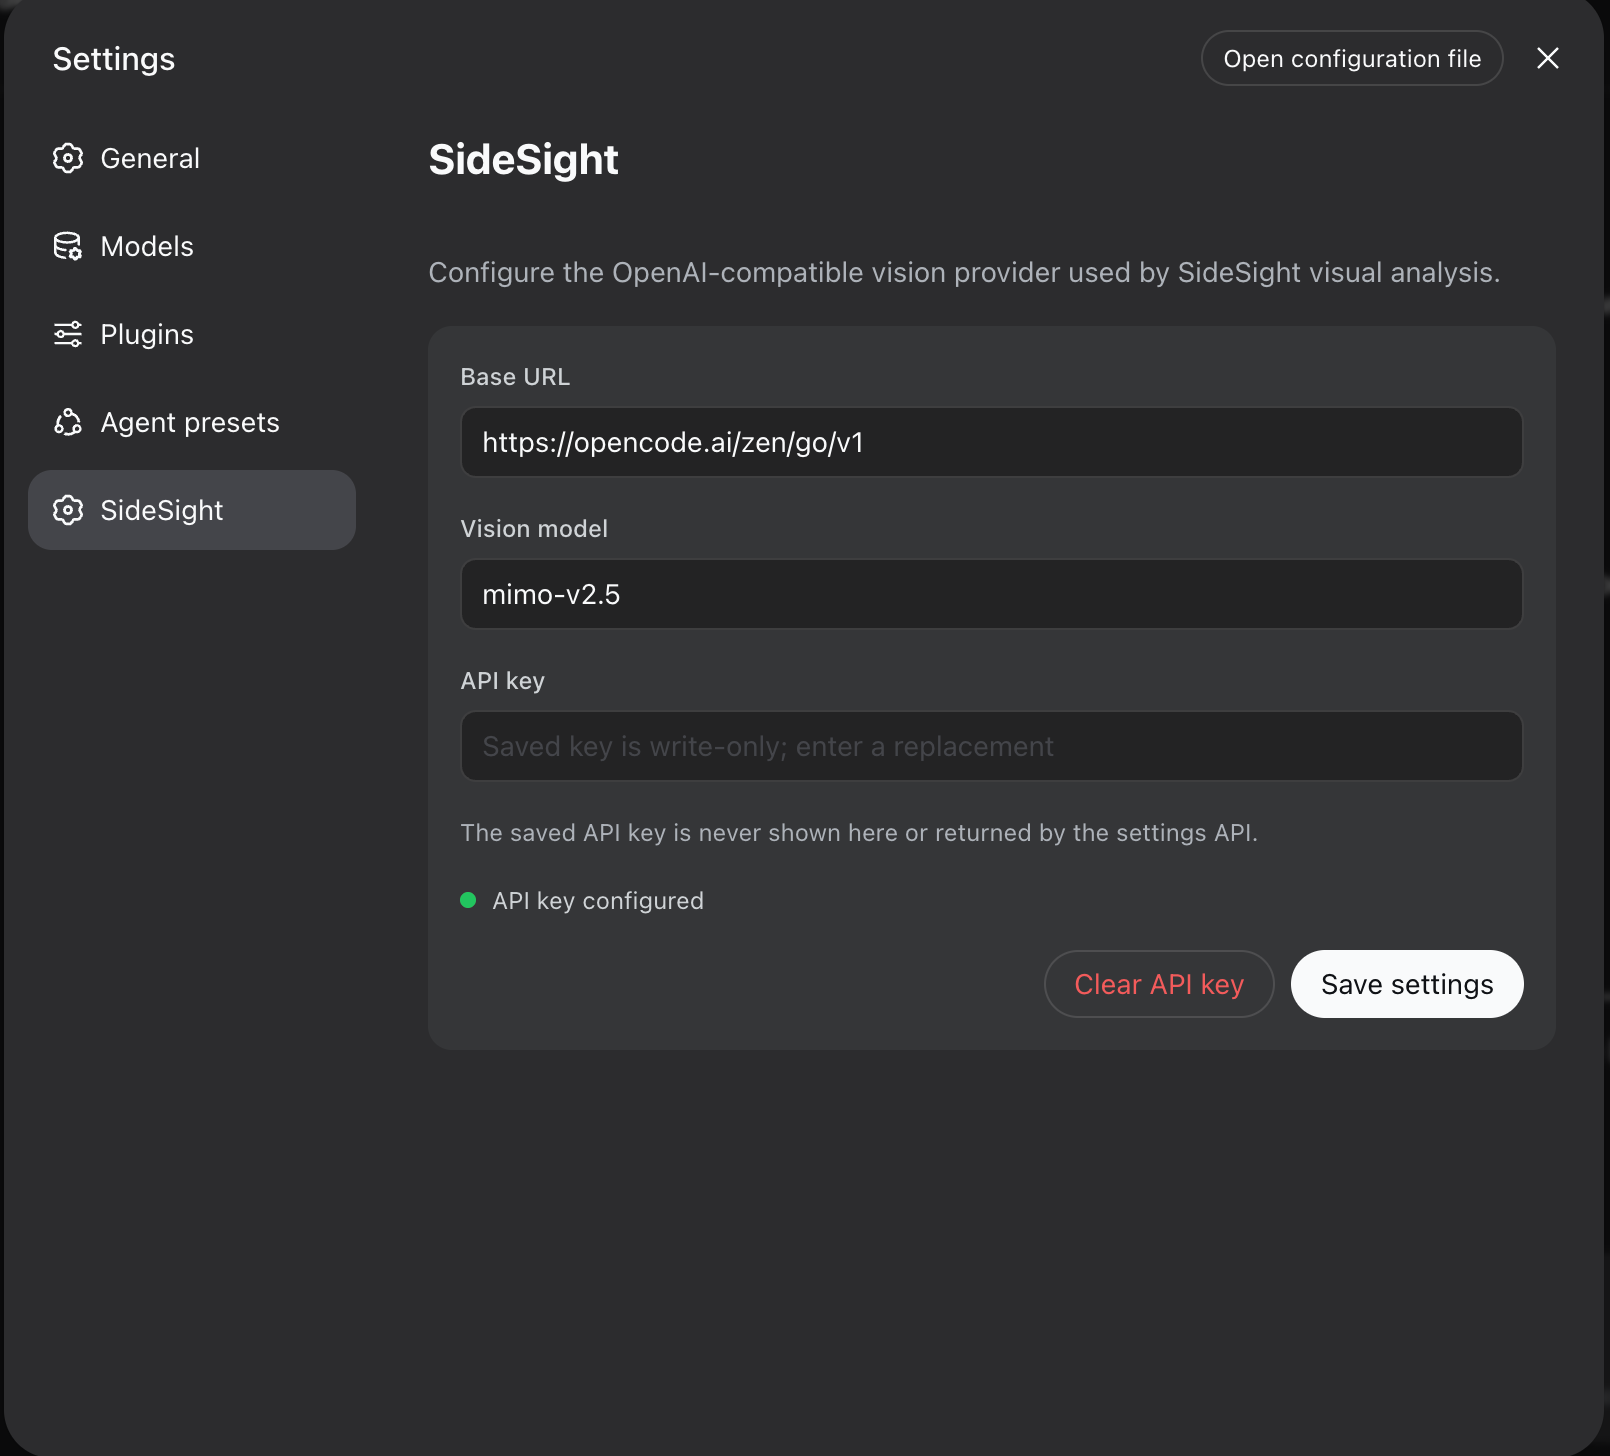
为文本模型提供图像分析能力,支持截图、图表、UI差异对比及本地OCR,适用于 DeepSeek Harness。
DSH 插件合集 monorepo,含 MCP/Skills 管理器、多 Key 轮换、纯文本模型视觉桥接,自动发布至 npm。
为纯文本 LLM 提供看图能力,调用视觉模型将图片转为带百分比坐标的结构化空间文字,支持任意 OpenAI 兼容视觉模型,零硬编码可配置。
为纯文本模型提供即插即用的图片读取:粘贴图片以[Image #N]注入,经可配置视觉模型转写为文本描述,无需修改预设。
为 DeepSeek Harness 纯文本模型添加视觉能力,粘贴图片即由视觉模型自动转写后作答,支持工具调用与设置页配置。
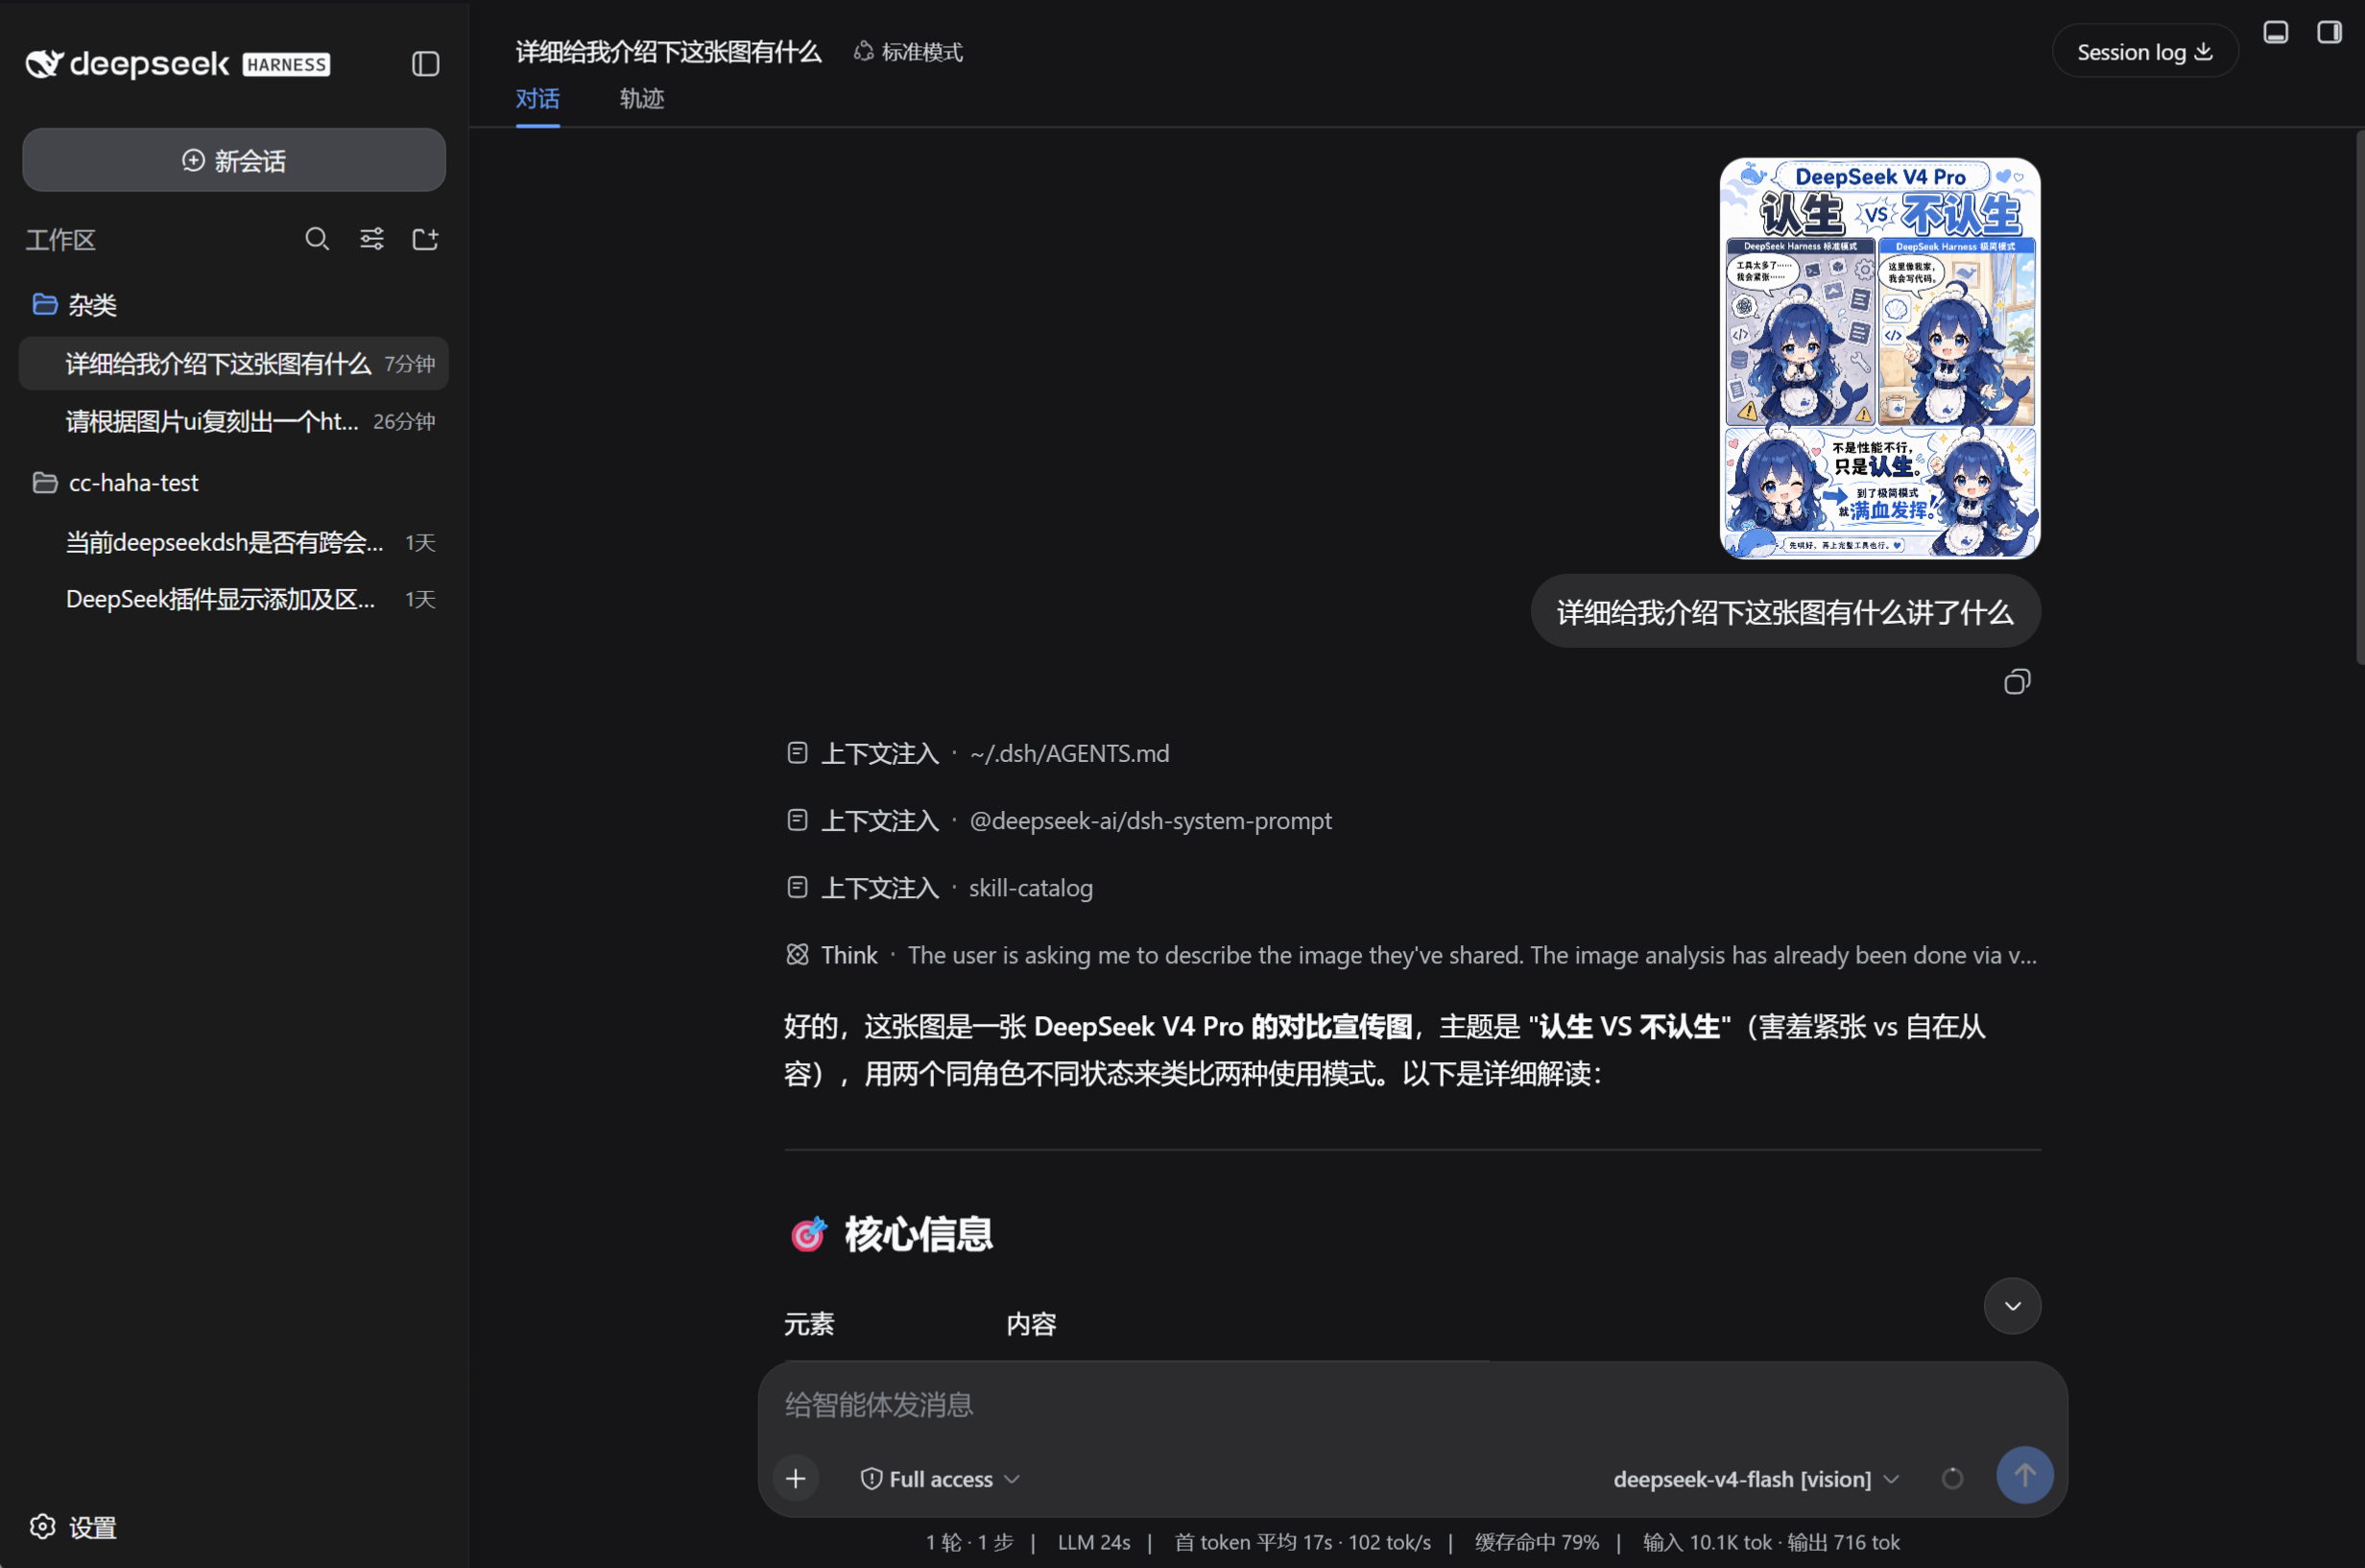
为纯文本模型补充视觉能力,将图片交由外部视觉模型分析后返回带空间定位的纯文本证据,支持11类视觉任务自动识别与结构化输出。
将图片自动翻译为文字描述供纯文本模型使用,多模态模型则直接放行,让DeepSeek等文本模型也能处理含图消息。
让纯文本的 DeepSeek-V4-Pro 无需切换模型即可处理图片,自动调用 Flash-Vision-Exp 识图后将文字描述交回 Pro 会话。
DeepSeek Harness 图像分析插件,支持 8 种模式(OCR/图表/UI评审/代码生成等),零配置免费视觉端点,兼容任意视觉 API。
为无视觉的文本模型提供可切换的 VLM 识别旁路,自动拦截图片请求并改写为文字指引,界面与历史保留原图。