dsh-doc-reader
在终端中运行以下命令:
dsh plugin install reg4916/dsh-doc-reader
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install reg4916/dsh-doc-reader,或从内置插件市场安装源码仓库 https://github.com/reg4916/dsh-doc-reader 对应的 dsh-doc-reader 包。
插件介绍
在 DeepSeek Harness 里,内置 read 往往只能拿到原始字节或纯文本,web_fetch 又拒收 PDF 等二进制类型。结果是 Agent 经常在会话里临时 curl 下载、pip 安装 pypdf 或同类库,既慢又脏。dsh-doc-reader 用五个类型明确的工具把这条缝补上:按页读 PDF、按表读表格、读幻灯片与 Word,并在需要时用本地 OCR 处理扫描件和截图。
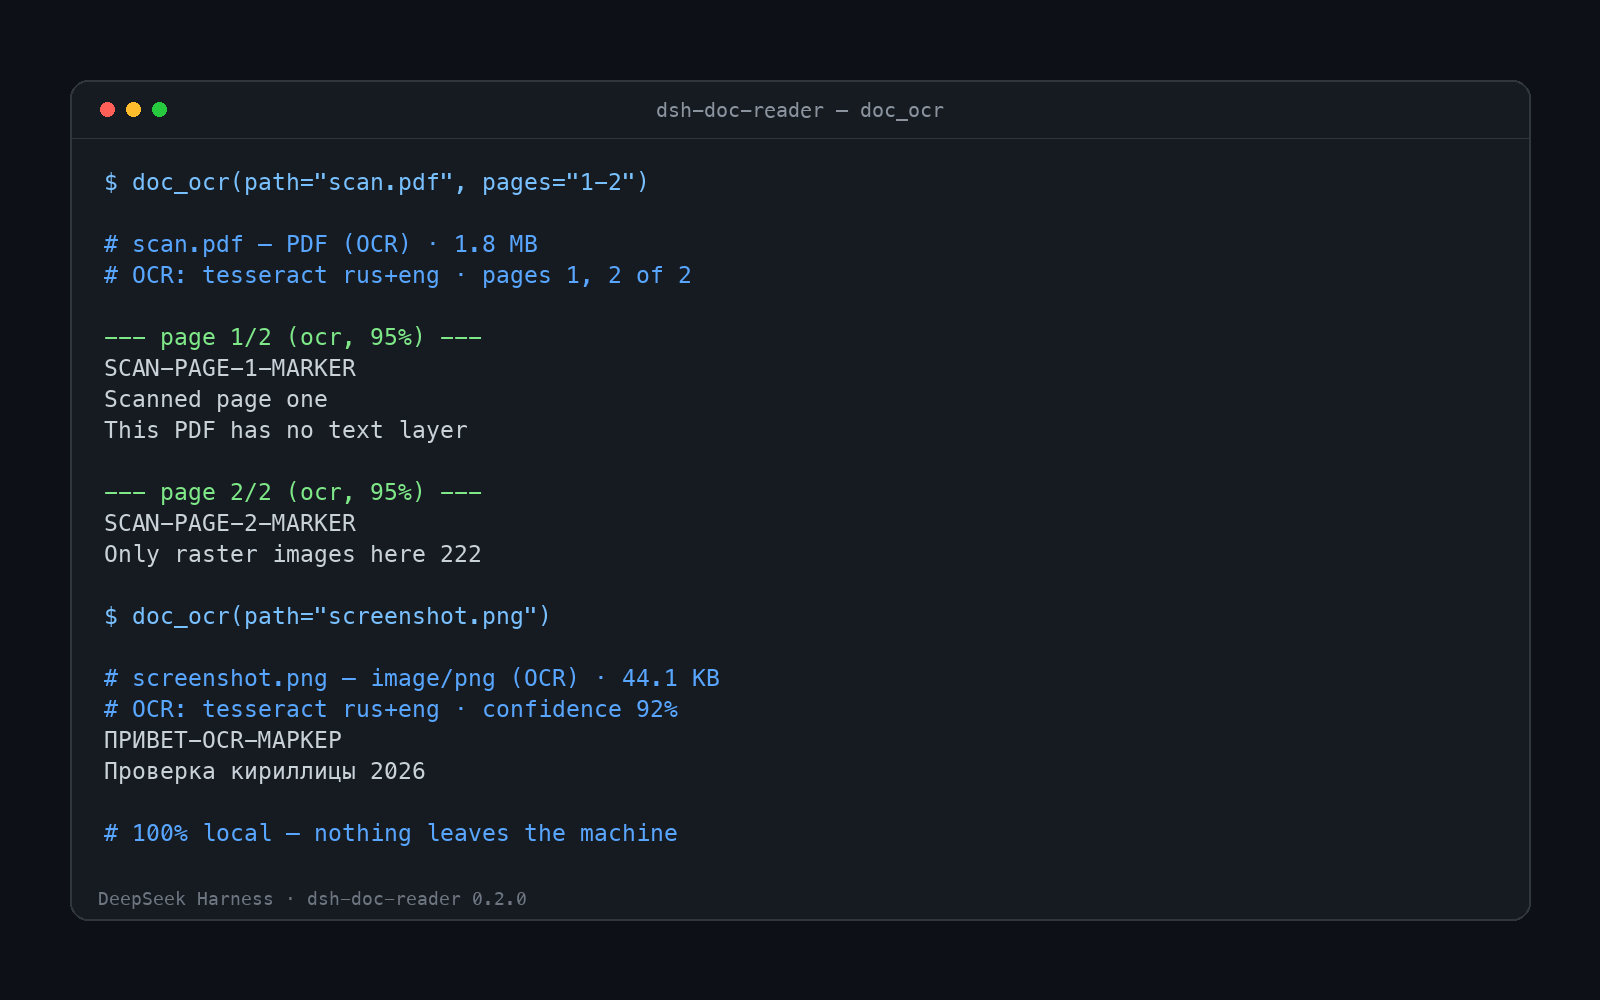
core 能力围绕「读得准、读得省」展开。doc_read 靠魔数自动识别 PDF、DOCX、XLSX、PPTX 与 TXT/MD/CSV/HTML;pdf_read 与 xlsx_read 提供更细的分页、分 sheet 控制;doc_meta 适合大文件先探路再按需读取;doc_ocr 用 tesseract.js 在本地跑识别,不依赖系统 OCR 二进制,也支持 CCITT/JBIG2 等传真式扫描页。本地路径与 http(s) URL 均可,输出有 maxChars 上限,并对内网地址拒绝访问以降低 SSRF 风险。
适合在 agent-workflow 里频繁处理合同、报表、课件或扫描 PDF 的开发者与自动化场景。先 doc_meta 再定点读页/表,扫描页走 doc_ocr,比让模型自己装包或猜格式可靠得多。
截图预览
使用场景
- Agent 需要按页摘录 PDF 合同或报告正文
- 表格与幻灯片要分 sheet/分页读取而非整文件灌入
- 扫描 PDF 或截图需本地 OCR 转成可检索文本
适合人员
- 在 DSH 工作流里频繁处理 Office 与 PDF 的开发者
- 希望避免会话内临时 curl/pip 装解析库的 Agent 编排者
- 需要扫描件、传真式 PDF 本地识别的合规或内网场景
相关插件

在 Agent 里用一句话生成可交付设计:可点击原型、可编辑幻灯片、发布动效、信息图与小红书图文,适配 Cursor 等 Skills 环境。

智能体技能:模型只写 Markdown 草稿,CLI 快速生成可离线阅读的单文件 HTML 页(含图表与表格),输出约为直接手写 HTML 的八分之一。
基于十二本经典工程书籍,以六大衰退风险维度评审代码,输出可溯源的结构化诊断与健康分。

让 AI 编程代理更可信:编辑前对齐真实基线、完成时附验证证据,减少返工与不安全变更。