dsh-deep-reading-wl
在终端中运行以下命令:
dsh plugin install SongFengManZhu/dsh-deep-reading-wl
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install SongFengManZhu/dsh-deep-reading-wl 安装本插件(源码:https://github.com/SongFengManZhu/dsh-deep-reading-wl)。
插件介绍
扫描版教材 PDF 没有文字层,普通阅读器几乎读不出字;真要写能交付的读书心得,又不可能从第一页硬啃到最后一页。这个工作流插件把「从电子书到心得骨架」做成可重复的流水线:原料是 PDF,产物是让你先知道该读哪几节、哪几页、哪些行值得亲读的骨架,而不是替你读书。
核心是四个衔接工具。OCR 用 RapidOCR 把扫描页变成带页标记的文本;scan 在开读前给出章节骨架和「哪几页有表」的位置索引;map 按公式与定义、推导的密度把每章译成先读、略读、必回原图看表的动作;digest 在 OCR 文本里分诊正文与表格碎片,压缩成更短但仍接近原文的精读稿。它刻意不修 OCR 错字、不还原表格行列、也不替你做「哪一节是立论核心」的判断——那些留给领域知识与翻原图。
适合需要啃扫描版专业书、想系统写读书心得的学生与自学者,以及愿意按页区间、按章迭代处理大部头教材的人。已在多本理工类教材上做过试点(章节识别、表格页定位、OCR 吞吐等),边界写得很清楚:它是导航与压缩,不是代读与摘要机。
使用场景
- 手头是扫描版专业教材,需要先摸清章节结构和该精读哪几节
- 写读书心得前想按页区间 OCR 并压缩成更短的原文稿
- 章节里表格多,需要知道哪几页有表并回原图对照行列
适合人员
- 需要系统啃扫描版理工教材的学生
- 写课程或自学读书心得、又不想从第一页盲读的人
- 愿意按章或按页迭代处理大部头 PDF 的自学者
相关插件

huashu-design
alchaincyf/huashu-design
在 Agent 里用一句话生成可交付设计:可点击原型、可编辑幻灯片、发布动效、信息图与小红书图文,适配 Cursor 等 Skills 环境。
工作流
2026.11.06
★ 28797

answer-me-with-html
QingYunA/answer-me-with-html
智能体技能:模型只写 Markdown 草稿,CLI 快速生成可离线阅读的单文件 HTML 页(含图表与表格),输出约为直接手写 HTML 的八分之一。
工作流
2026.10.19
★ 3696
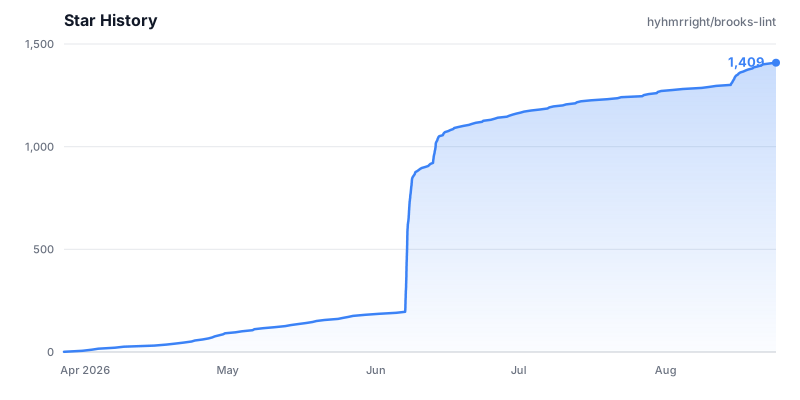
brooks-lint
hyhmrright/brooks-lint
基于十二本经典工程书籍,以六大衰退风险维度评审代码,输出可溯源的结构化诊断与健康分。
工作流
2026.10.29
★ 1550

Aegis
GanyuanRan/Aegis
让 AI 编程代理更可信:编辑前对齐真实基线、完成时附验证证据,减少返工与不安全变更。
工作流
2026.08.26
★ 1133