attention-scheduler
在终端中运行以下命令:
dsh plugin install Kfytm/attention-scheduler
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 终端执行 dsh plugin install Kfytm/attention-scheduler 安装本插件,源码见 https://github.com/Kfytm/attention-scheduler,安装后重启当前 profile 即可使用。
插件介绍
长对话里,过期结论、无关片段和被误当成事实的旧话会悄悄挤进当前推理,这就是历史污染,也是上下文幻觉的常见根因。attention-scheduler 把该不该检索、召回多少、保留什么、丢弃什么、写回什么写成一套可复用、可审计、可复现的注意力与记忆使用规范,让模型在这些环节上有稳定的行为依据,而不是凭感觉拼上下文。
技能覆盖检索四级触发与冲突优先级、跨会话检索约束、注意力预算与压缩摘要六要素,并区分 L0 骨架常驻与 L1 动态召回的 token 成本归属;记忆注入侧规定召回数与注入数、注入预算及超限淘汰,写回则有白名单与黑名单、版本链 superseded 等纪律。仓库还提供从会话日志实测固定开销与 L0/L1 成本的脚本,以及配置落点对照,方便团队把规则写进提示词、数字落到配置。
未接入 MemOS 等长期记忆插件时,检索触发、召回条数与注入预算等条款没有检索对象,会空转但不报错;注意力预算、保留优先级、压缩六要素与写回白名单仍会生效,可先立规矩,接上记忆库后整套能力即可对齐。适合会话很长、历史挤占上下文、回复常被旧信息带偏的个人或团队,以及希望统一检索与记忆使用纪律的 Harness 用户。
使用场景
- 多轮长会话中历史挤占上下文,回复常被过期结论带偏
- 希望统一团队对检索、召回、保留与写回的使用纪律
- 需要区分 L0 常驻骨架与 L1 动态召回的 token 成本并实测开销
适合人员
- DeepSeek Harness 上经常跑长会话的开发者
- 希望降低上下文幻觉、规范记忆注入的个人用户
- 计划或已接入 MemOS 等记忆插件的工作流团队
相关插件

智能体技能:模型只写 Markdown 草稿,CLI 快速生成可离线阅读的单文件 HTML 页(含图表与表格),输出约为直接手写 HTML 的八分之一。
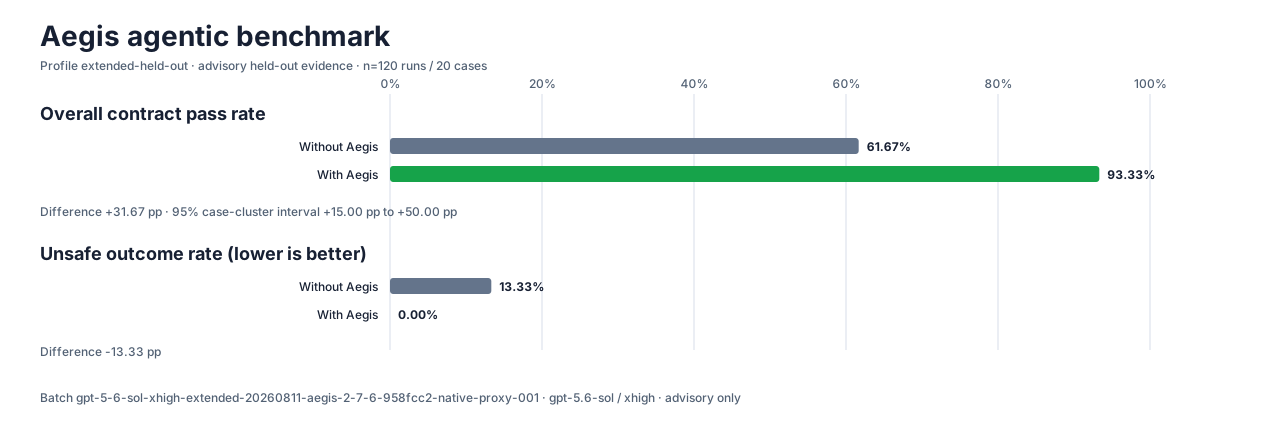
让 AI 编程代理更可信:编辑前对齐真实基线、完成时附验证证据,减少返工与不安全变更。
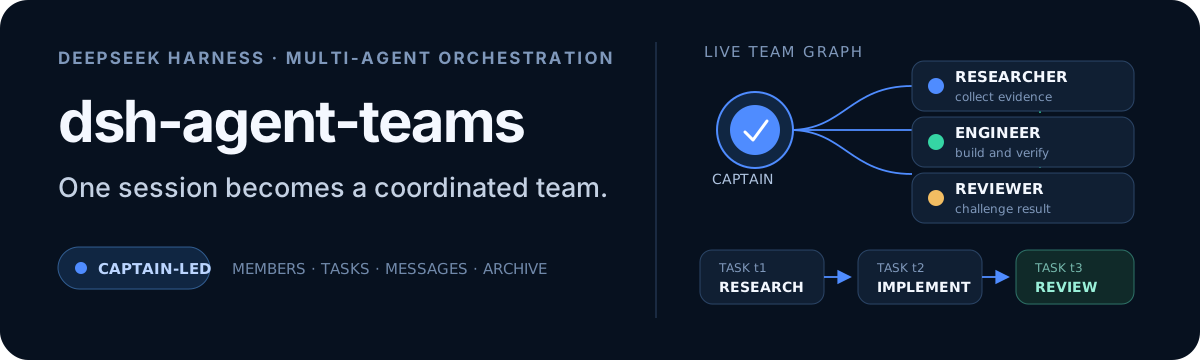
将 DeepSeek Harness 会话变为队长,创建持久子代理团队,将目标拆分为依赖感知任务,并通过直接消息与 Web UI 协调执行。
为编码智能体赋予设计判断力,让 Claude Code、Cursor 等 70+ 智能体直接在终端生成与迭代高质量 UI、演示文稿和图形。