dsh-multi-model-orchestrator
在终端中运行以下命令:
dsh plugin install Bazley13/dsh-multi-model-orchestrator
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 终端中执行安装命令即可启用该插件,源码地址为 https://github.com/Bazley13/dsh-multi-model-orchestrator 。
插件介绍
当一次复杂任务同时需要深度推理、代码生成和大量模板化输出时,把所有工作压在单一模型上既不经济也不高效。dsh-multi-model-orchestrator 让 dsh 的主模型充当多模型主脑:它自动将复杂任务拆解为子任务,根据你在配置中为每条路由标注的强项与弱项,把每个子任务分派到最合适的模型路由上(GLM、Kimi、Qwen 或任意 OpenAI 兼容接口),在一次对话中并行执行后汇总结果。
除了分派本身,插件还提供按模型维度的 token 用量追踪——输入、输出、缓存读写 token 与请求次数按 provider/model 累计,随时可查。你只需在 settings.yaml 中配置好路由与模型备注,主脑即可在后续对话中自主完成拆解、分派、汇总的完整流程,无需反复提示。
它适合已在 dsh 中配置了两条以上 OpenAI 兼容路由、希望一次请求就让不同模型各展所长、同时掌控每条路由成本的开发者。插件不修改 harness 内部逻辑,所有路由与白名单均为普通配置项,卸载即恢复原状。
使用场景
- 复杂任务自动拆解为子任务并分派到最合适的模型路由并行处理
- 深度推理分派给强模型、模板化高量工作分派给快速模型
- 按 provider/model 维度查看 token 消耗与请求次数以优化成本
适合人员
- 已配置两条以上 OpenAI 兼容路由的 dsh 用户
- 希望一次提示就让多个模型各展所长的开发者
- 需要精细掌控每条模型路由成本的团队
相关插件
DSH 服务化侧边栏框架,提供文件工作台、内嵌浏览器、真实终端、Git 面板等完整工作台,并开放服务供插件扩展。
美观实用的 Claude Code 风格 TUI 插件:像素鲸鱼顶栏、流光大字、实时状态行、思考流式展开、时间回溯、上下文进度条与 TPS 仪表,零核心改动。
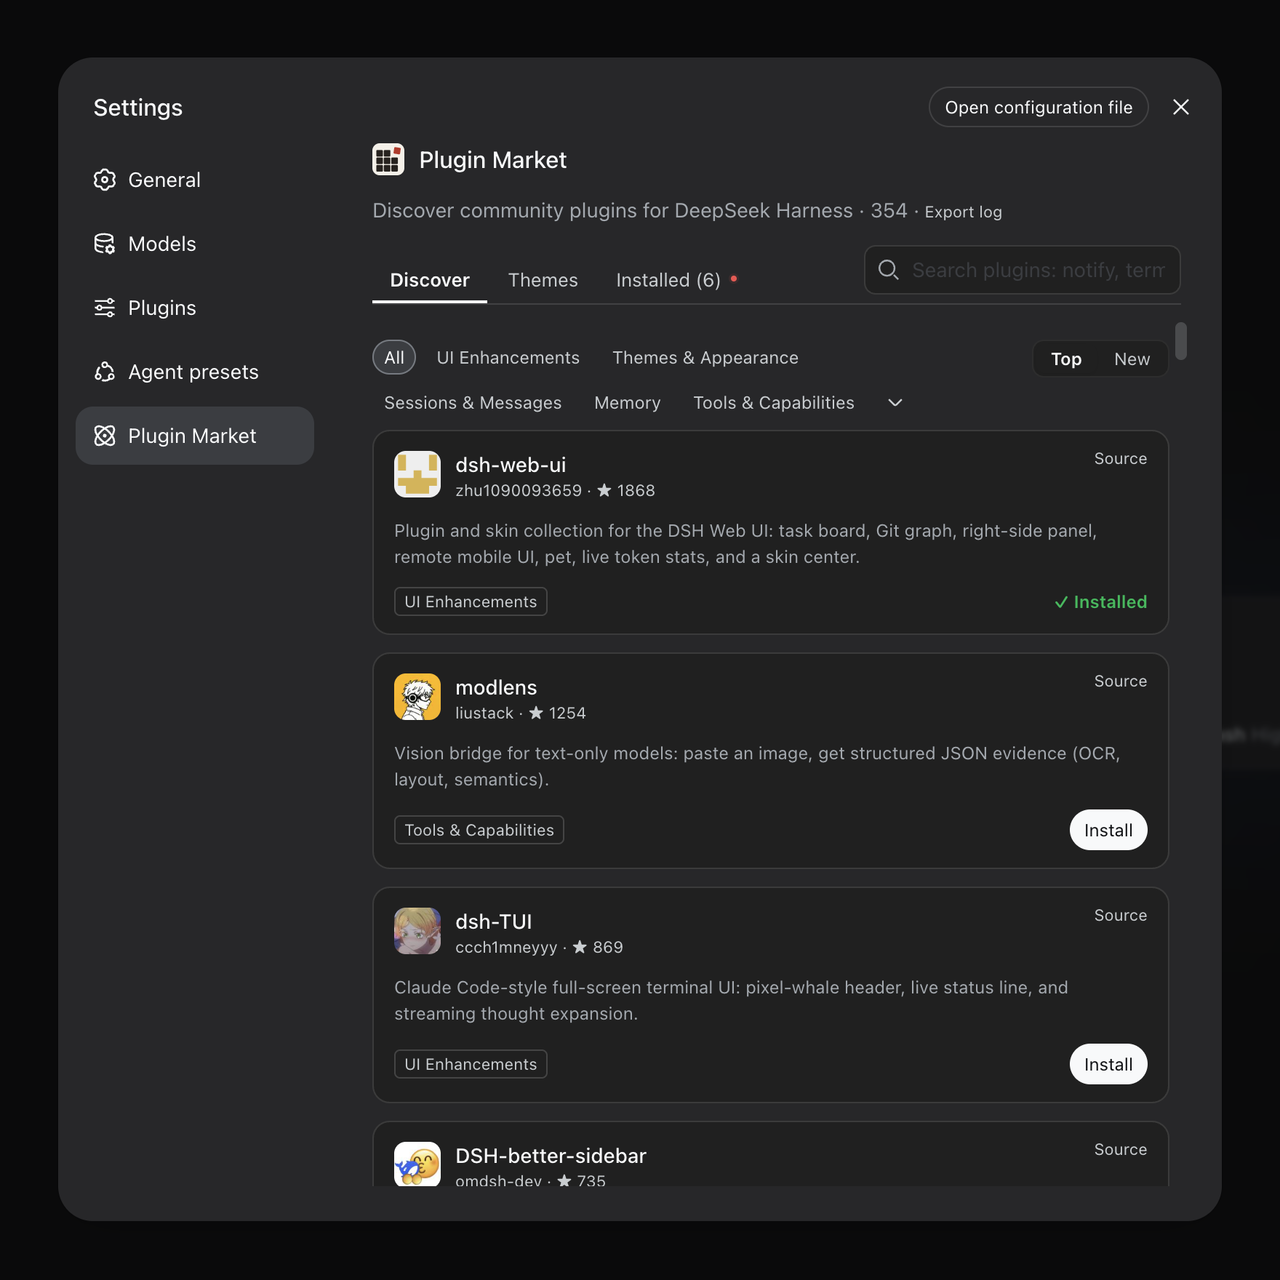
DeepSeek Harness 插件市场:浏览/搜索/一键安装社区插件与主题,支持更新、备份、热禁用、诊断与AI修复。
DSH Web 界面右下角常驻小鲸鱼余额挂件,自动显示 DeepSeek 余额、今日已用与每轮对话消耗,支持拖拽吸附与音效。