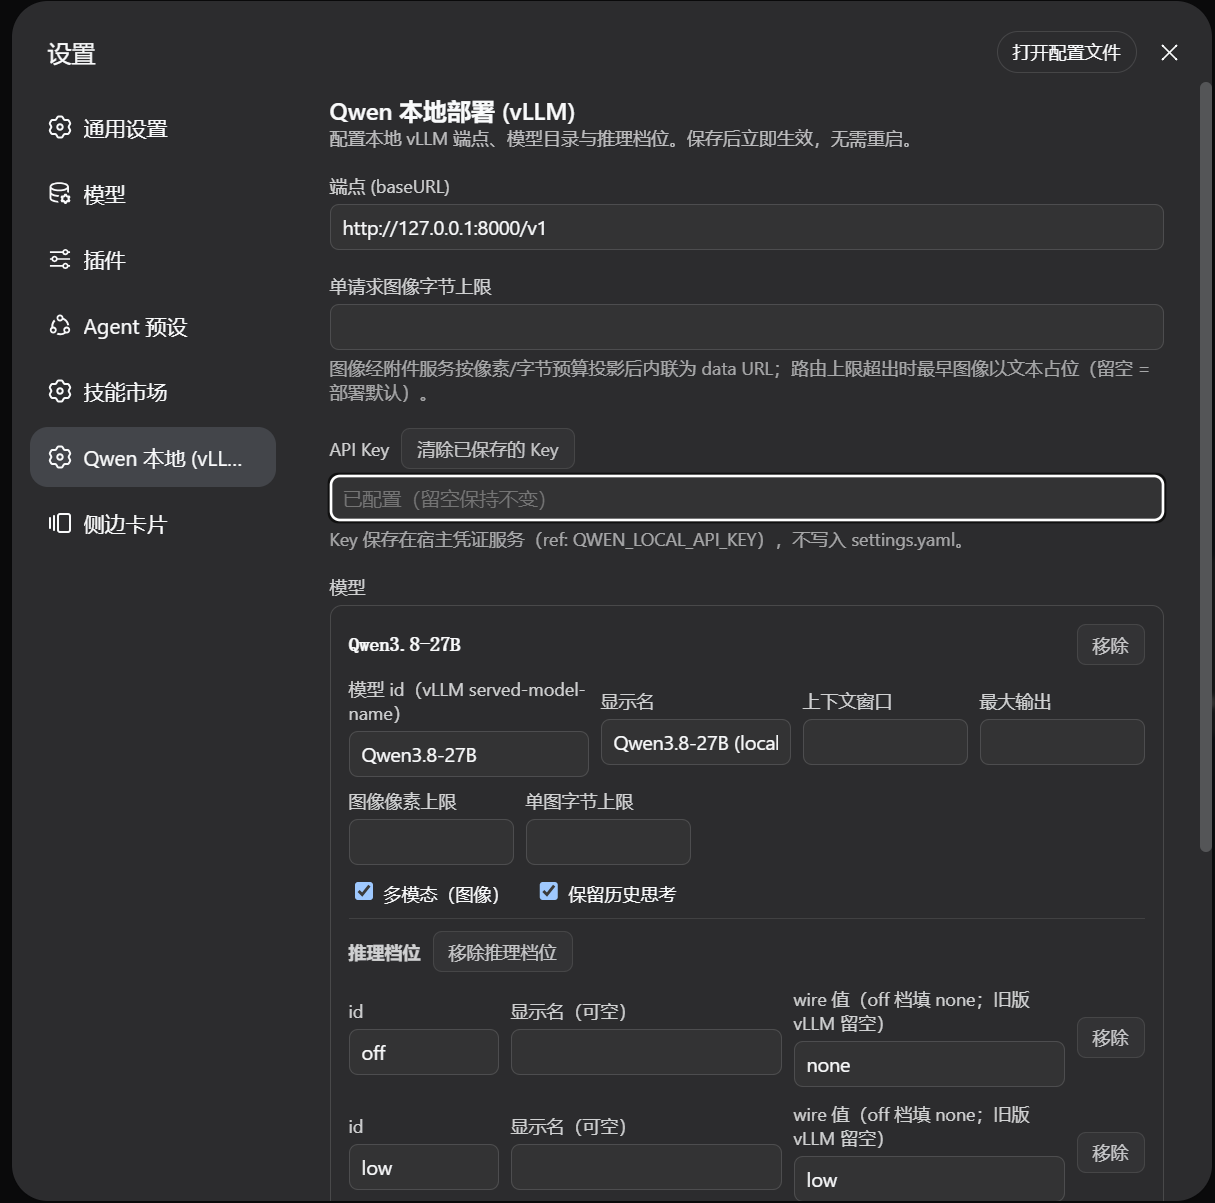
dsh-llm-qwen-local
在终端中运行以下命令:
dsh plugin install starefinger/dsh-llm-qwen-local
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在终端执行 dsh plugin install starefinger/dsh-llm-qwen-local 即可安装,插件源码位于 https://github.com/starefinger/dsh-llm-qwen-local 。
插件介绍
你本地用 vLLM 部署了一台 Qwen3.8-27B,想把它接入 DeepSeek Harness 统一调度和 Web UI 操作,但 DSH 原生适配器并不覆盖 Qwen 系列。dsh-llm-qwen-local 就是为此而生的 LLM 适配器插件:它将 DSH 的请求翻译为 vLLM 背后的 OpenAI 兼容 /v1/chat/completions 端点,让你在 DSH 里像调用自家托管模型一样顺畅地使用本地 Qwen。
插件把两个常见的本地部署差异做成一等公民配置。逐模型的多模态开关如实声明该端点是否具备视觉推理能力,避免图文混排请求时静默降级为文本占位符或在图片消息落盘后中途报错。推理等级的每个档位——显示名称、wire 拼写、默认值以及关闭态的表达方式——全部来自配置文件,匹配任意 vLLM 构建所接受的词汇表,无需改代码。
适合已经在本地或内网用 vLLM 跑了 Qwen 模型尤其是 Qwen3.8-27B 级别,希望把它纳入 DeepSeek Harness 工作流做日常开发、工具调用和图文理解的用户。无需公有云 API Key,无需 DashScope 或 Qwen Cloud,只需一个 vLLM 实例和 DSH 0.1.1-rc.2 及以上版本即可开工。
截图预览
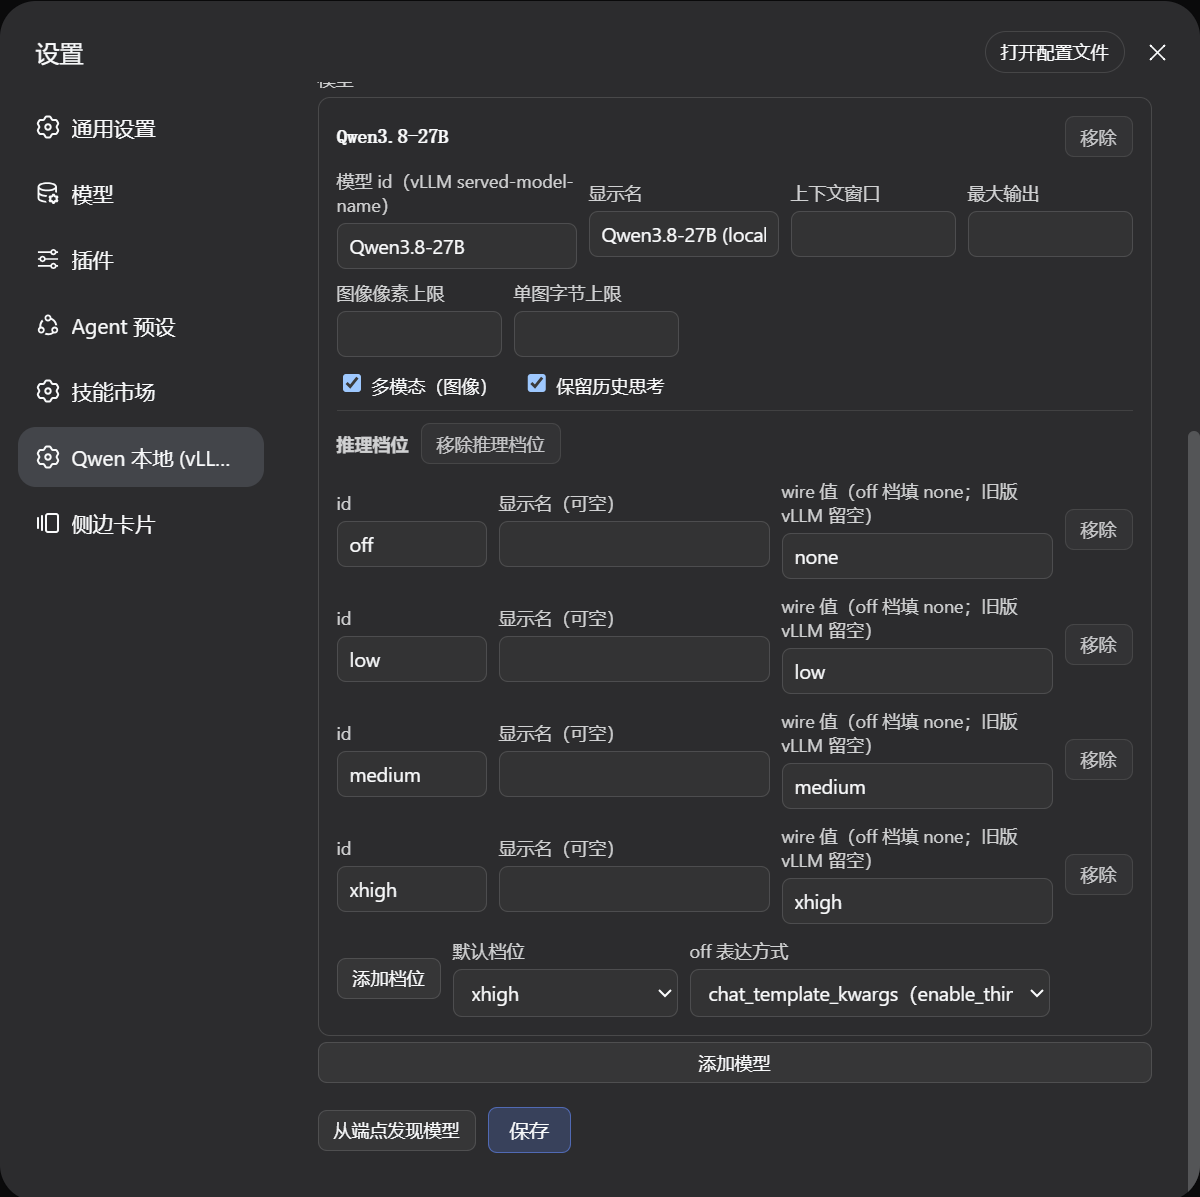
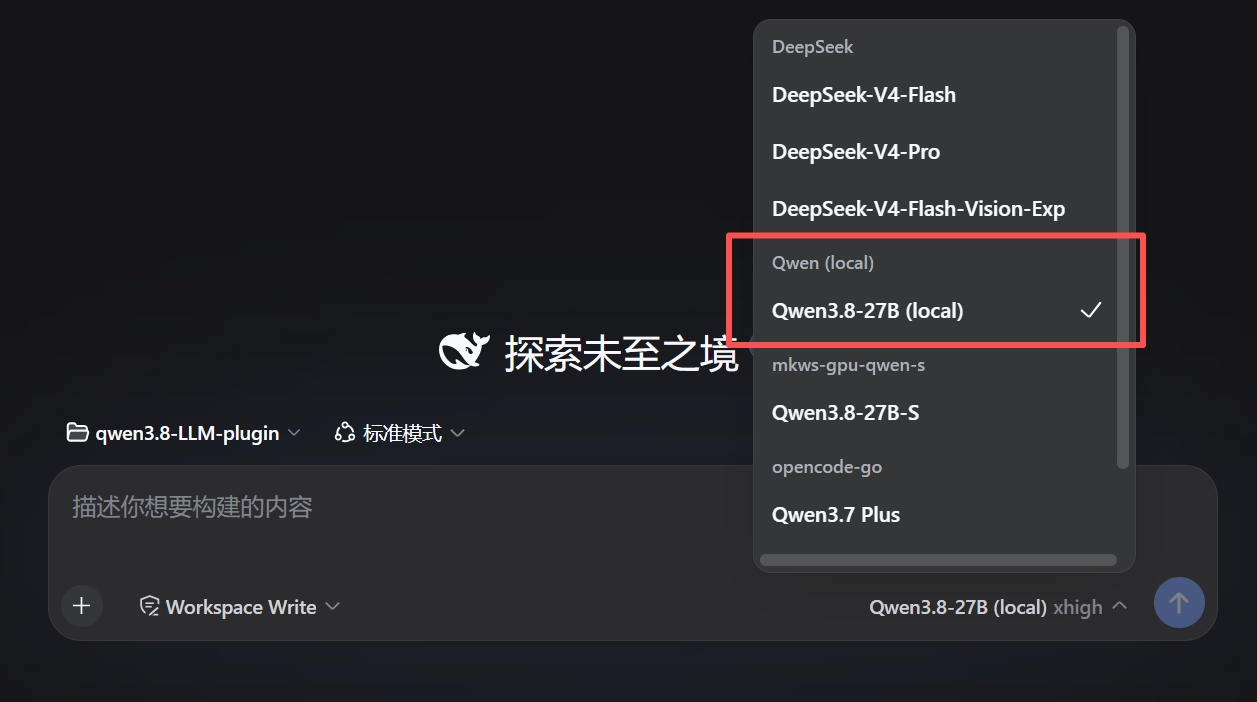
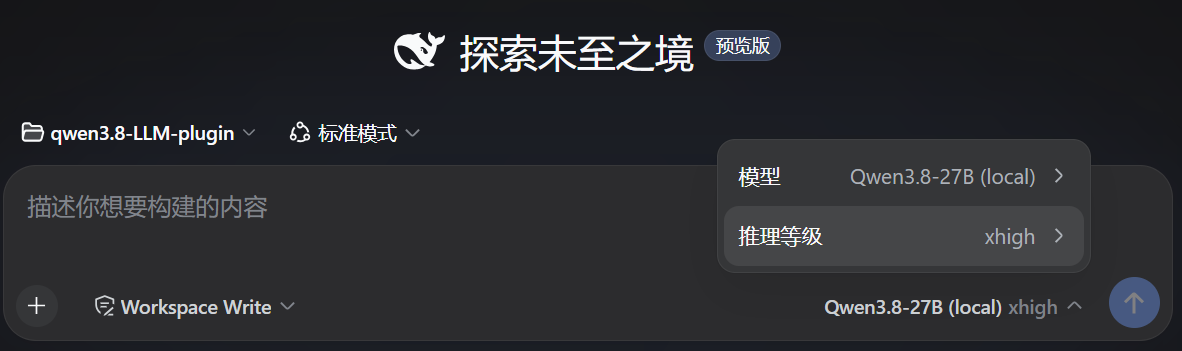
使用场景
- 将本地 vLLM 部署的 Qwen 模型接入 DSH 统一 CLI 与 Web UI 工作流
- 通过逐模型多模态开关控制图文混排请求的视觉推理行为
- 按 vLLM 构建实际支持的词汇表配置推理等级档位与默认值
适合人员
- 已在本地或内网用 vLLM 部署 Qwen 系列模型的开发者
- 希望将自托管模型纳入 DeepSeek Harness 统一调度的用户
- 需要多模态图文理解或工具调用场景的独立开发者
相关插件
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。

ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。

为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。

为 DeepSeek Harness 文本模型赋予视觉能力,支持图像问答、长截图 OCR、UI 重建与 GUI 视觉任务。