dsh-arxiv-ml-search
在终端中运行以下命令:
dsh plugin install babkiny/dsh-arxiv-ml-search
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install babkiny/dsh-arxiv-ml-search 即可安装,插件开源地址为 https://github.com/babkiny/dsh-arxiv-ml-search
插件介绍
大语言模型在回答机器学习问题时,常凭训练期内化的记忆给出结论,即使那些结论并不准确或已经过时。dsh-arxiv-ml-search 让 Agent 直接检索 arXiv 上的机器学习论文,用已发表的摘要和元数据核实每一个论点,而非依赖自身参数化记忆。
插件提供两个工具:arxiv_search 支持关键词、作者、分类、日期范围、排序与分页,返回截断摘要以控制 token 开销;arxiv_get 可获取指定论文的完整元数据与完整摘要,并支持分段读取长文本。配套的 Skill 文件将"重述论点、正交查询、精读候选、给出带 ID 的结论"固化为标准流程,要求模型对模糊匹配明确标注,对缺失证据诚实说明。
适合正在研究强化学习、RLHF、校准、奖励塑形等议题,且需要引用具体 arXiv 论文 ID 作为依据的工程师与研究人员。无需 Python 环境或构建步骤,只需一个 profile 条目即可让工具常驻工具集,Agent 在回答任何 ML 工程问题时都会自动加载查证流程。
使用场景
- 回答强化学习或 RLHF 工程问题时,Agent 自动检索 arXiv 并引用具体论文 ID 作为依据
- 对 Agent 给出的技术结论进行文献查证,明确标注精确匹配与近似匹配,避免凭记忆断言
- 无需 Python 环境或构建步骤,一个 profile 条目即可让 Agent 获得 arXiv 检索与分段读取能力
适合人员
- 需要以 arXiv 论文 ID 作为研究引用依据的 ML 工程师
- 正在研究 RLHF、奖励塑形、校准等前沿方向并需反复查证文献的研究人员
- 希望 Agent 回答时查阅已发表文献而非依赖参数化记忆的技术团队
相关插件
DSH-better-sidebar
omdsh-dev/DSH-better-sidebar
DSH 服务化侧边栏框架,提供文件工作台、内嵌浏览器、真实终端、Git 面板等完整工作台,并开放服务供插件扩展。
客户端
2026.08.27
★ 2968
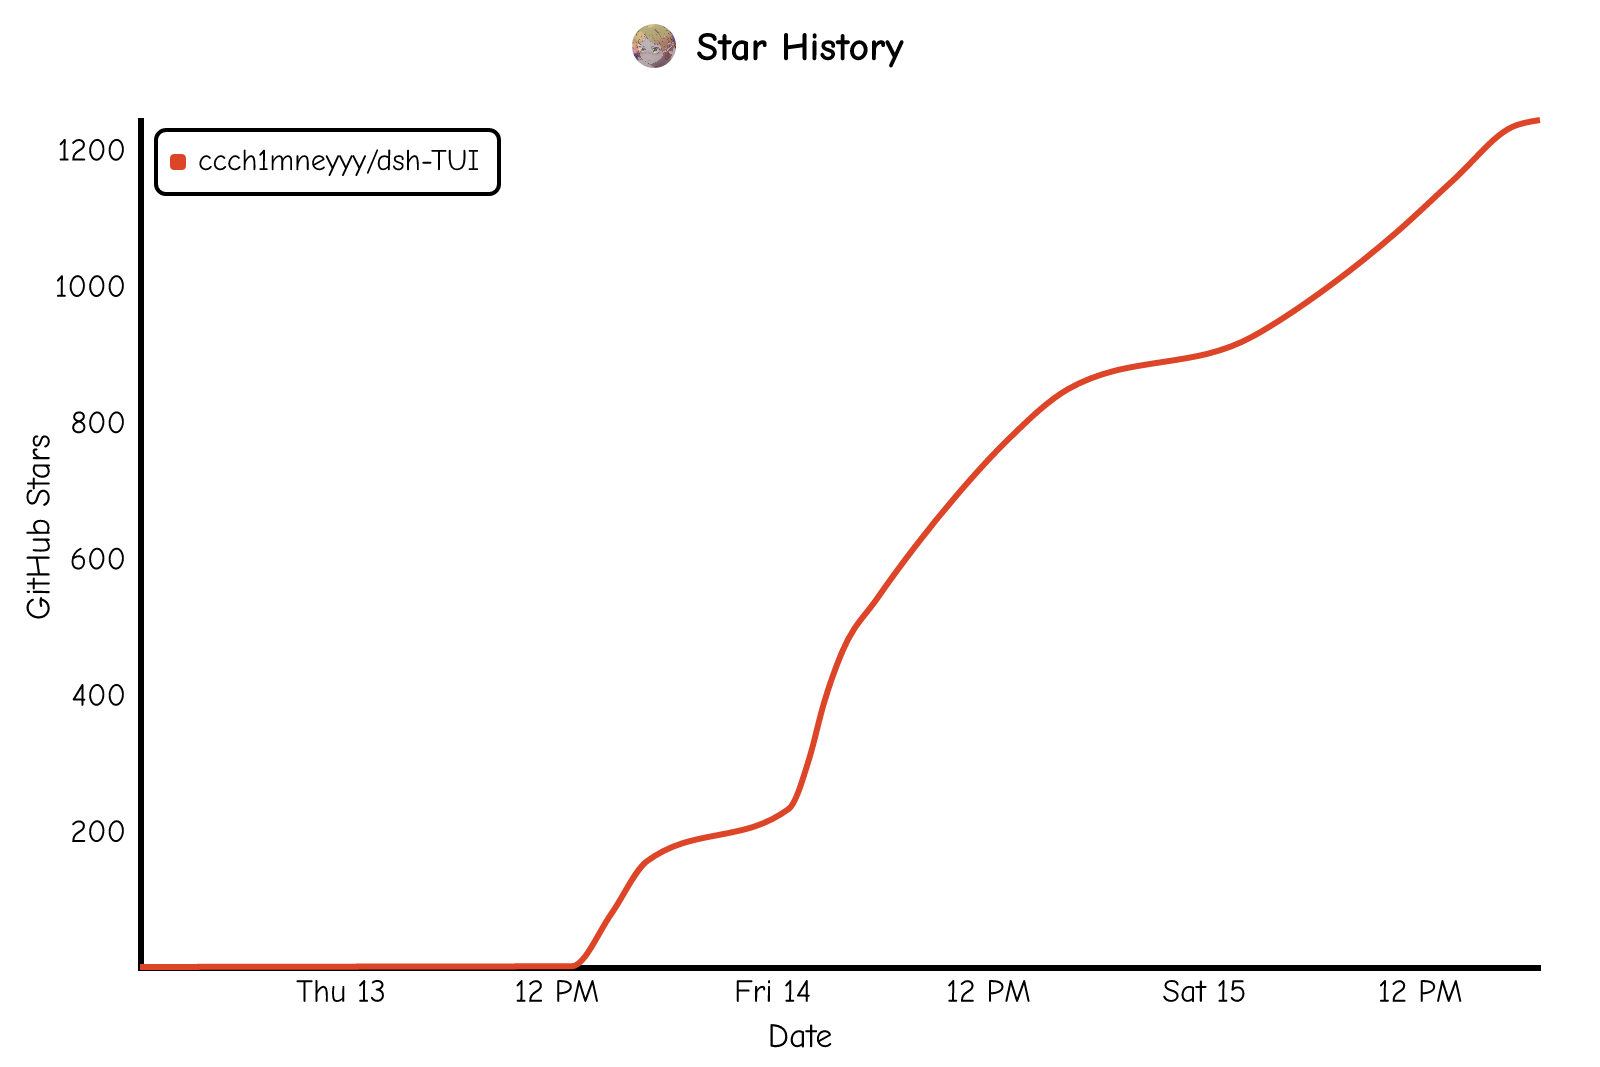
dsh-TUI
ccch1mneyyy/dsh-TUI
美观实用的 Claude Code 风格 TUI 插件:像素鲸鱼顶栏、流光大字、实时状态行、思考流式展开、时间回溯、上下文进度条与 TPS 仪表,零核心改动。
客户端
2026.08.27
★ 2593
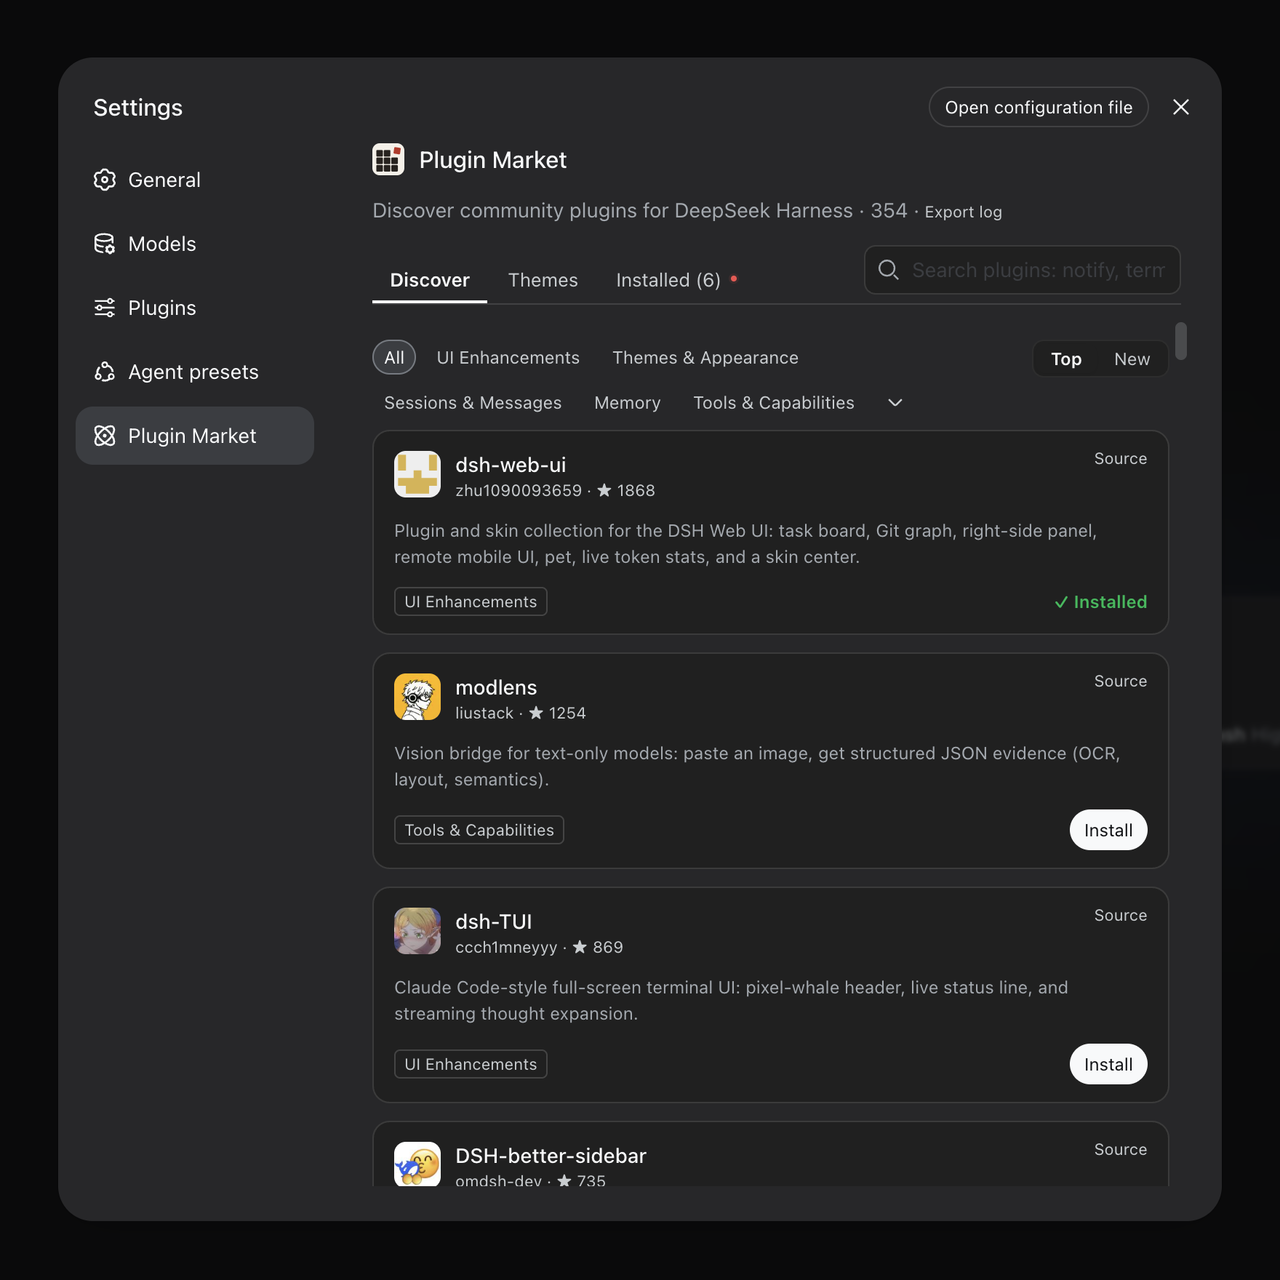
dsh-market
dsh-market/dsh-market
DeepSeek Harness 插件市场:浏览/搜索/一键安装社区插件与主题,支持更新、备份、热禁用、诊断与AI修复。
客户端
2026.08.27
★ 2503
DeepSeek-Balance-Whale-Widget
MeteorNOX/DeepSeek-Balance-Whale-Widget
DSH Web 界面右下角常驻小鲸鱼余额挂件,自动显示 DeepSeek 余额、今日已用与每轮对话消耗,支持拖拽吸附与音效。
客户端
2026.08.27
★ 1086