dsh-adaptive-effort
在终端中运行以下命令:
dsh plugin install imkingjh999/dsh-adaptive-effort
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 终端中运行 dsh plugin install imkingjh999/dsh-adaptive-effort 即可安装本插件,完整源码仓库地址为 https://github.com/imkingjh999/dsh-adaptive-effort 。
插件介绍
在 DSH 宿主里,reasoning_effort 是一个会话级旋钮——一旦设定,整轮对话都跑在同一档。结果就是:改个 typo 也烧 max 档的 token,写个复杂重构却只给 low 档思考深度。更棘手的是 GLM-5.3 这类强制思考模型只接受 low / high / max 三档,medium 直接报错、off 也走不通,手动切档既枯燥又容易忘。
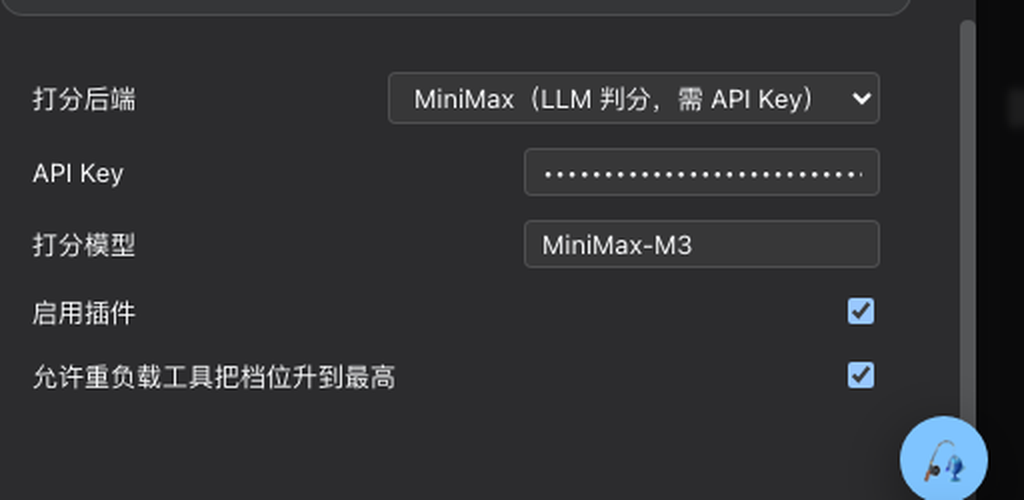
dsh-adaptive-effort 的思路是「逐轮打分、逐轮调度」。默认调用 MiniMax LLM 对每条用户消息做复杂度判分(思考关闭、低延迟),然后自动在 low / high / max 之间选档;手动选了固定档位时插件完全退场。打分后端也可切换为零依赖的启发式规则,适合离线或不想接 API 的场景。在强制思考模型上,插件会把手动 off 安全钳制为 low 并记日志,杜绝 API 报错。
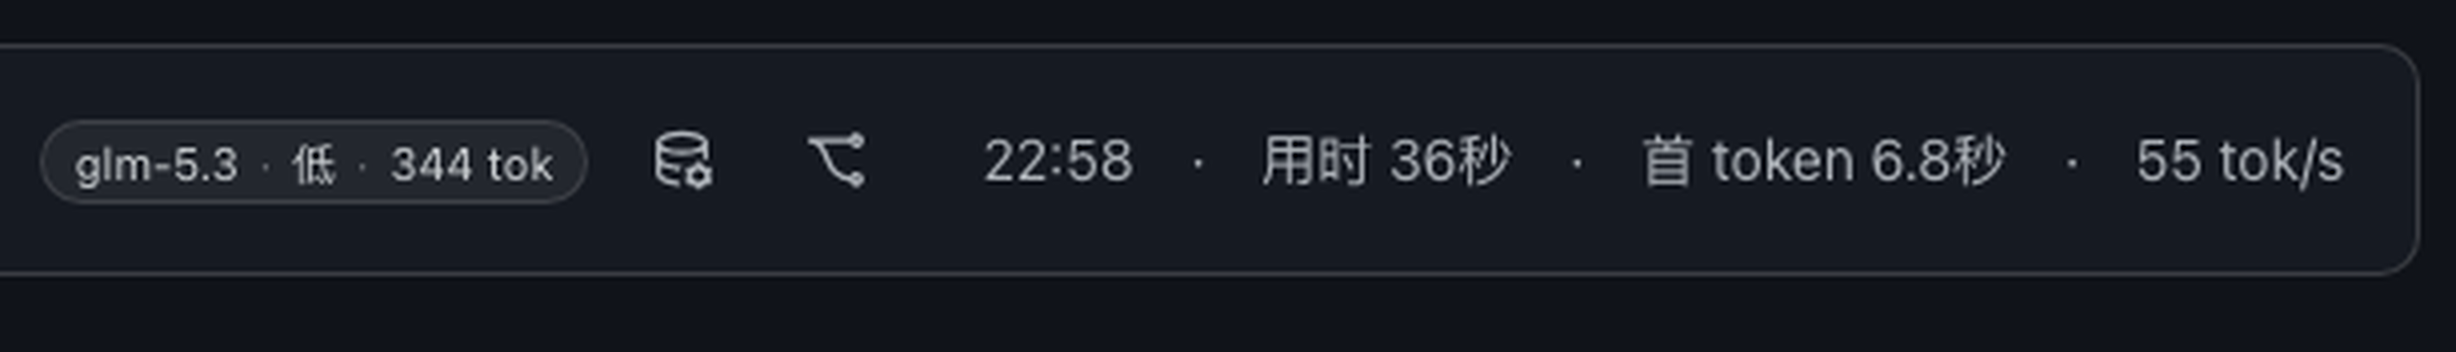
插件还带来一套轻量 token 账本:每次请求记录档位、打分来源、input/output tokens,报表可标记「low 档输出爆炸」(疑似低估)和「high/max 档输出极小」(疑似高估),给出降档节省估算。每条已定稿的 AI 回复末尾会挂一枚元数据徽标(模型·思考档位·输出 tokens),点击即可回滚到该回复,方便核验每条回复实际跑在哪一档。
适合在 DSH 里频繁切换轻量问答与深度推理的用户,尤其是使用 GLM-5.3 / GLM-4.7 等强制思考模型、又不想牺牲 token 效率的开发者。手动优先的设计意味着它不会「抢方向盘」——你只要点开模型弹窗的「自动」档,其余的交给它。
截图预览
使用场景
- 轻量问答与深度推理在同一会话中交替出现,希望逐轮自动匹配思考档位
- 使用 GLM-5.3 等强制思考模型,避免手动选 off/medium 触发 API 报错
- 核验每条 AI 回复实际跑在哪一档,并追踪分档 token 用量与降档节省空间
适合人员
- 在 DSH 里频繁切换轻量任务与深度推理、不想逐条手动切档的用户
- 使用 GLM-5.3 / GLM-4.7 等强制思考模型、需要安全钳制 off 档的开发者
- 关注推理成本、希望用小模型打分驱动 token 效率的预算敏感用户
相关插件
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。

ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。

为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。

为 DeepSeek Harness 文本模型赋予视觉能力,支持图像问答、长截图 OCR、UI 重建与 GUI 视觉任务。