dsh-memory-xfy
在终端中运行以下命令:
dsh plugin install xiaofeiyu39/dsh-memory-xfy
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install xiaofeiyu39/dsh-memory-xfy 安装本插件(源码:https://github.com/xiaofeiyu39/dsh-memory-xfy),装完后重启 DSH。
插件介绍
上下文窗口是工作台,不是仓库。当记忆体量涨到上下文的十倍、百倍,塞进每轮提示既不现实,还会打断 prefix cache、拖慢推理。dsh-memory-xfy 要解决的也不是「让模型记住更多」,而是让已有记忆能被稳定找到:以 Markdown 文件为唯一真源,SQLite 与 FTS 只做索引与检索,模型通过 mem_search、mem_pack 按需取片段,而不是每轮硬灌全文。
插件围绕「下次什么时候用得上」做六层划分(核心规则、文档结论、技能手册、工具资产、日记与复盘流水等),并在热区与冷区之间按时间窗口自动沉降——文件搬入 archived/ 仍可按层检索,冷区不会从搜索里消失。同一套 layers.json 驱动面板与命令行脚本:树形浏览、跨层搜索、编辑小节、热冷转区、片段存档、把流水里的好条目提到 docs。纯 Node 内置 SQLite(含 FTS5 trigram),无 native 编译、无 embedding 模型,检索走同步文件操作,毫秒级响应。
适合长期在 DSH 里积累项目规矩、技能文档、日记与复盘,又希望上下文保持干净、只在任务相关时拉出记忆片段的开发者与重度 Harness 用户。首次初始化会生成各层示例内容且不覆盖已有文件;若面板为空,多半是 layers.json 指向的目录尚无 .md,补齐后刷新索引即可。
使用场景
- 项目规矩与技能文档越积越多,却不想每轮对话都塞满上下文
- 需要在日记、复盘与结论之间跨层搜事实词,而不是靠模型凭印象回忆
- 流水类记忆按天/周自动沉冷,但偶尔仍要从冷区把旧片段捞出来
适合人员
- 长期在 DeepSeek Harness 中工作、记忆以 Markdown 为主的重度用户
- 希望文件自持、索引可重建、不依赖 embedding 模型的开发者
- 需要 mem_pack 简报控制字数、又要有面板管热冷的日常使用者
相关插件

为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
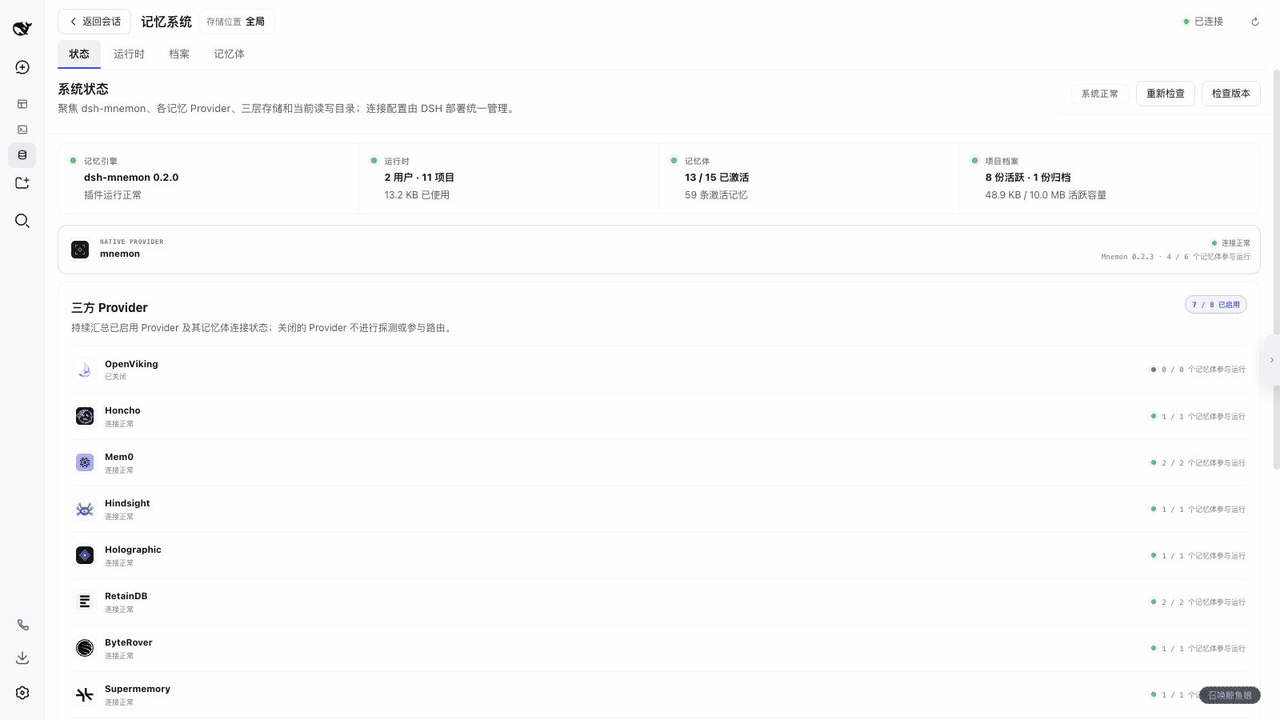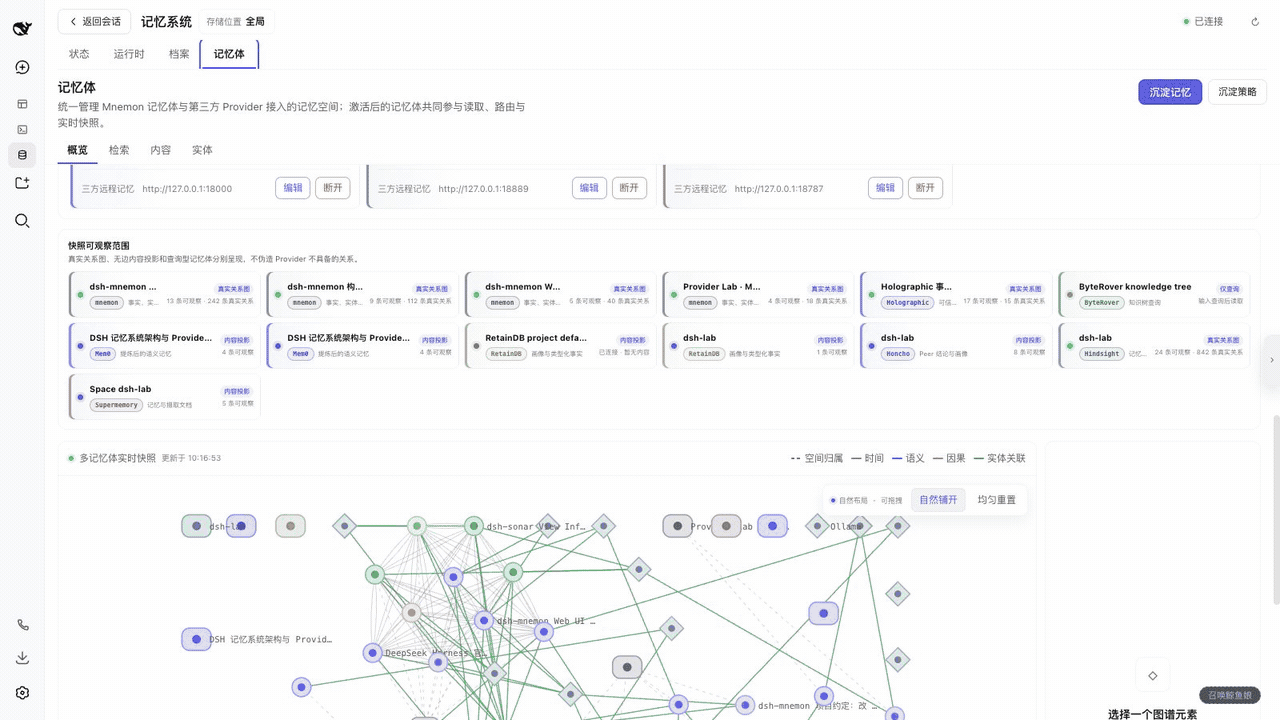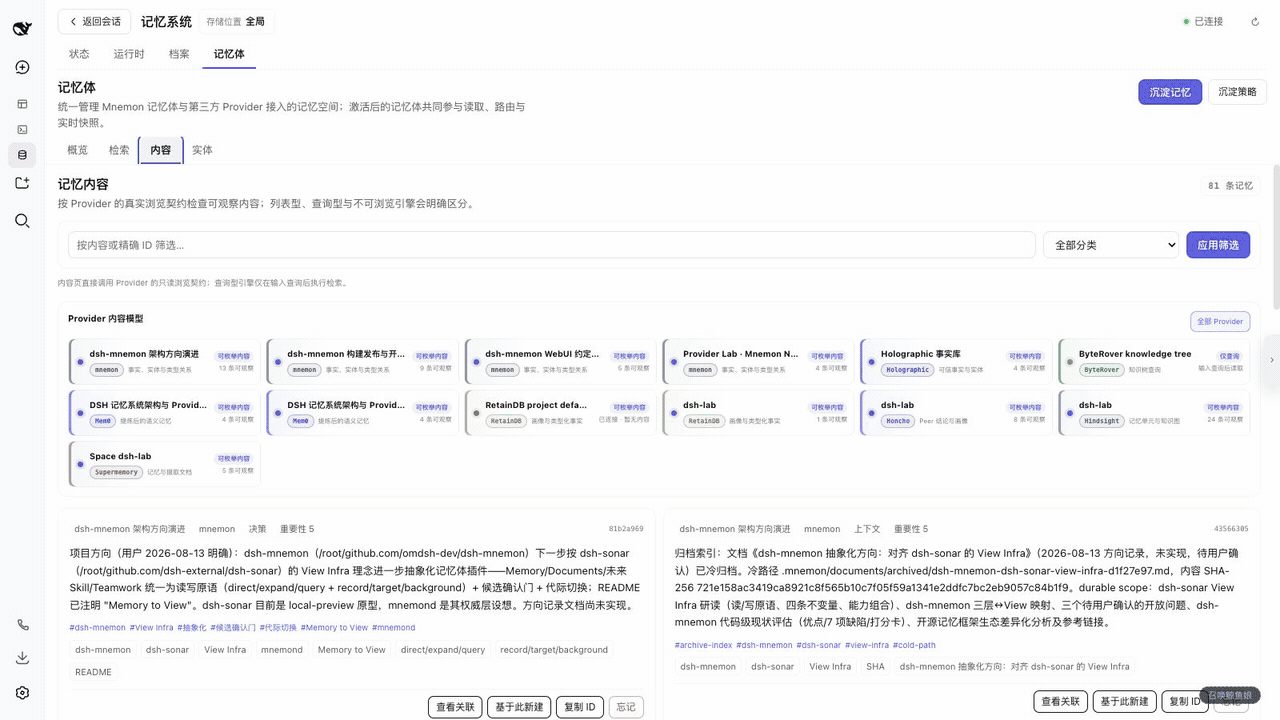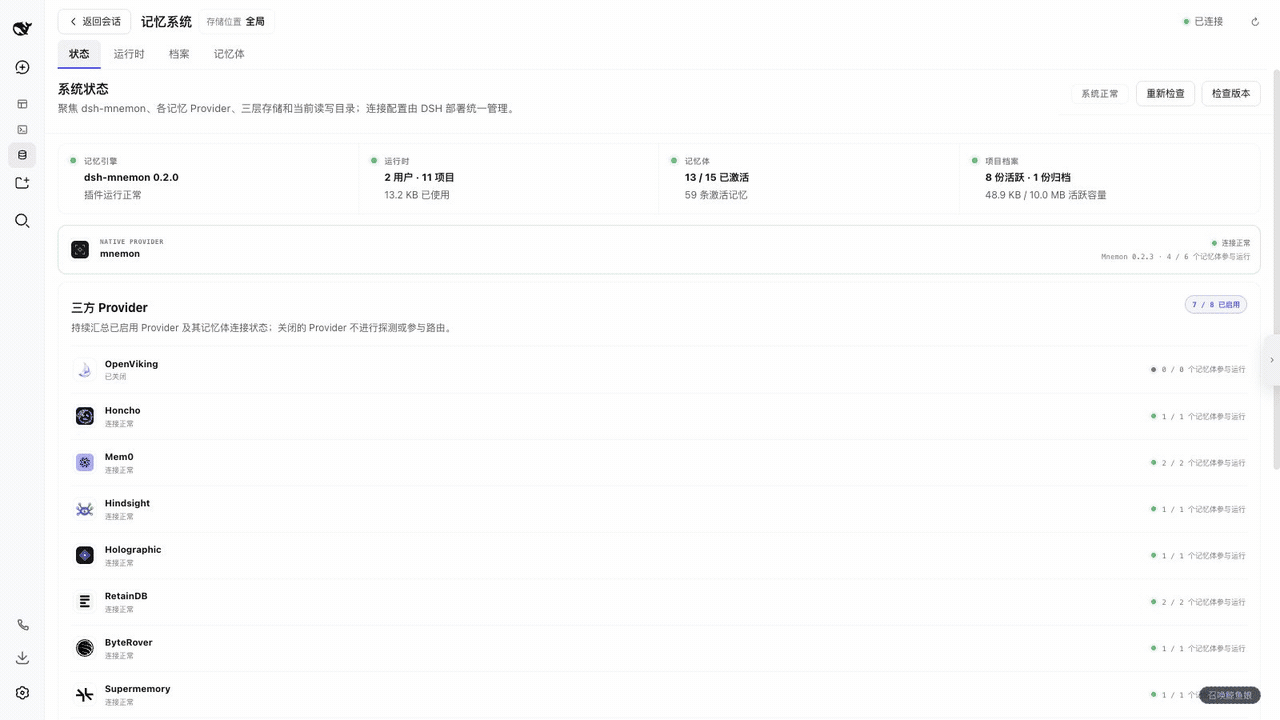
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。