dsh-memory-preset
在终端中运行以下命令:
dsh plugin install Wuming1101/dsh-memory-preset
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install Wuming1101/dsh-memory-preset,或从 https://github.com/Wuming1101/dsh-memory-preset 获取源码后按 README 与 dsh-memory-store、dsh-context-window 一并加入 profile bundle。
插件介绍
长期陪聊或反复练一件事后,完整对话上下文会越撑越大:费 token、也容易把模型注意力拖散。dsh-memory-preset 提供一套「记忆优先」的 Agent 预设,把策略写进 persona 与预设层:模型这一轮主要看见最近一轮的原文,更早的轮次交给折叠机制处理,需要旧事时先走记忆检索再作答。
它在出厂「记忆」预设上做覆盖,工具集刻意做减法——保留读写文件、搜文件、技能、网页搜索与抓取、向用户提问和交付等日常能力,但不含 shell、任务调度、目标规划、子代理与工作流等更重型的编排。记忆库本身不内置,需另装 dsh-memory-store;轮次折叠依赖 dsh-context-window,三者一起挂上并在会话里选中「记忆优先」即可使用。
折叠发生在模型侧:事件日志和客户端聊天记录通常仍在,只是本轮请求里看不到旧原文。记忆为空时仍会自然聊天,不会向用户科普机制;想长期记住的内容要显式写入记忆库,它不会替你自动总结全部历史。检索结果来自本机库,会进入模型请求,写错需人工纠正。
适合把 DSH 当长期对话伙伴、语言或情境陪练的人;不太适合必须盯紧整段代码或长文档上下文的开发会话。接受「最近原文 + 记忆检索」带来的更高忘事或答错风险时,这个预设能把对话拉得更长、更专注在当下这一轮。
使用场景
- 长期陪聊,上下文只留最近一轮原文
- 语言或情境陪练,旧事靠记忆库检索
- 日常助手式对话,不需要盯完整代码上下文
适合人员
- 需要把 DSH 当长期对话伙伴的用户
- 能接受记忆检索替代完整上下文的陪练用户
- 以聊天与轻量任务为主、少写长代码的人
相关插件

为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
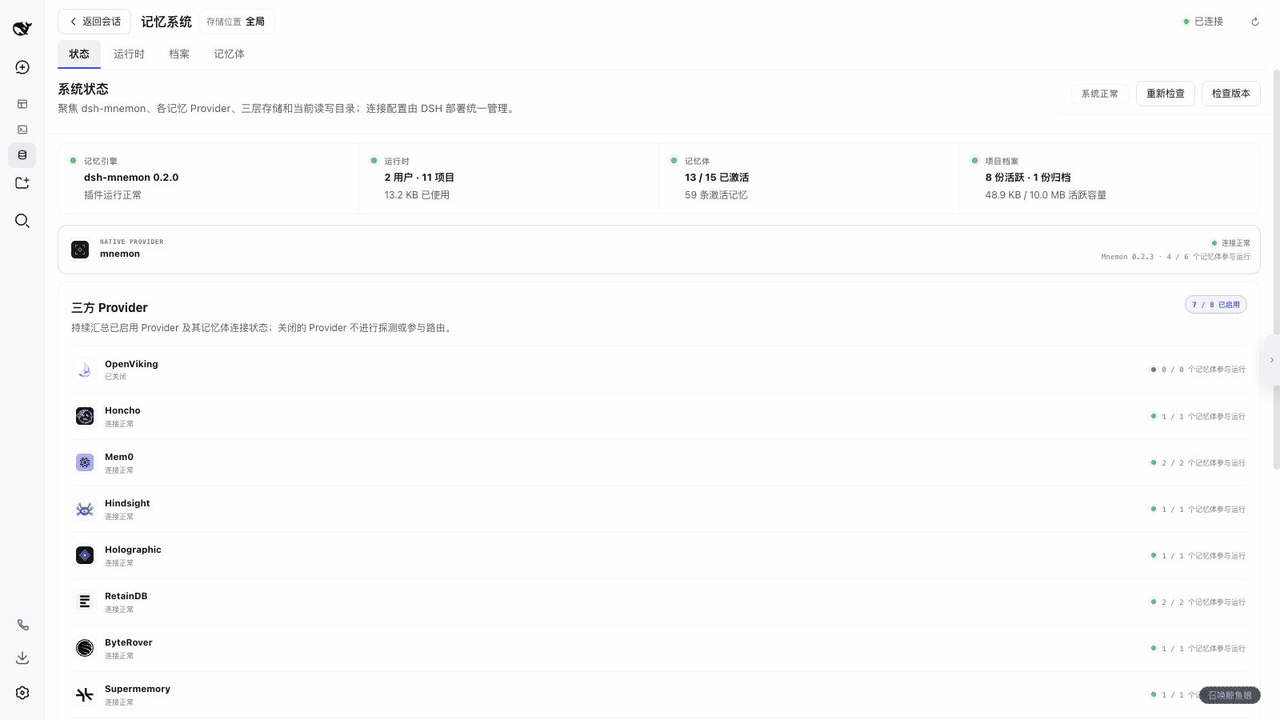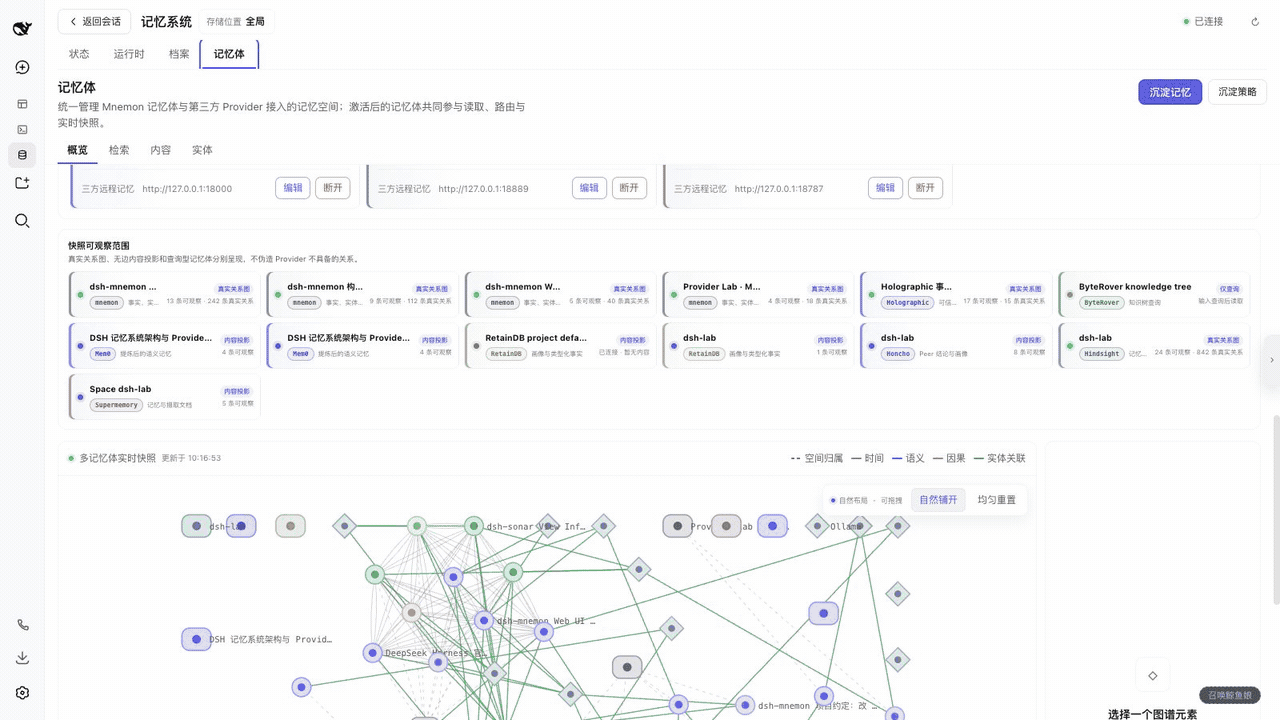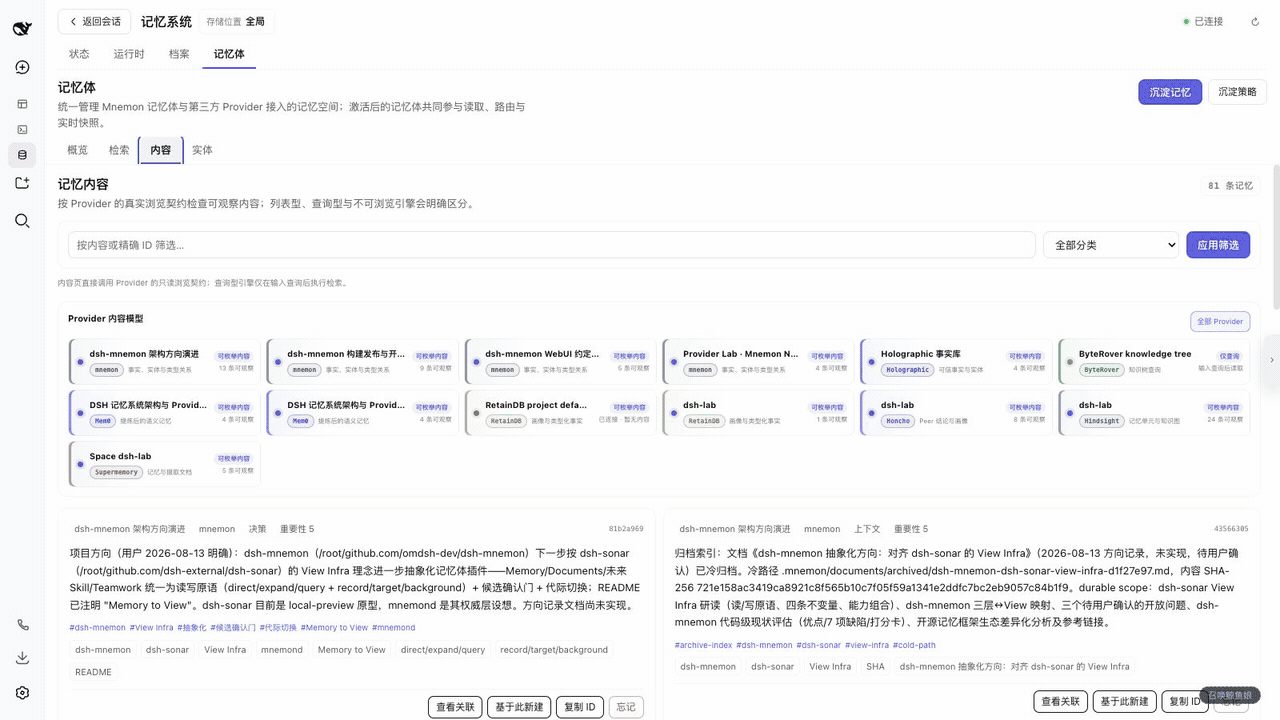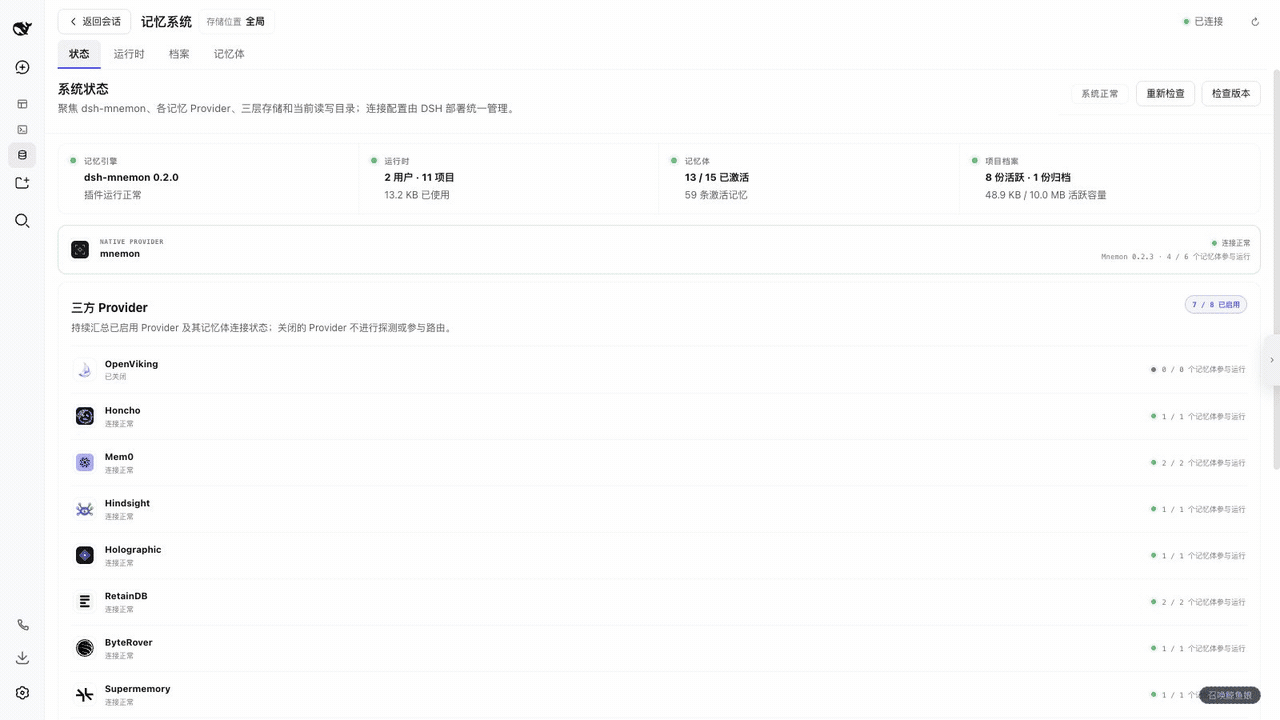
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。