dsh-llm-sampling-params
在终端中运行以下命令:
dsh plugin install devhang/dsh-llm-sampling-params
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install devhang/dsh-llm-sampling-params 安装本插件(源码:https://github.com/devhang/dsh-llm-sampling-params),安装后重启 dsh web 或刷新 GUI。
插件介绍
DeepSeek Harness 自带的 LLM 调用配置只覆盖 temperature、maxTokens 和 stop,不会把 top_p、top_k、min_p、repeat_penalty、presence_penalty、frequency_penalty 等一并发到网关。而 llama.cpp、SGLang、vLLM 等 OpenAI 兼容后端其实都支持按请求设置这些字段。想在同一套权重上区分「高温度创作」和「低温度写代码」,往往只能改服务端默认或重载模型,既麻烦又占显存。
本插件在传输层包装 globalThis.fetch:凡 URL 含 /v1/chat/completions 的请求,会读取 body 中的 model 别名,在 dsh 设置里的 sampling-params 模型表中查找完整采样集并写回请求体,再交给原始 fetch 发出。未配置的别名原样透传;dsh 已发送的 temperature、maxTokens 等字段,仅在模型表显式配置时才会被插件覆盖,其余采样项由插件注入,避免与 dsh 默认值「抢字段」。repeat_penalty 会同时映射为 repeat_penalty 与 repetition_penalty,以适配不同后端。
同一网关可用多个别名指向同一份权重(llama.cpp 别名列表、vLLM 多 served-model-name 等),在 dsh 的 llm-pi-ai 里每个别名是一条可选模型;你在界面切换模型,即切换采样角色,无需额外 VRAM。因 agent-loop 请求体被深度冻结且 pi-ai 适配层不转发完整 GenerateOptions,插件刻意不改 dsh 内部,只在 JSON 出站前改 body,并带 Symbol 防重复包装以支持热重载。
适合在本地或自建 OpenAI 兼容推理栈上跑 dsh 0.1.x/0.2.x 的用户:需要按别名精细控采样、又希望配置随 dsh 版本走 settings 或 cordis.patch.yml。目标网关需认上述 wire 字段;可用 DSH_SAMPLING_DEBUG 或 llama.cpp 的 /slots 等方式核对注入是否生效。
使用场景
- 同一权重上用多个别名区分创作与编码等不同采样策略
- 本地 llama.cpp、SGLang 或 vLLM 网关需要按请求下发完整采样字段
- dsh 默认只发 temperature 等少量参数,需在不改内核的前提下补全 top_p、top_k 等
适合人员
- 在自建 OpenAI 兼容推理栈上运行 dsh 的开发者
- 需要按 UI 所选模型别名切换采样行为的高级用户
- 使用 dsh 0.1.x 或 0.2.x 并维护 sampling-params 模型表的用户
相关插件

DeepSeek Harness 社区「破甲」插件:84 条宿主补丁、25 层自检与侧栏整页设置,本机可见状态、快照回滚,减少确认打断,让 Agent 更连贯地辅助学习与动手实验。
DSH 服务化侧边栏框架,提供文件工作台、内嵌浏览器、真实终端、Git 面板等完整工作台,并开放服务供插件扩展。
美观实用的 Claude Code 风格 TUI 插件:像素鲸鱼顶栏、流光大字、实时状态行、思考流式展开、时间回溯、上下文进度条与 TPS 仪表,零核心改动。
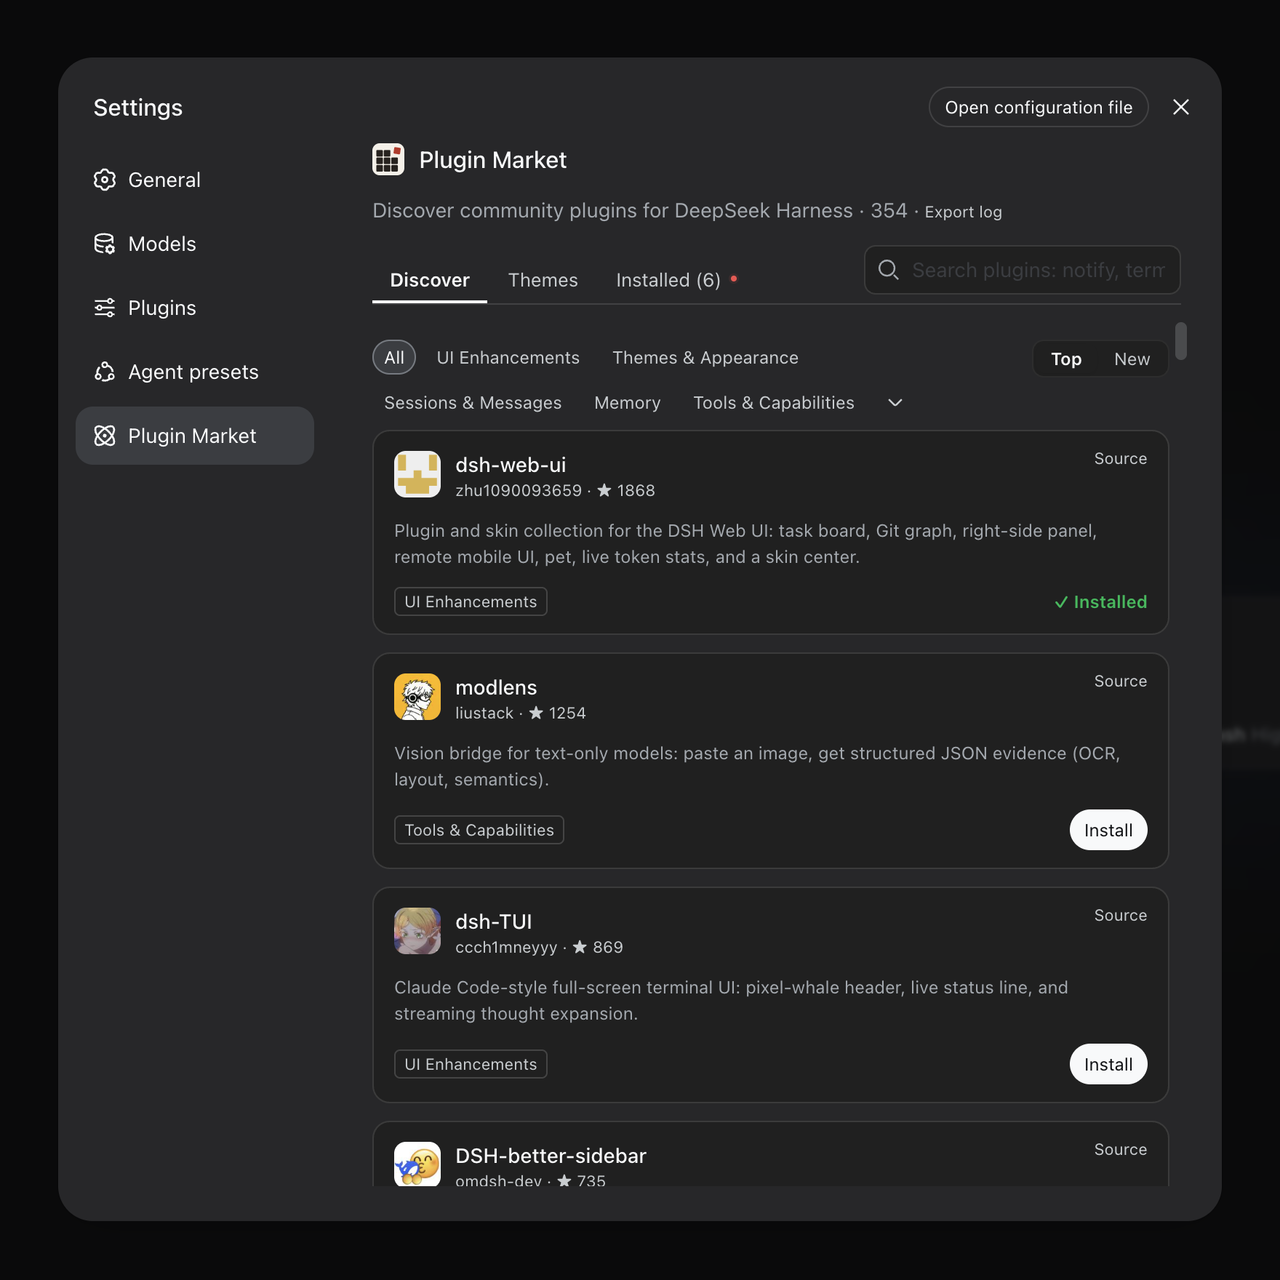
DeepSeek Harness 插件市场:浏览/搜索/一键安装社区插件与主题,支持更新、备份、热禁用、诊断与AI修复。