dsh-chatgpt-to-memory
在终端中运行以下命令:
dsh plugin install wojiao42/dsh-chatgpt-to-memory
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中可通过插件市场自定义安装,或使用命令 dsh plugin install wojiao42/dsh-chatgpt-to-memory,源码见 https://github.com/wojiao42/dsh-chatgpt-to-memory。
插件介绍
长期在 ChatGPT 里积累的大量对话,一旦换到 DeepSeek Harness 或其它助手,往往只剩下零散印象,很难把「对自己真正有用的事实」系统地带进长期记忆。本插件针对这一缺口:不替你做全自动灌库,而是把官方导出包整理成可审计、可蒸馏的候选数据集,并明确把落库交给 dsh-long-term-memory,避免在插件里悄悄改你的记忆文件。
核心工作流是扫描最新导出、按会话与消息文本两层去重、统计新增并写出 dataset 与 report。你可以用 import_status 看清当前目录与上次结果,用 import_configure 调整蒸馏取向,用 import_scan 跑完整扫描,或用 import_preview 在动手前先掂量质量与数量。插件在 M1 阶段坚持只读你自己的导出目录与工作区 profile,不发网络请求、不拉起子进程;候选经 agent 蒸馏后进入 inbox,再由记忆插件消费。蒸馏口径上只认 user 消息为事实来源,并避免从问句或 AI 回复反推私事。
适合正在把 ChatGPT 历史迁移进 DSH 长期记忆的用户:尤其是希望先看清「去了多少重、多了什么」再决定是否蒸馏,且能接受 M1 仍须自行维护导出下载(M2 才会迁入浏览器侧链路)的人。若你追求一键导出到落库的全自动流水线,需要等 import_run 与配套能力补齐后再用。
使用场景
- 想把 ChatGPT 官方导出整理成可蒸馏的记忆候选
- 换用 DSH 前需要审计导出里有多少新增、重复对话
- 在落库前先用预览评估数据集质量与规模
适合人员
- 正在把 ChatGPT 历史迁入 DeepSeek Harness 的用户
- 希望记忆落库走 dsh-long-term-memory 标准通道的开发者
- 能接受 M1 自行维护导出、重视审计报告的人
相关插件

为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
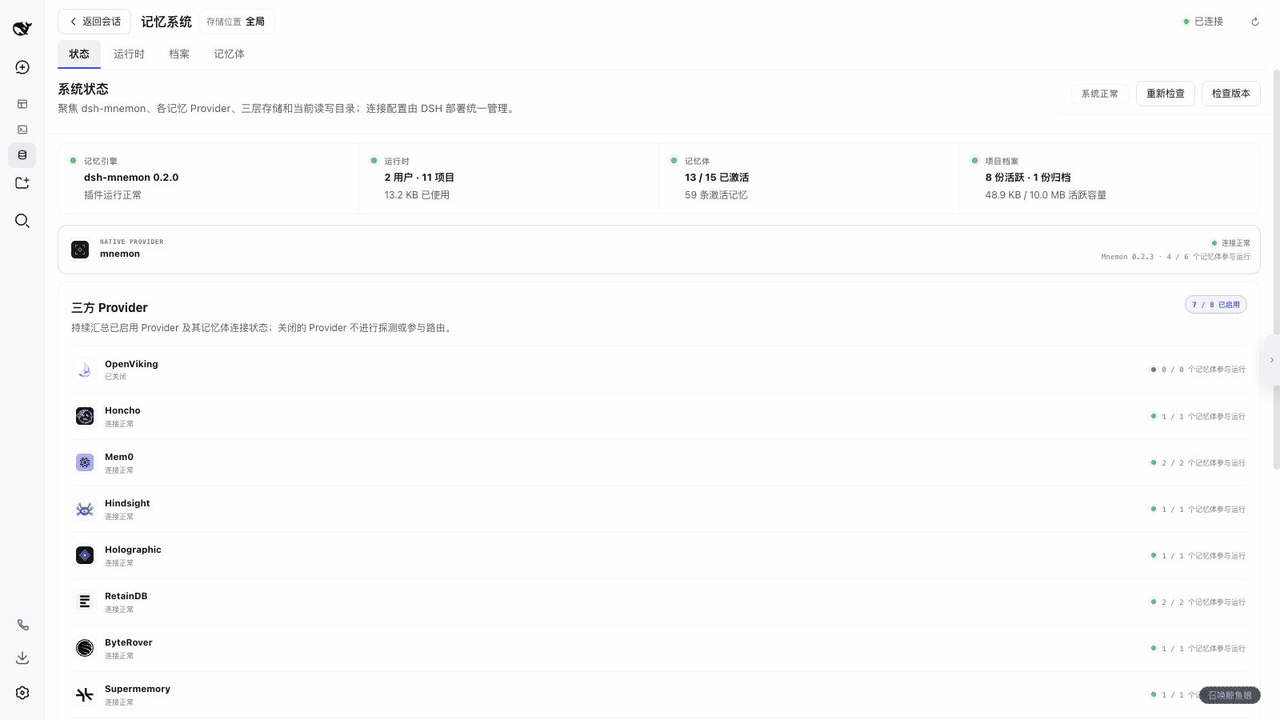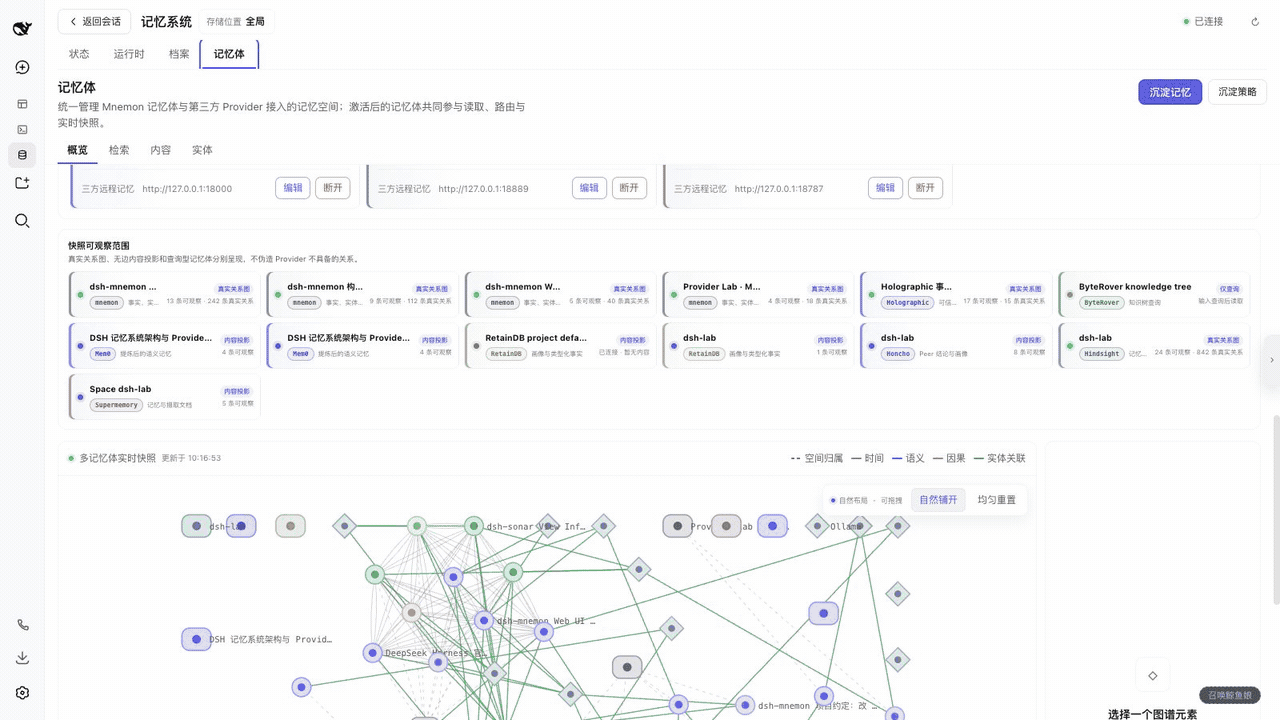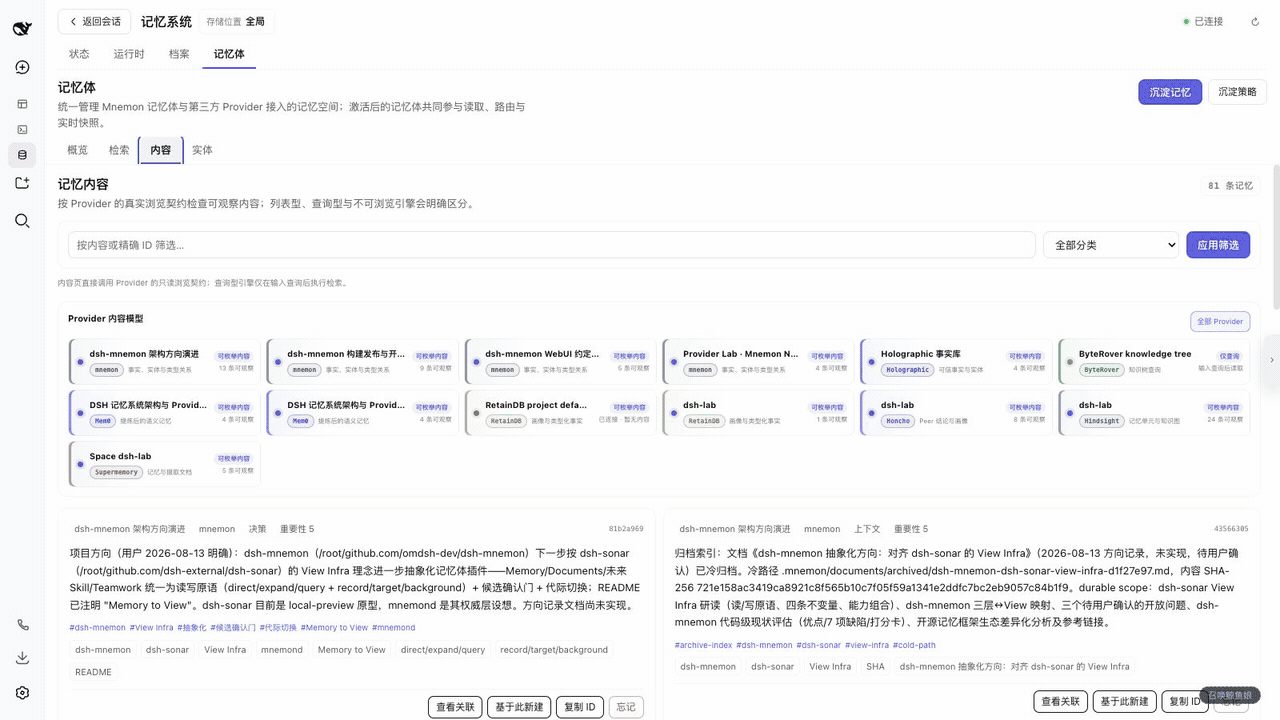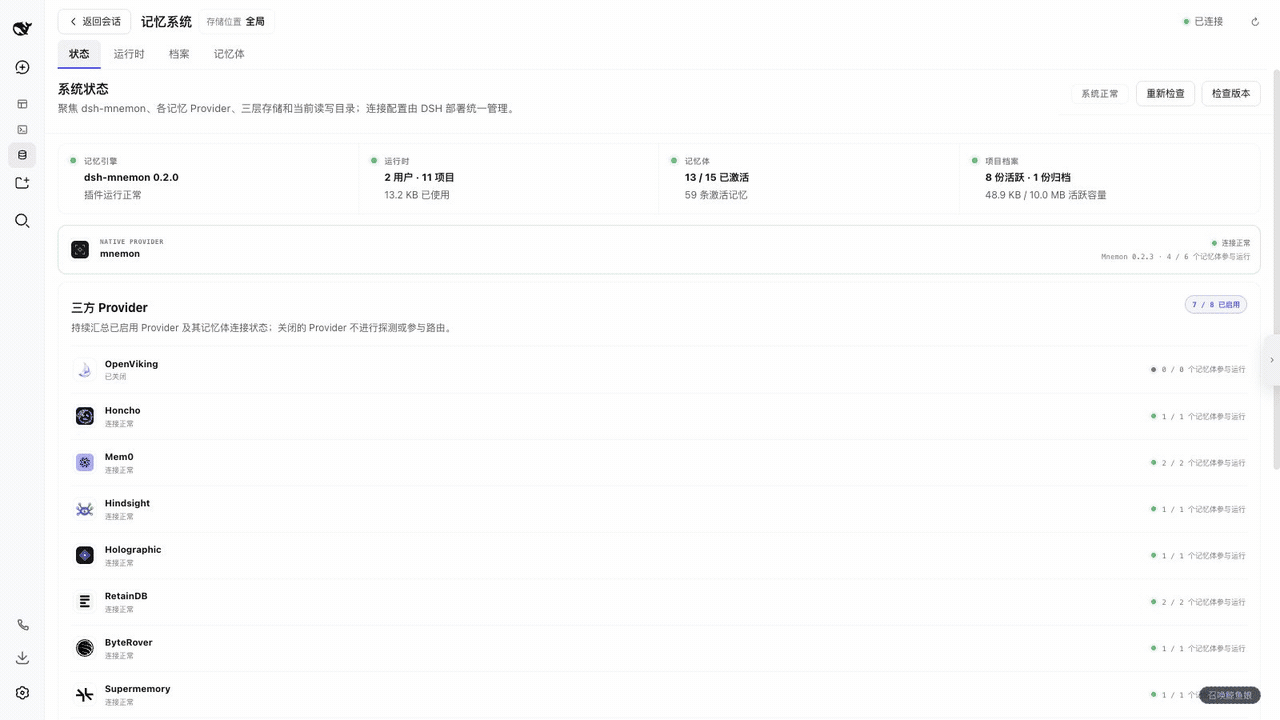
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。