dsh-novel-fade
在终端中运行以下命令:
dsh plugin install DrizzleGig/dsh-novel-fade
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install DrizzleGig/dsh-novel-fade,或从 https://github.com/DrizzleGig/dsh-novel-fade 安装后重启 Harness。
插件介绍
用 AI 写几十万、上百万字的长篇小说时,最头疼的往往不是当下这一章,而是模型慢慢忘掉前面的人物、伏笔和因果。把旧章节整段塞进上下文既烧钱,又挤占真正用来构思和落笔的空间。「褪色」针对的就是这种长篇创作的上下文困境:它不替你写剧情,而是给模型一套会逐渐淡化的记忆——最近的进展记得清楚,久远的故事只保留重点,需要细节时可以翻旧账。
写完一章,一次 memo_digest 就能把正文沉淀成事件卡与场景卡,并把原文按需存进贮存;写下一章前,memo_brief 只给你一份约 1400 字的创作简报,不必反复携带整部小说。记忆不是黑箱:每张卡都有可解释的三维分数(熟、可及、保真),可及性随章节衰减,越过 0.55 的线意味着写细节前该翻旧账。与此同时,死亡、身份暴露、承诺、未解决因果等 L0 硬契约永不褪色,始终精确。
七个 memo_* 工具与右侧「长篇记忆」面板构成闭环:回忆、遗忘、体检、补录旧章原文、按需取片段,都在作者主权之下进行——默认关闭、不写正文、不做向量库与 RAG。适合坚持用 AI 连载长篇、又希望记忆可控、Token 可算、旧细节能核对原句的写作者。
使用场景
- AI 连载长篇时避免每章重复塞入旧正文
- 章末沉淀事件卡与场景卡、章前只取创作简报
- 卡褪色后按人物或关键词翻记忆并核对原句
适合人员
- 用 AI 写几十万字以上长篇的连载作者
- 在意上下文成本、希望记忆可解释可回查的写作者
- 需要 L0 硬契约与软记忆分层管理的创作者
相关插件

为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
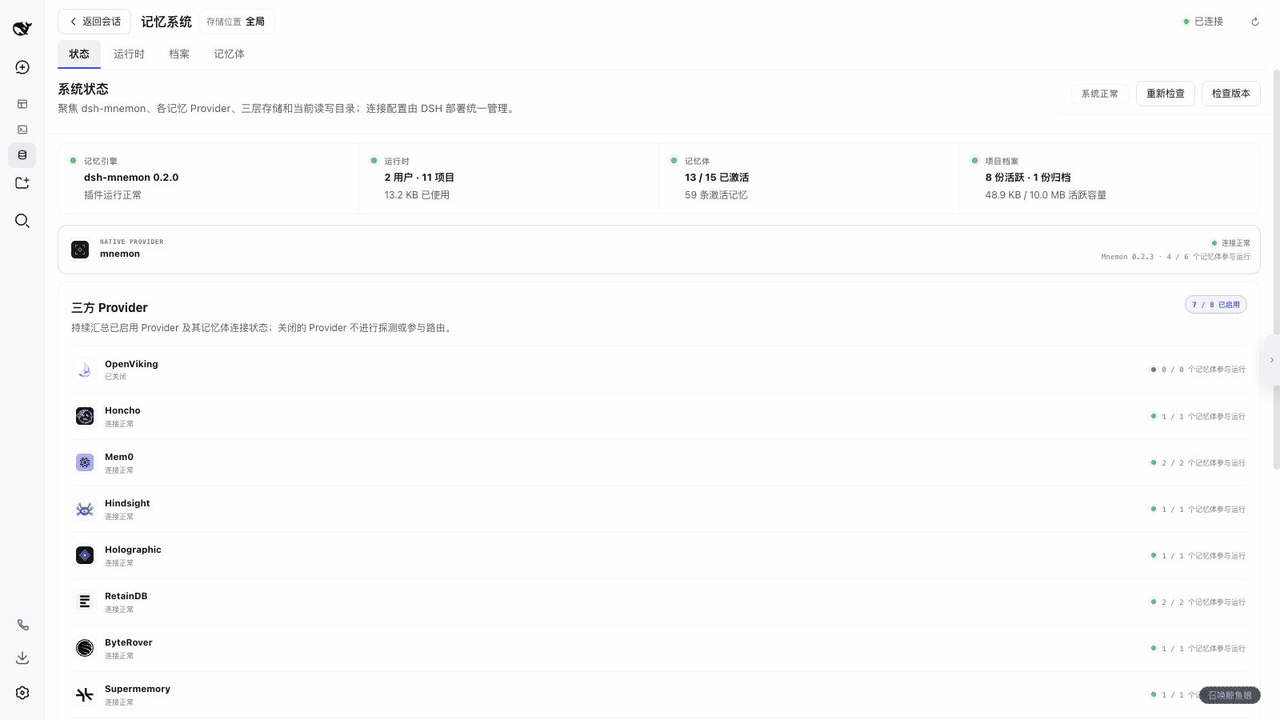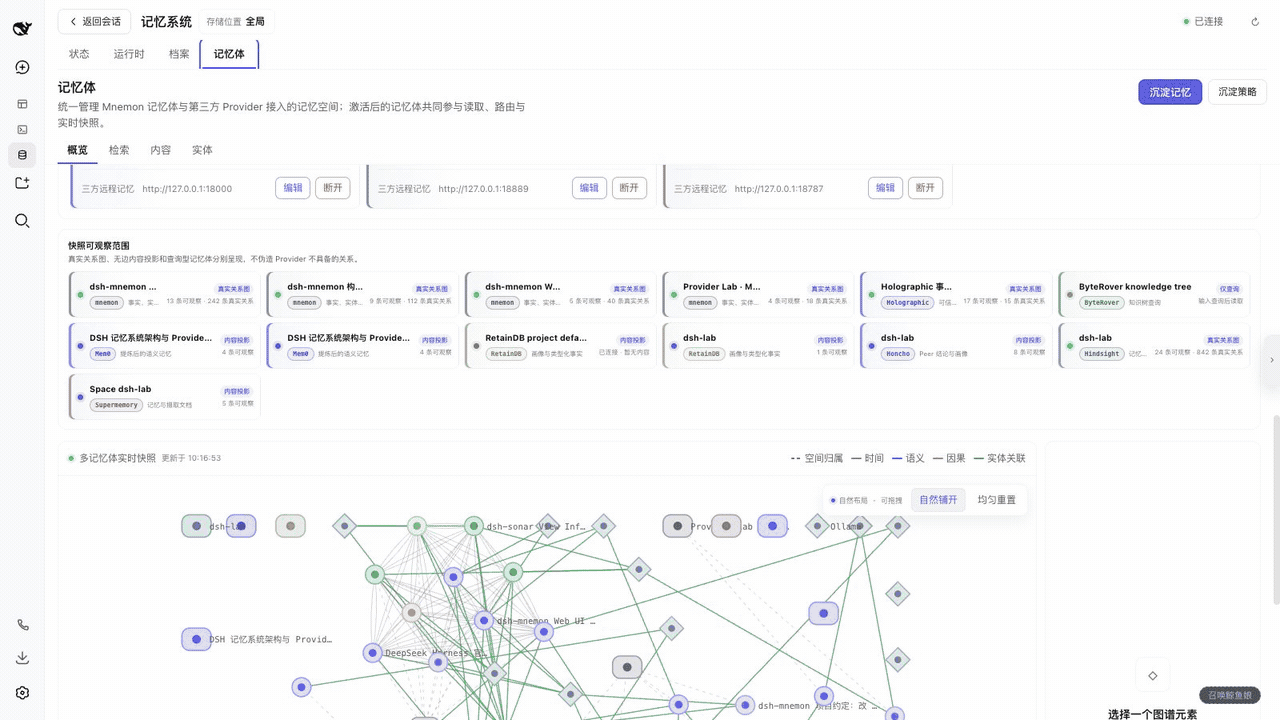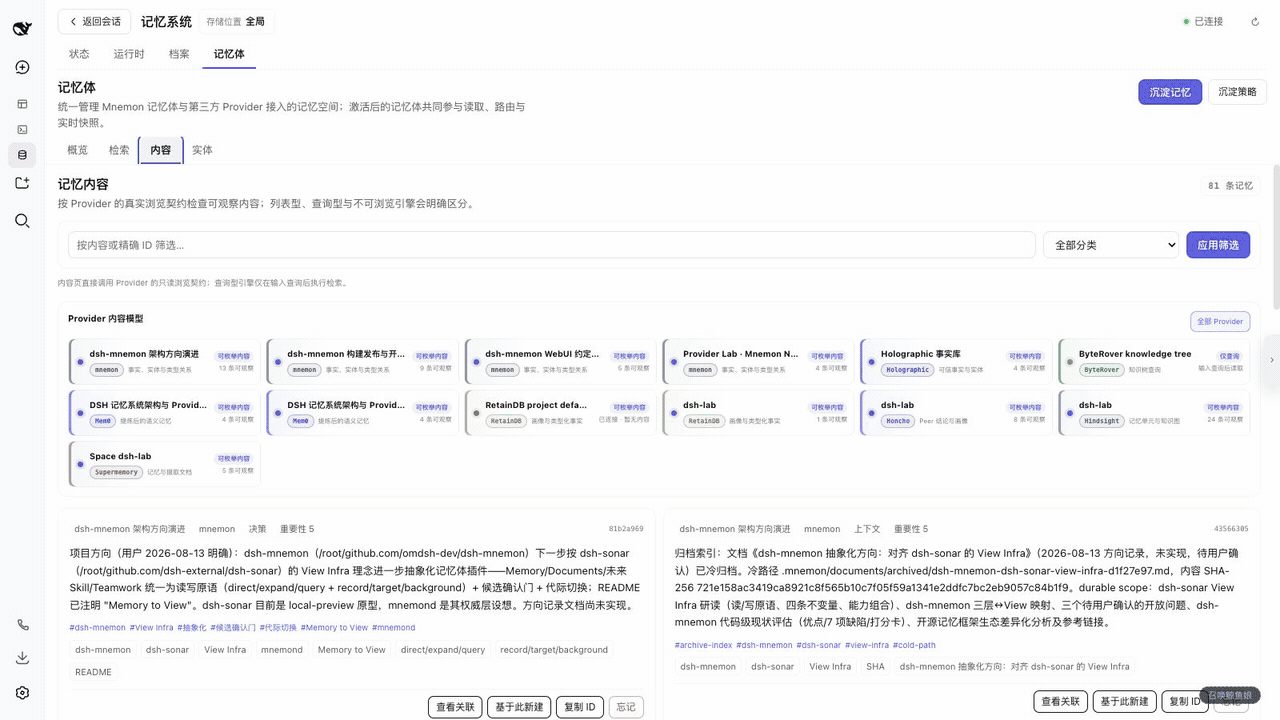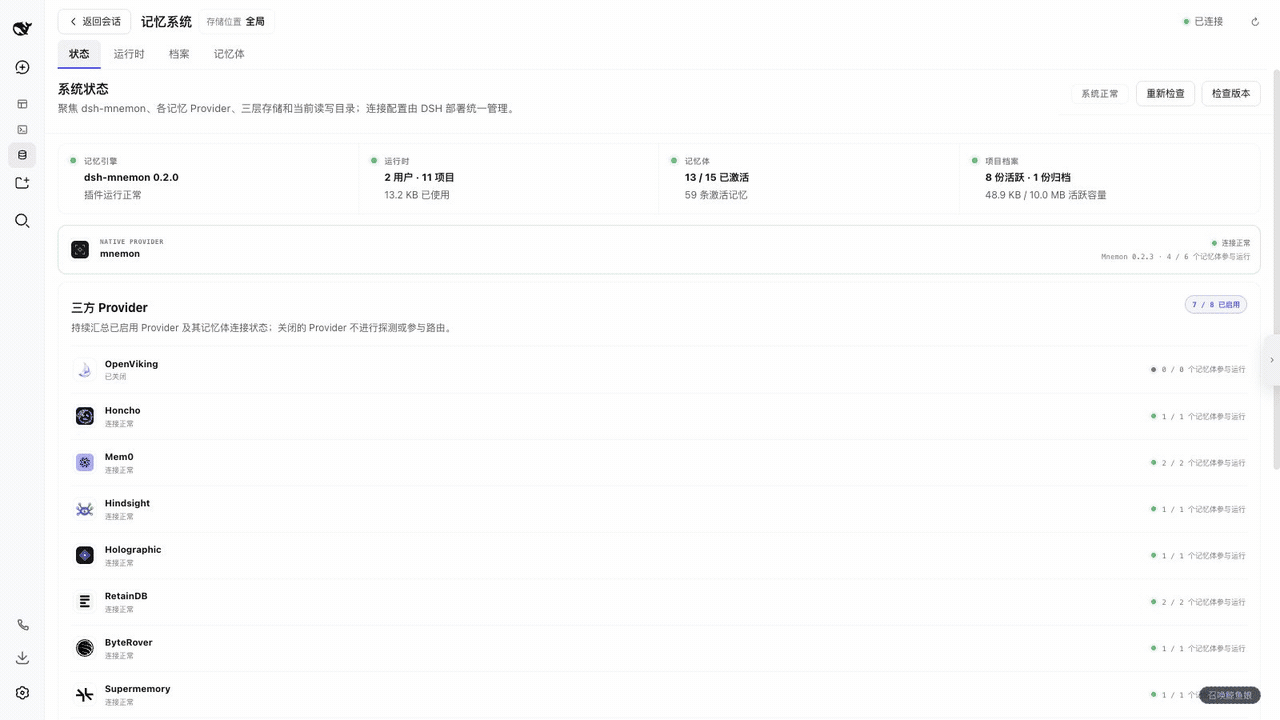
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。