dsh-voice-dialog
在终端中运行以下命令:
dsh plugin install QiNFPV/dsh-voice-dialog
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中打开插件管理,执行安装命令 dsh plugin install QiNFPV/dsh-voice-dialog,或将发布包按说明安装,并确保配置已列入 profile 的 bundle 后完整重启;源码与说明见 https://github.com/QiNFPV/dsh-voice-dialog。
插件介绍
在桌面或网页里和助手来回打字,往往打断思路;想要「像打电话一样」持续说、持续听,又不愿每说完一句就点一次按钮。DSH Voice Dialog 面向 DeepSeek Harness,用一次点击进入语音模式,之后只需自然说话:停顿约 1.2 秒自动分句,识别文本会先出现在输入框,并在约 2 秒的确认窗口后自动发送;期间按键或点击即可暂停计时、改字再发。
回复侧默认走 Microsoft Edge TTS,并按回复语言选音色;只有由语音触发的消息会朗读,你手打的内容保持静音。播放中再次开口会立刻打断播报(Barge-in),方便追问或改口;约 10 秒无语音会自动退出,避免麦克风长期占用。识别结果会做常见纠错与口吃折叠,极短应答(如「嗯」「好的」)也会尽量按语言正确保留;可选接入本地 faster-whisper 桥接或外部 OpenAI 兼容 STT/TTS,以提升准确度或定制链路。
界面文案会随 DSH 中英文切换;设置里可调语言列表、朗读音色、纠错与口吃处理等。若你配置了本地 Whisper,还可周期性检查 faster-whisper 与模型版本,在设置页查看状态并按需更新(不阻塞语音输入)。
适合经常在 Harness 里做头脑风暴、边走边聊、或不便长时间打字的用户;也适合希望「说—听—再说」闭环、又不想维护独立 Python 服务或 ffmpeg 的默认场景(可选本地识别除外)。在同一窗口同时开两个语音模式或混用语音与长篇打字时,需注意会话行为差异(语音会话下回复会被刻意压缩为短句以便朗读)。
使用场景
- 一边做事一边用 Harness 提问,不用每句都点发送
- 散步或通勤时用麦克风连续聊,支持说话打断播报
- 需要快速口述想法、让助手用语音读回短答的场景
适合人员
- DeepSeek Harness 0.2.x 桌面或网页用户
- 偏好语音输入输出、希望减少打字的日常用户
- 愿意可选配置本地 Whisper 以提升识别准确度的进阶用户
相关插件

DeepSeek Harness 社区「破甲」插件:84 条宿主补丁、25 层自检与侧栏整页设置,本机可见状态、快照回滚,减少确认打断,让 Agent 更连贯地辅助学习与动手实验。
DSH 服务化侧边栏框架,提供文件工作台、内嵌浏览器、真实终端、Git 面板等完整工作台,并开放服务供插件扩展。
美观实用的 Claude Code 风格 TUI 插件:像素鲸鱼顶栏、流光大字、实时状态行、思考流式展开、时间回溯、上下文进度条与 TPS 仪表,零核心改动。
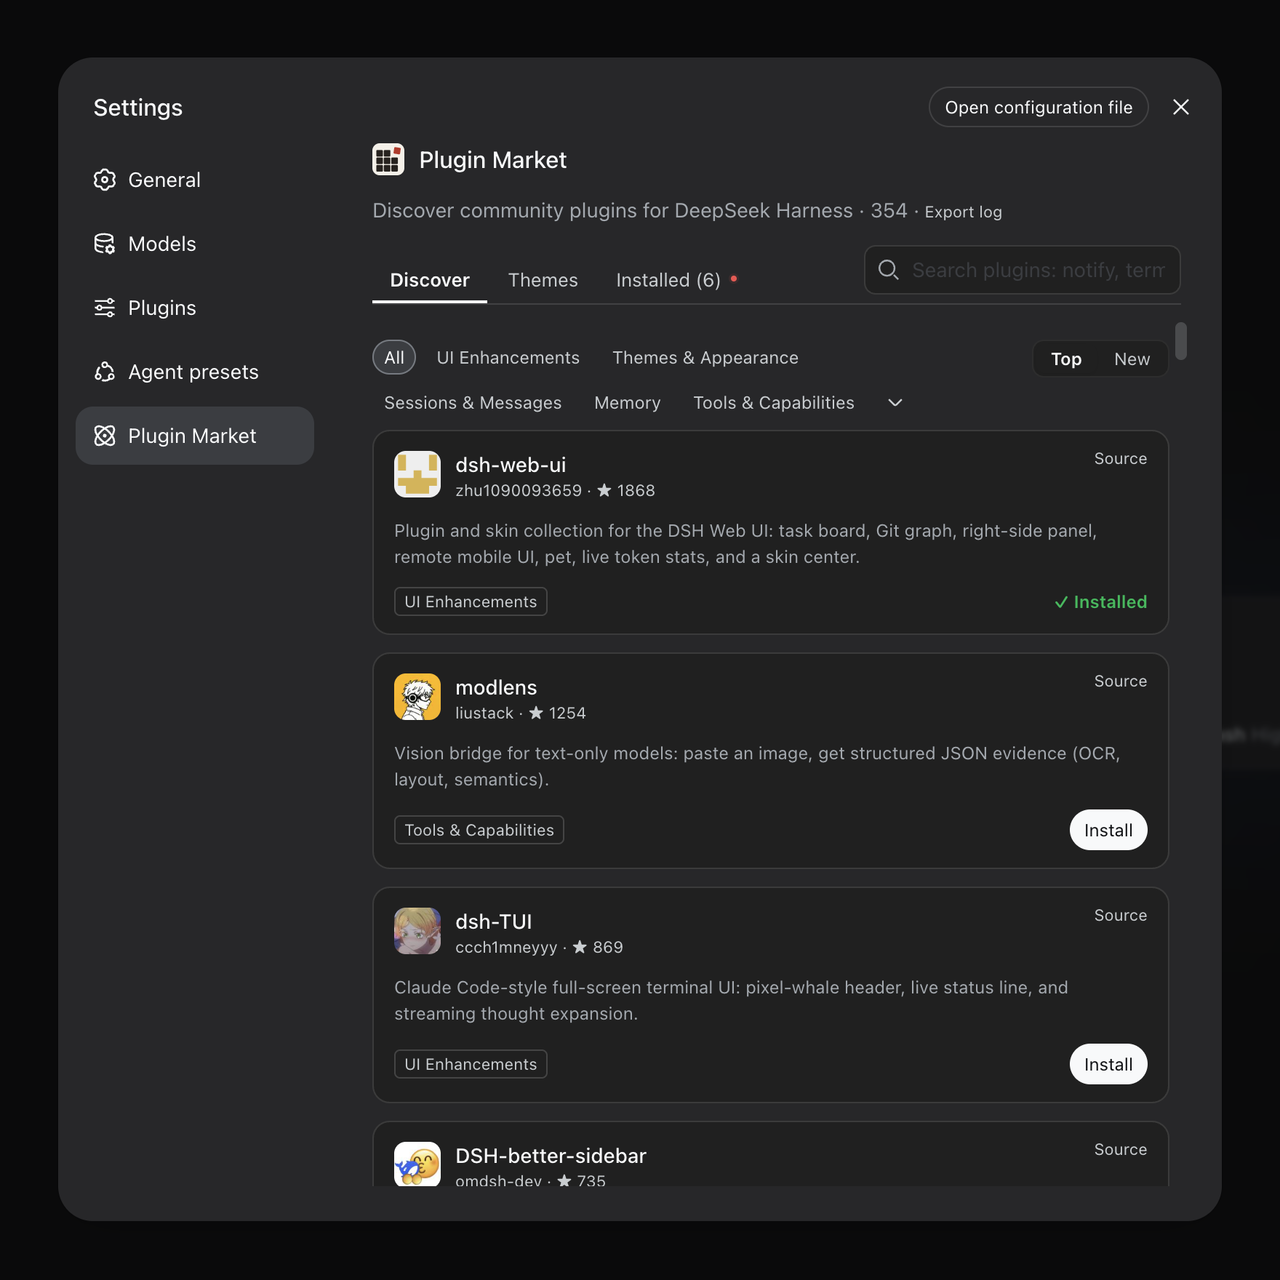
DeepSeek Harness 插件市场:浏览/搜索/一键安装社区插件与主题,支持更新、备份、热禁用、诊断与AI修复。