dsh-memory-ladder
在终端中运行以下命令:
dsh plugin install BTYG123/dsh-memory-ladder
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行「dsh plugin install BTYG123/dsh-memory-ladder」,从 https://github.com/BTYG123/dsh-memory-ladder 安装本 bundle 插件包。
插件介绍
默认的上下文压缩往往在接近窗口上限才触发,还要重放一大段历史,等于在「快要爆」时才开始收拾局面;压完后新旧事实混成一块摘要,模型也难以区分哪些是最近发生的、哪些是更早的背景。dsh-memory-ladder 把思路换成按新旧分层:设窗口为 T 时,最新一轮独占约三分之一预算,更远的层级逐层减半(T/6、T/12…),用一次「睡眠」模型调用把将要被遮蔽的历史重写成一条可追溯的「记忆阶梯」,而不是把陈年往事和当下细节糊成一段平铺叙述。
核心的分层睡眠事务仍然依托上游 BasicCompactionEngine(括号锁、收缩校验、表面替换等);本插件主要替换触发策略与 summarize,把旧阶梯与本轮原始记录合并成新阶梯,并用 surfaceOp 替换会话表面为单条用户消息,原始事件仍留在日志里可回放;/compact 走同一套链路,只是可跳过自动阈值。v0.2 在压缩前把用户、助手与工具消息的文本写入本会话独立归档(默认在工作目录下 .dsh-memory-ladder/),下一步可按用户问题检索已离开上下文的原文,经 Harness 动态上下文接口提供给模型,且不会直接改写已冻结的请求;重复压缩不会对同一消息重复归档,系统指令、旧检查点与运行时上下文不归档。摘录有字节上限,归档内仍保留完整文本。
适合需要长时间、多轮对话且窗口压力较大的 Harness 用户:希望「最新上下文更厚、越远越薄」,并愿意用额外一次摘要调用与可选归档检索来换更清晰的层级结构;若需要近乎无损或极端细节全程保留,应调大 newestFraction、接受更高成本,或避免依赖重度压缩。请把 README 中关于费用、准确率与已知限制(单条超大消息、归档容量上限、摘要质量依赖模型等)一并纳入心理预期,再决定是否启用 archiveRecall 及相关参数。
使用场景
- 多轮长对话逼近上下文窗口上限、需要按新旧分层保留重点时。
- 调研或排障类任务需要跨多轮睡眠保留核心事实、又能按需找回离屏原文时。
- 已使用 Harness 且需替换 compaction 后端、希望更可追溯的「记忆阶梯」而非单次大摘要时。
适合人员
- 使用 DeepSeek Harness、愿意接受分层睡眠与可选归档检索额外成本的用户。
- 需要长时间会话且希望最新轮次占比更大、越远越薄的长任务作者。
- 能理解压缩非无损、摘要与归档有模型与容量限制,并会据此调参的进阶用户。
相关插件

为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
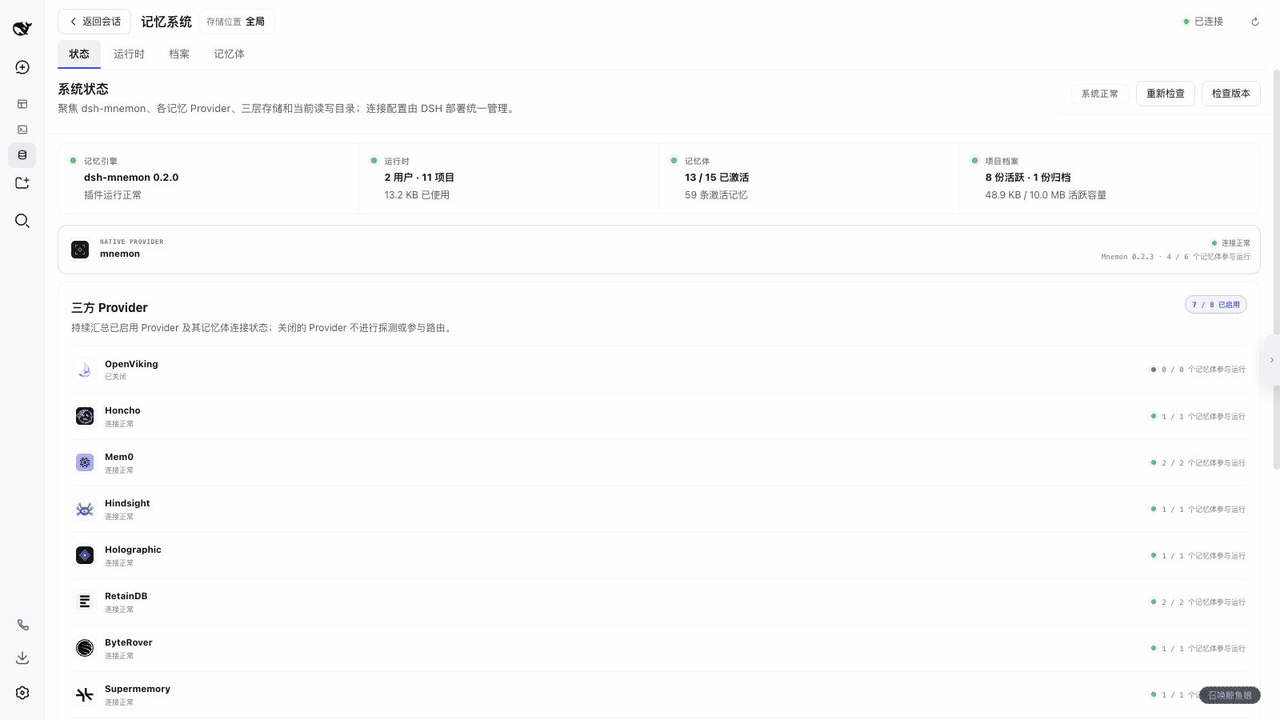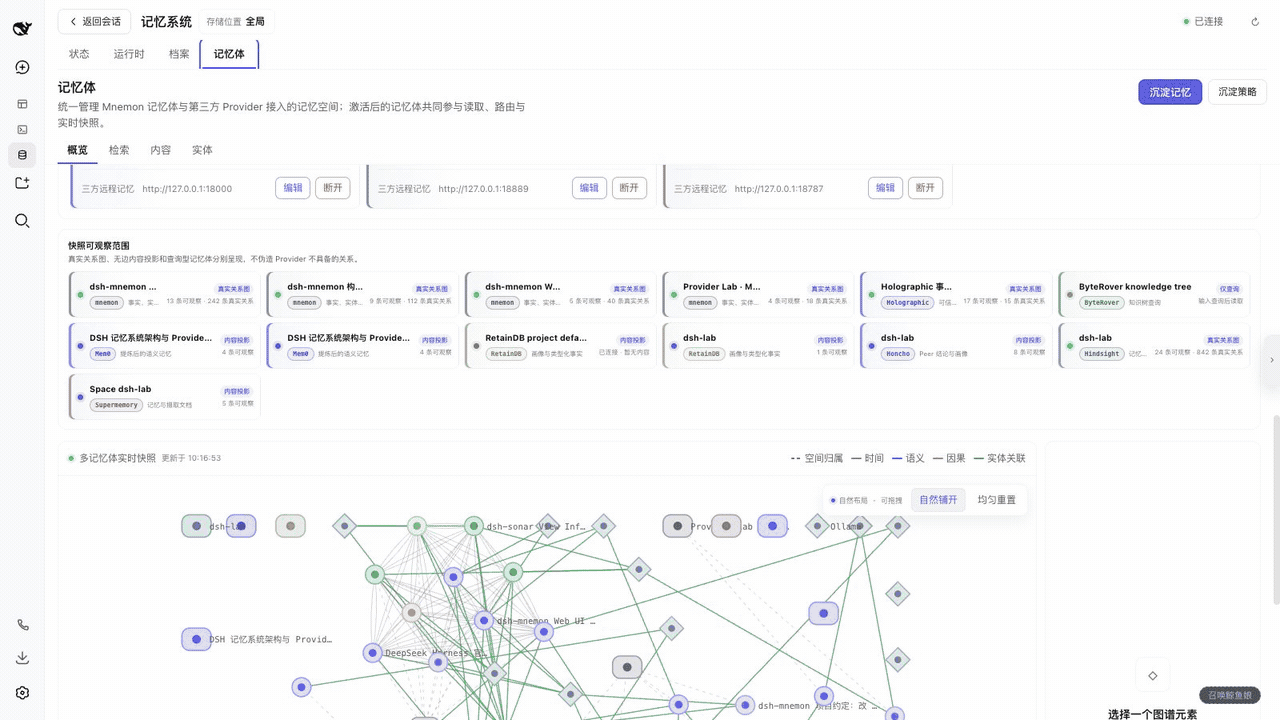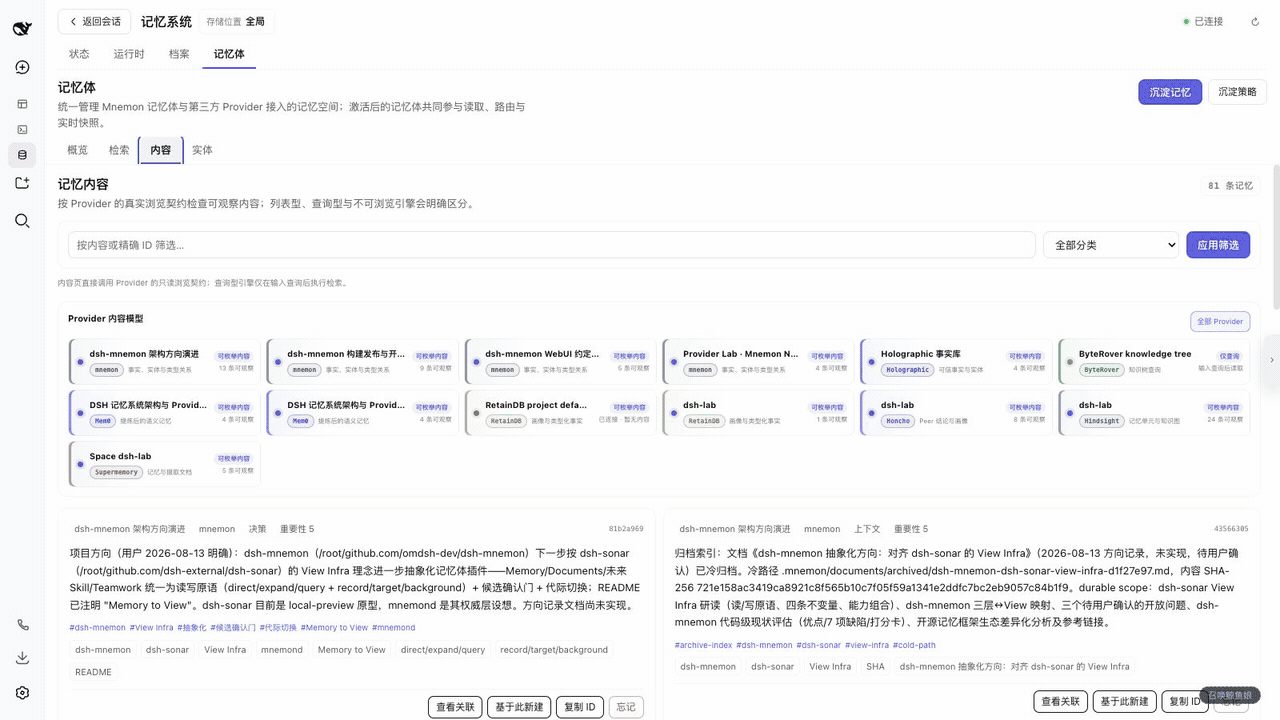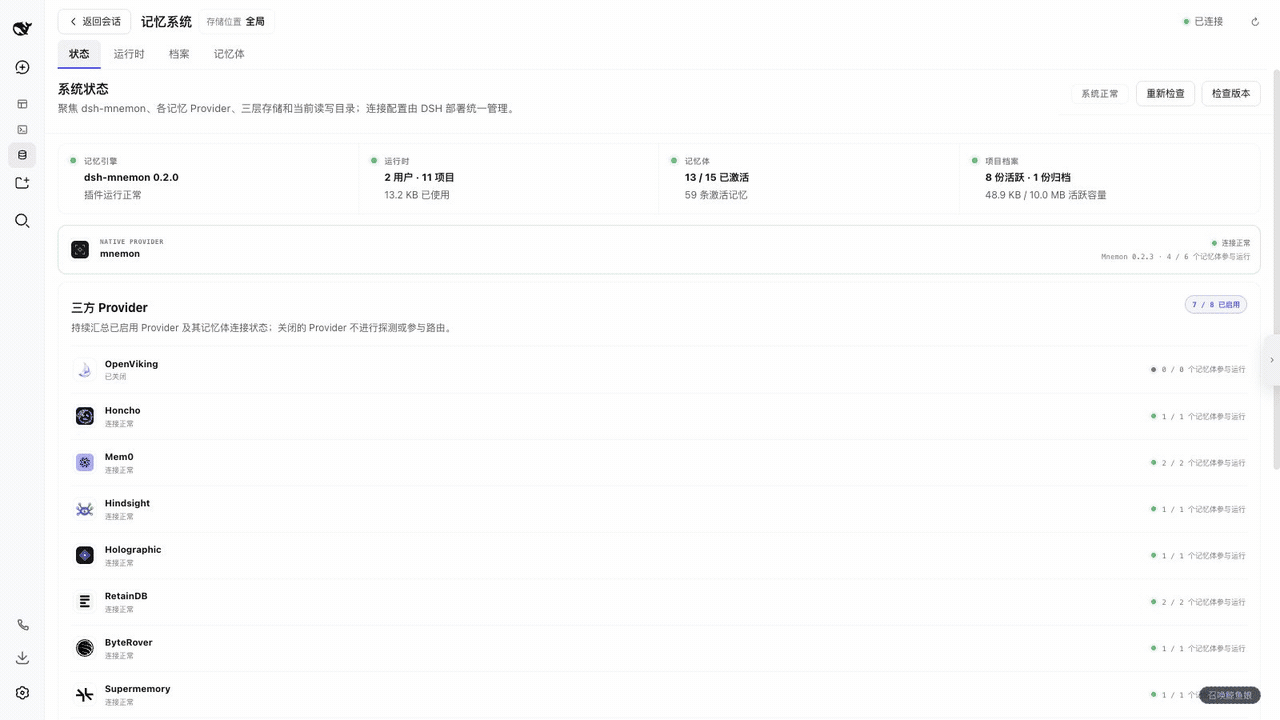
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。