dsh-llm-llamacpp
在终端中运行以下命令:
dsh plugin install slaren/dsh-llm-llamacpp
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中打开 Settings → Plugins,从 GitHub 安装 https://github.com/slaren/dsh-llm-llamacpp,或在终端执行 dsh plugin install slaren/dsh-llm-llamacpp;若提示需重启主机请按指引操作。
插件介绍
本地或自托管 llama.cpp 已经能跑 OpenAI 兼容 API,但在 DeepSeek Harness 里往往缺少「这条请求到底在 prompt 还是 decode、还要等多久」的直观反馈,多路并发时也不清楚 slot 与 KV 占用。本插件把一台或多台 llama-server 登记为显式模型路由,不拦截、不自动改写发现结果,让你在 Settings → Models 里像管理其他提供方一样维护 base URL、别名与凭据引用。
能力上,模型列表与上下文上限来自服务端的 /v1/models 与 /props,推理档位来自 /apply-template;流式对话在重试、推理回放、图片、并行工具调用与用量统计上与内置 pi-ai 路由对齐。Composer 停靠栏的 pill 会显示 prompt/decode 进度、ETA 与 tok/s,点开可查看 slot 上下文、KV 使用、缓存命中率及 /metrics 原始读数;会话会固定到稳定 slot,空闲 slot 可复用而不挤掉进行中的对话。无 Web 界面时路由、发现与流式仍可用,仅 pill 与对话框不挂载。
适合已在 DSH 0.2.x 环境运行 llama-server、希望把推理留在本机或内网、又想在 IDE 里看清实时进度与服务器负载的开发者与进阶用户。插件不会替你启动或管理 llama-server,/metrics、/slots 等遥测端点可选,缺失时界面会优雅降级。
使用场景
- 在 DSH 里把自建的 llama-server 登记为模型提供方并正常流式对话
- 多会话并发时想看清 prompt/decode 进度与各 slot 的 KV 占用
- 需要在 Models 页检查服务可达性并从服务端自动发现模型与上下文上限
适合人员
- 已在本地或内网运行 llama-server 的 DSH 用户
- 希望推理留在本机、又要在 Composer 里看实时吞吐与 ETA 的开发者
- 使用 DSH 0.2.x、需要与内置 pi-ai 路由行为一致的进阶用户
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
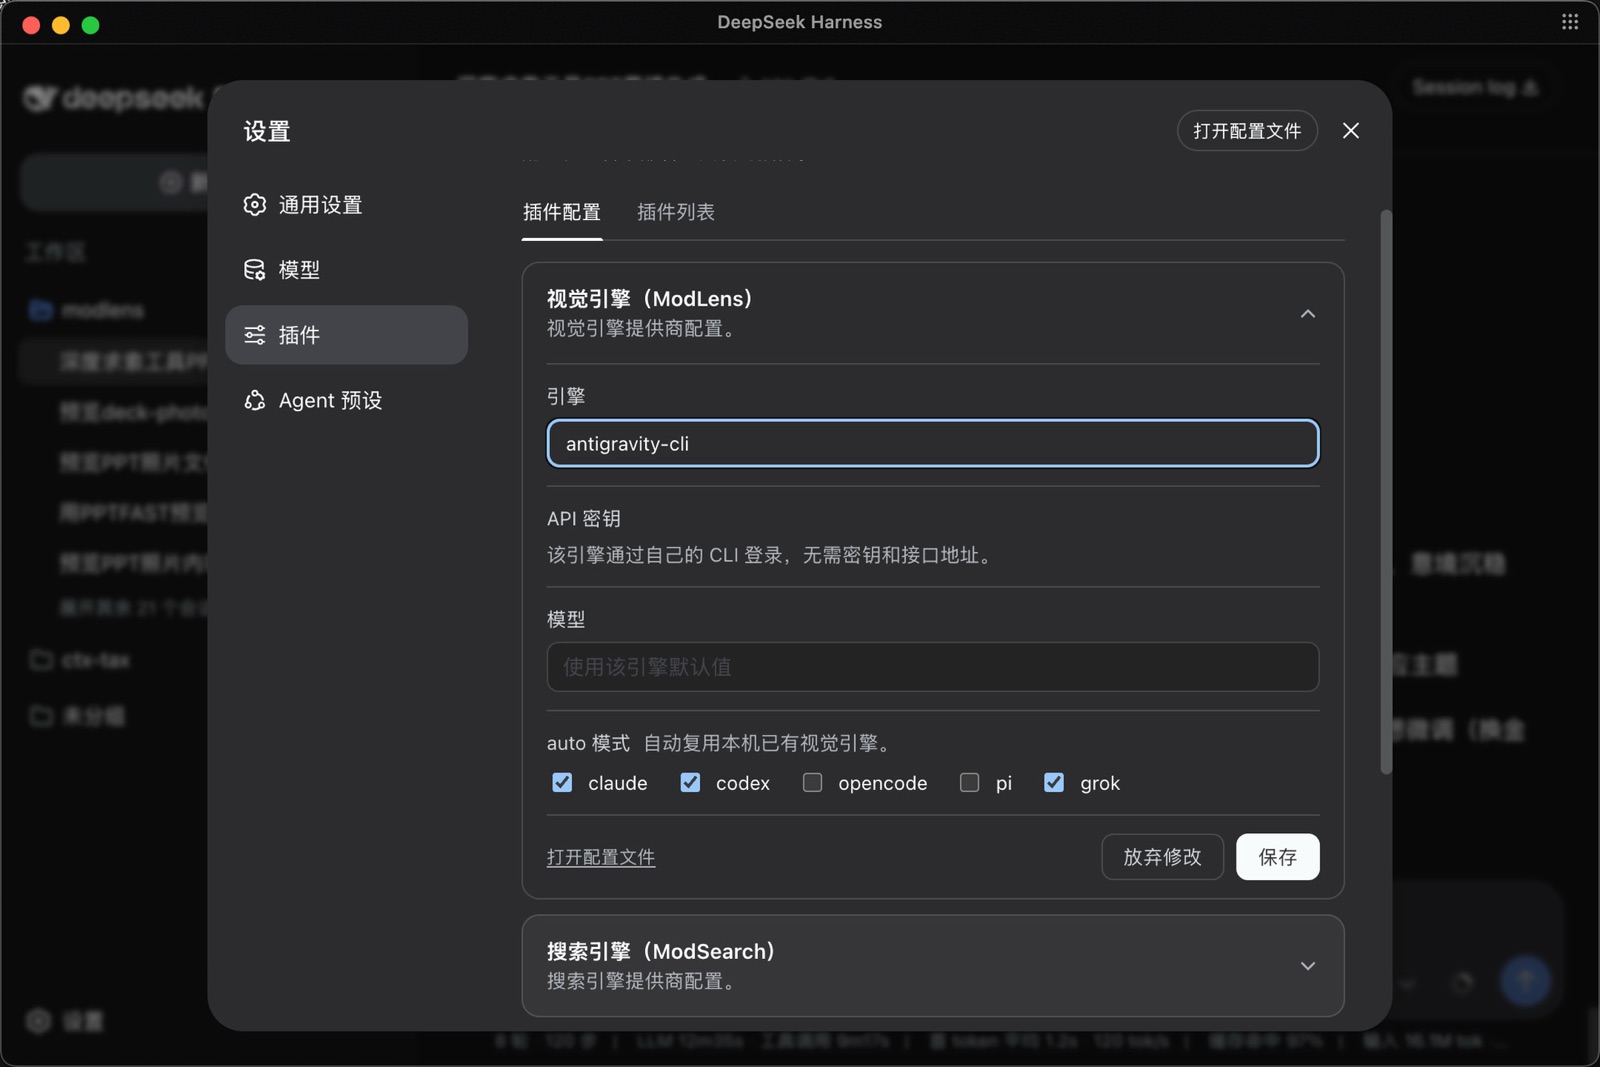
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
以提高 token 效率为目标,通过 OPS 工具、隐藏部分官方工具与按需动态加载,低侵入增强 Native/PTC 推理体验。