dsh-plugin-voice-unified
在终端中运行以下命令:
dsh plugin install ten-feng/dsh-plugin-voice-unified
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install ten-feng/dsh-plugin-voice-unified 安装本插件,源码见 https://github.com/ten-feng/dsh-plugin-voice-unified。
插件介绍
在对话助手里,语音往往分散在「读一句」「换音色」「翻唱一首歌」等不同入口里,样本和训练版本也不好统一管理。dsh-voice-unified 把多音色档案、进化训练、情感朗读和翻唱换声收进一个 DSH 插件,并强调音频默认在本机处理,不把样本、对话或成品音频上传到云端,适合在意隐私、又希望语音能力可配置、可迭代的用户。
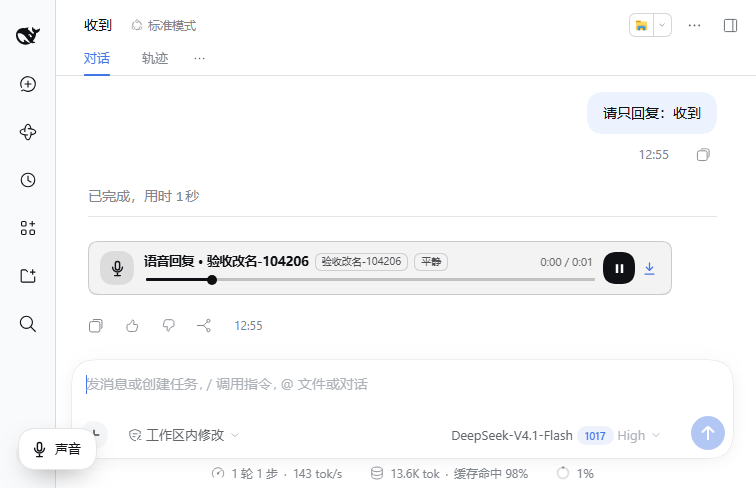
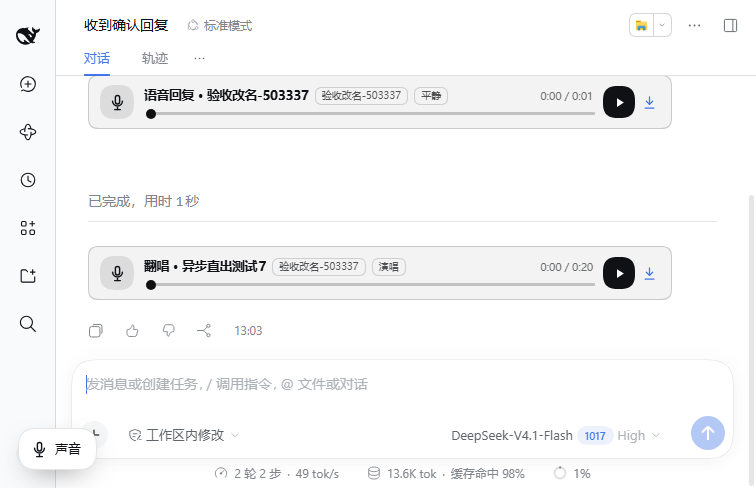
核心能力围绕「档案—训练—使用」闭环:可为每个音色独立维护样本、训练版本与试听记录,并设置全局默认;按需语音与翻唱可临时指定档案而不改动默认。情感 TTS 支持多种情绪与语速、音调等参数;翻唱流水线从分离、音色转换到默认清唱加伴奏,支持异步任务与导出。对话侧默认不自动播报,只有用户明确要「说/唱/朗读/翻唱」时才生成;完成后以微信式语音气泡直出到当前会话,并可右键转文字(TTS 优先原文,其他走本地识别)。
插件还与音乐缓存联动,可接收缓存路径或抓取音乐插件当前音频流;管理面板(设置页「声音」或快捷键)集中管理音色、语音设置、翻唱任务与全局状态。面向 Windows 上的 DSH 用户,尤其是需要多角色音色、情感表达、本地翻唱实验,或要与音乐插件配合做缓存翻唱的人。
截图预览
使用场景
- 对话里按需说/唱/朗读,不想每条回复都自动播报
- 用 2~4 段样本训练个人音色,并做增量进化与版本回滚
- 从音乐缓存或插件音频发起翻唱,清唱+伴奏直出到会话
适合人员
- 在 Windows 上使用 DSH、希望语音能力集中管理的用户
- 重视本机处理、不愿上传语音样本与对话音频的用户
- 需要情感朗读、多角色音色或本地翻唱实验的内容创作者
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
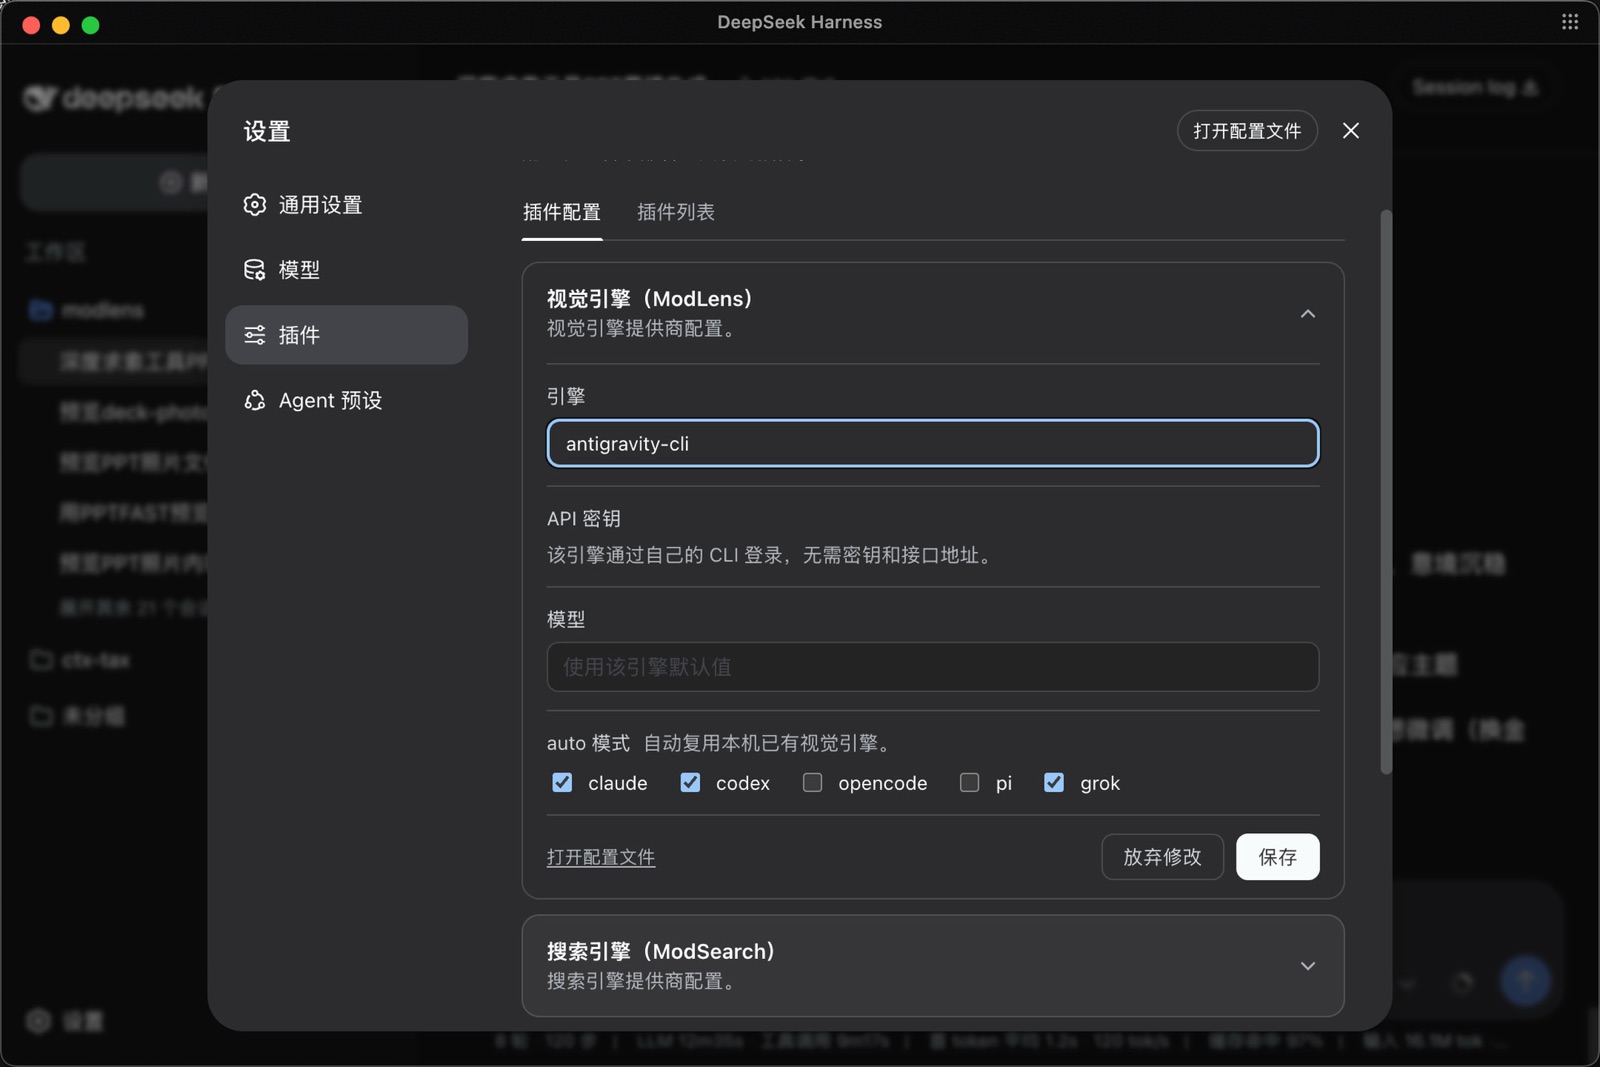
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
以提高 token 效率为目标,通过 OPS 工具、隐藏部分官方工具与按需动态加载,低侵入增强 Native/PTC 推理体验。