dsh-npu
在终端中运行以下命令:
dsh plugin install YarXVI/dsh-npu
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中打开插件安装入口,执行 dsh plugin install YarXVI/dsh-npu,或按清单从 https://github.com/YarXVI/dsh-npu 安装本插件。
插件介绍
本地推理真正烦人的往往不是「模型跑不起来」,而是跑起来之后留下的烂摊子:启动器退了进程还在、多个工具各占一个窗口、配置散落各处,ROCm 还可能静默退回 CPU 却照样返回 healthy。燧心(dsh-npu)是 DeepSeek Harness 的本机推理插件,把面板、模型槽位、引擎运行时和代理端口收进同一个插件,所有模型进程随 DSH 一起点火与熄火,退出时不留孤儿进程占显存和端口。
引擎侧覆盖 AMD NPU 上的 FastFlowLM,以及 GPU 上的 llama.cpp(Vulkan、ROCm、CUDA 等后端,运行时由插件按需下载)。第五框架 amd-hybrid 在同一条 DSH 生命周期里同时驾驭 NPU 与 GPU,按 route、race、cascade、augment 四种方式协同,对外仍只有一个默认绑定 loopback 的 OpenAI 兼容 HTTP 端口。面板上的状态来自真实探测,槽位空闲可按 idleSec 自动回收,也可一键熄火。
适合已经在用 DSH、希望在 Windows 上把 Ryzen AI NPU 与独显/核显 GPU 用起来、又不想再维护 Ollama/LM Studio 式链式启动器的人。若你既要小模型在 NPU 上省资源,又要在代码与长文上靠 GPU 扛主答,并希望翻译、embedding 与对话路由在一套配置 schema 里统一管理,这个插件就是围绕这类场景设计的。
使用场景
- 在 DSH 里选 npu-local 模型对话,面板一键点火与熄火,退出 Harness 不留模型进程
- 日常请求用 amd-hybrid 的 route:翻译与 embedding 走 NPU,代码与长文走 GPU
- 需要省 GPU 占用时用 cascade,或 race 竞速降低尾延迟(非流式)
适合人员
- 已在用 DeepSeek Harness、希望本机模型与 Harness 同生共死的人
- 拥有 AMD Ryzen AI NPU 与 GPU,想在一套面板里管 FastFlowLM 与 llama.cpp 的用户
- 受够多窗口启动器、孤儿进程和散落配置,想要单一 schema 与真实健康探测的人
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
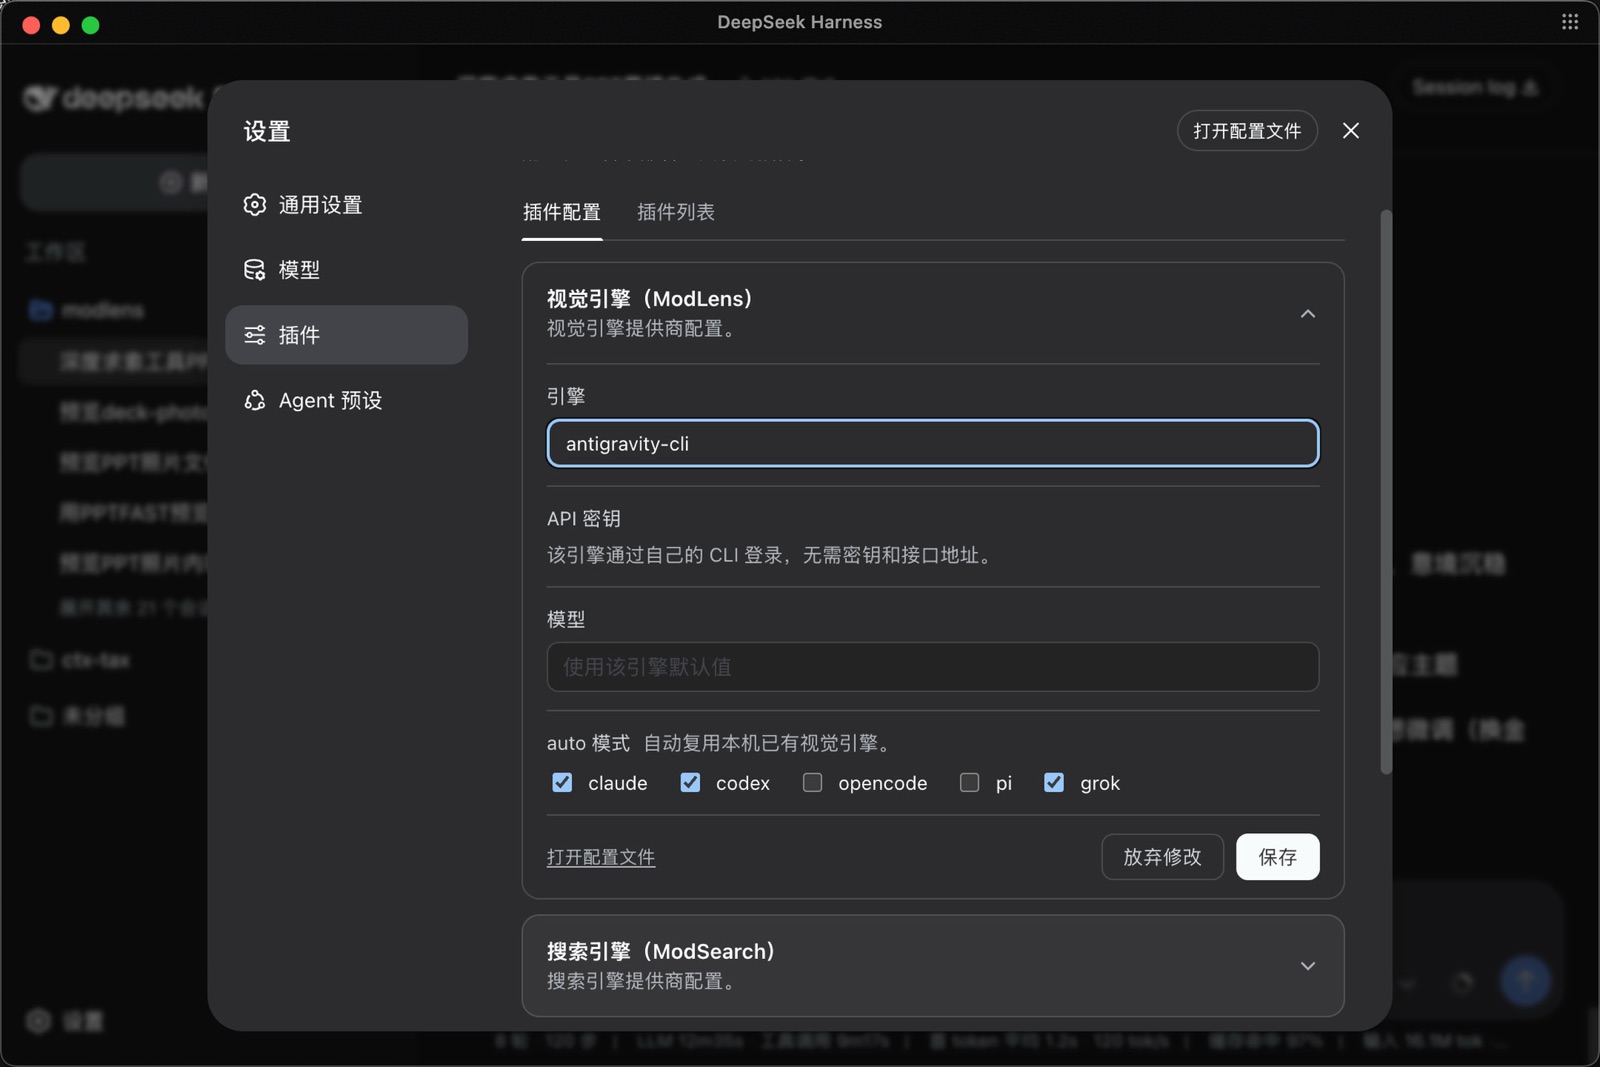
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
以提高 token 效率为目标,通过 OPS 工具、隐藏部分官方工具与按需动态加载,低侵入增强 Native/PTC 推理体验。