
dsh-scrapling
在终端中运行以下命令:
dsh plugin install JayYuen666/dsh-scrapling
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中运行 dsh plugin install JayYuen666/dsh-scrapling 即可安装该插件,完整源码地址为 https://github.com/JayYuen666/dsh-scrapling。
插件介绍
dsh 自带的 web_fetch 是一个诚实而克制的 HTTP(S) GET:不执行 JavaScript,User-Agent 也如实填写。这对大多数场景是合理的默认值,但它意味着遇到单页应用时拿到的只是加载外壳;当你只想提取某个商品表格时,也没有表达这种意图的办法。
dsh-scrapling 填补的正是这块空缺。它把 Scrapling 的抓取能力包装成 dsh 的工具,通过一个常驻的 Python 进程提供浏览器渲染(借助 patchright 执行 JavaScript)、CSS/XPath 结构化提取,以及自适应的自愈选择器——站点改了类名,选择器也不会就此失效。所有这些都跑在长生命周期的单个 Python 进程里,因为 Scrapling 的会话要保留 cookies,浏览器引擎要保留页面池,自适应模式还要保留 SQLite 指纹库,每次调用都起新进程会把这些积累全部丢掉。
插件的工具注册是条件式的:启动时探测当前环境实际能做什么,只注册那些确定能工作的工具。机器上没有浏览器时,渲染类工具不会出现在模型的工具列表里,模型不会把回合浪费在注定失败的调用上。它适合需要从 JavaScript 渲染页面、动态站点或结构化数据中提取信息的 dsh 使用者,尤其是愿意自备 Python 3.14+ 与 Scrapling 环境、并希望对抓取过程有精细控制的人。
截图预览


使用场景
- 从依赖 JavaScript 渲染的单页应用中提取数据
- 用 CSS/XPath 精准抓取动态站点中的结构化内容
- 在站点改版后仍稳定定位目标元素并继续抓取
适合人员
- 需要从动态网页抓取结构化数据的 dsh 用户
- 愿意自备 Python 与 Scrapling 环境的进阶使用者
- 希望对抓取过程和工具注册有精细控制的开发者
相关插件

DeepSeek Harness 社区「破甲」插件:84 条宿主补丁、25 层自检与侧栏整页设置,本机可见状态、快照回滚,减少确认打断,让 Agent 更连贯地辅助学习与动手实验。
DSH 服务化侧边栏框架,提供文件工作台、内嵌浏览器、真实终端、Git 面板等完整工作台,并开放服务供插件扩展。
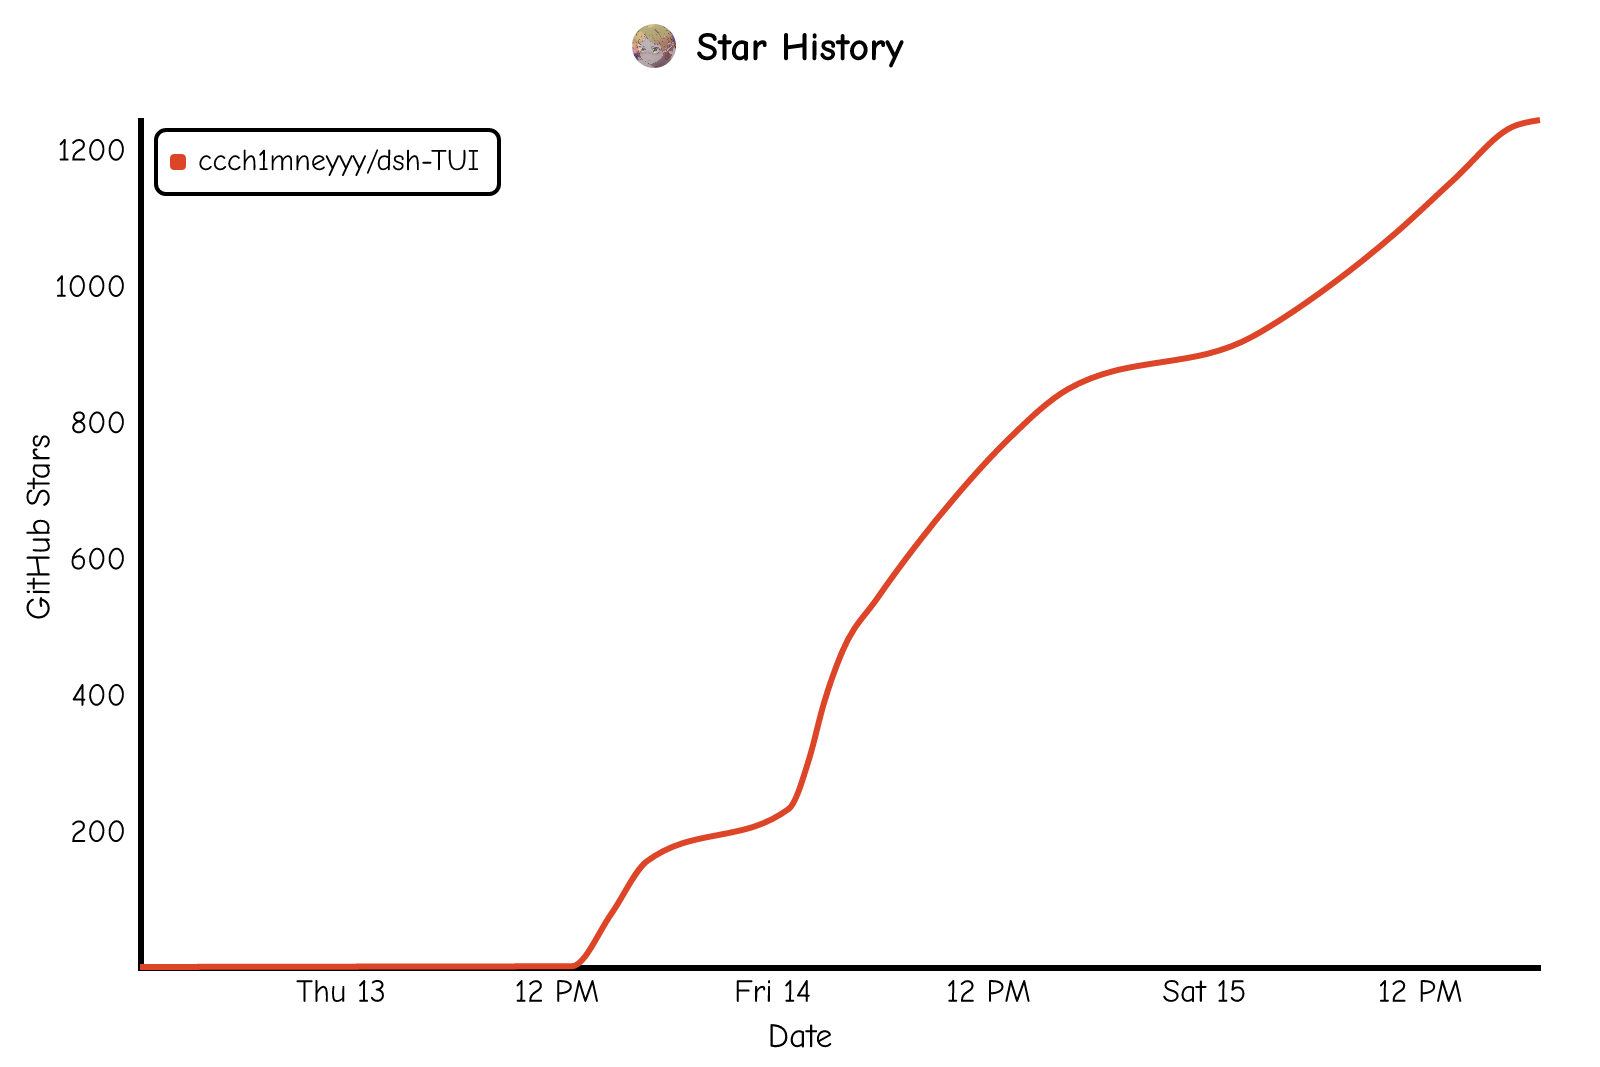
美观实用的 Claude Code 风格 TUI 插件:像素鲸鱼顶栏、流光大字、实时状态行、思考流式展开、时间回溯、上下文进度条与 TPS 仪表,零核心改动。
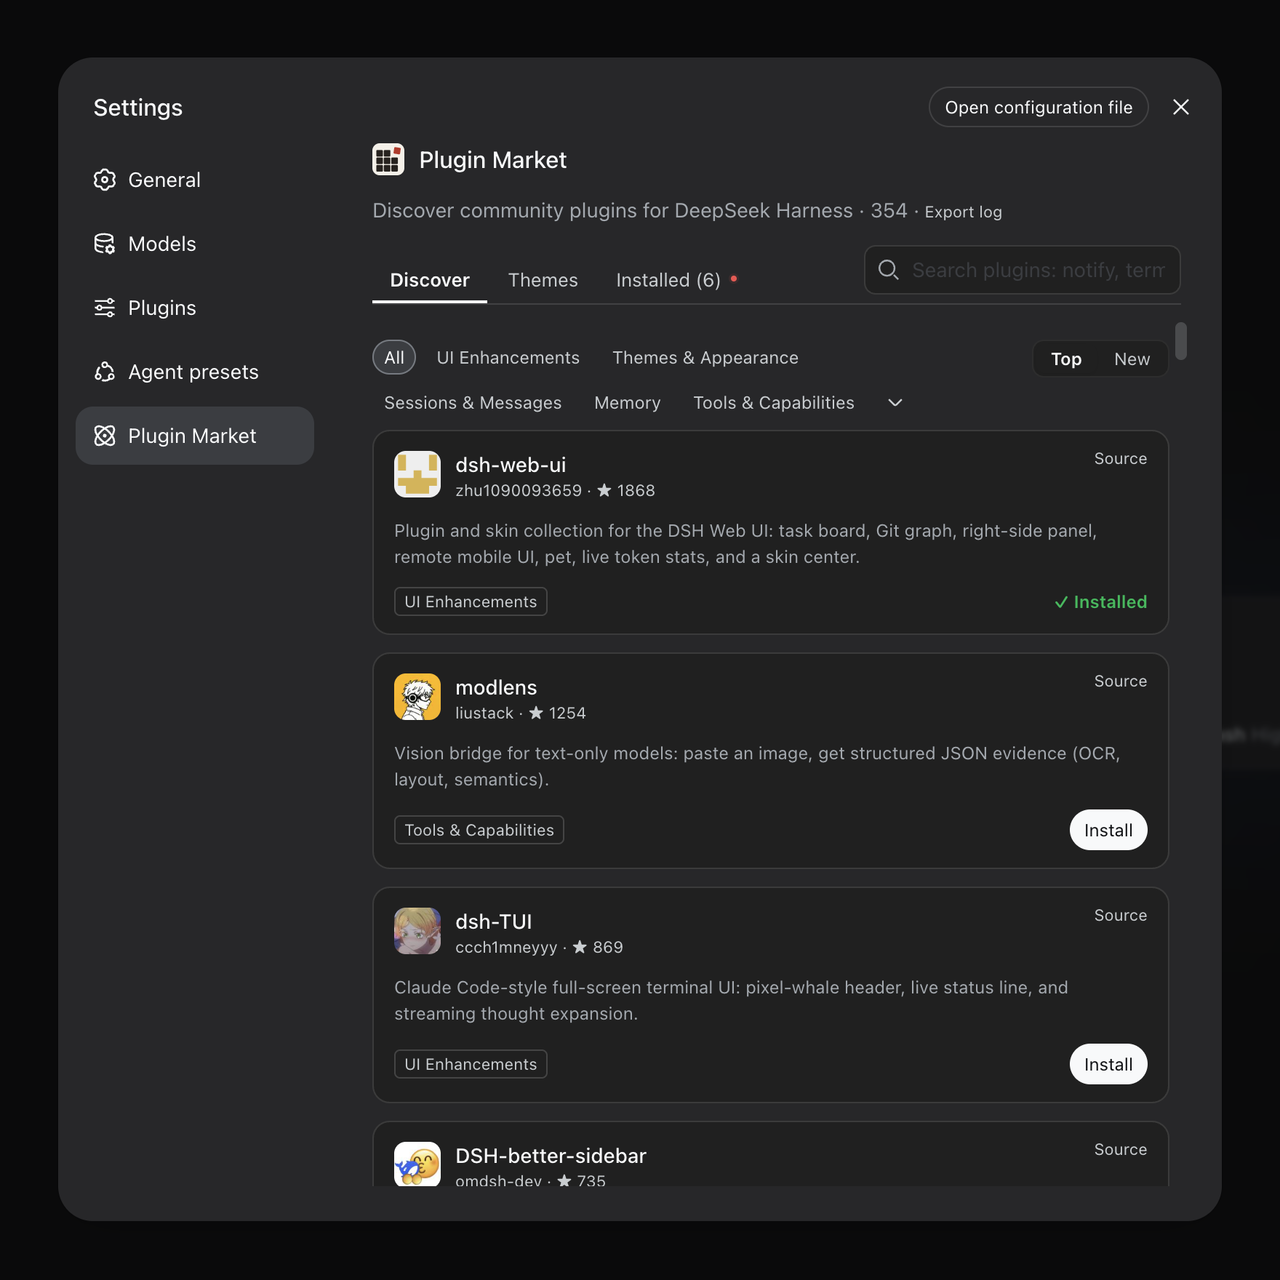
DeepSeek Harness 插件市场:浏览/搜索/一键安装社区插件与主题,支持更新、备份、热禁用、诊断与AI修复。