spa-api-extract
在终端中运行以下命令:
dsh plugin install sunwindy91/spa-api-extract
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install sunwindy91/spa-api-extract,即可从 https://github.com/sunwindy91/spa-api-extract 安装该技能插件。
插件介绍
很多现代站点用 React、Vue、Next 或 Nuxt 在浏览器里渲染,首屏 HTML 往往只是空壳或一大坨打包后的 JavaScript。用常规的网页抓取或 HTML 转 Markdown 时,常见结果是超时、正文读不出来,或只能看到混淆脚本——真正的数据其实在页面背后调用的 JSON API 里。
spa-api-extract 是一套面向 Agent 的操作指引:先确认「超时 / 仅 JS / 空壳」这类失败信号,再用 curl 探测页面骨架,在 HTML 与 JS 里用 grep 找 fetch、/api/ 等端点并推导 BASE 路径,然后带着 URL 里的鉴权参数(若有)以只读 GET 请求重建并调用 API,最后用 Python 查看结构、提取为 UTF-8 文件,并核对条数与字段是否完整。
它默认只读、不主动写接口;令牌视为敏感信息,不应出现在最终输出或日志里。适合需要在合规前提下抓取 SPA 数据的开发者、研究员,以及 harness 里 WebFetch 经常「抓不到真内容」的智能体场景。插件在 dsh 侧仅注册知识,加载时不发起网络请求。
使用场景
- 目标页为 React/Vue/Next 等客户端渲染,首屏 HTML 几乎没有正文
- WebFetch 超时或只返回打包 JS、空壳,需要从内部 JSON API 取数
- URL 带鉴权查询参数,需只读 GET 重建并调用真实数据接口
适合人员
- 在授权范围内抓取 SPA 数据的开发者与研究员
- Harness 里常规抓取经常失败的智能体编排者
- 需要 curl/grep/Python 流水线而非单纯 HTML 解析的运维与分析人员
相关插件
为 DeepSeek Harness 打造的免费联网搜索插件,支持网页搜索、X 搜索与页面抓取,免注册免 API Key,多引擎自动故障转移。

AnySearch 驱动的 DeepSeek Harness 联网插件,借助原生 web_search/web_fetch 实现实时搜索、内容清洗、垂直搜索与并发批量搜索,免 API key 快速开始。
Pixel-perfect 网页克隆工具,基于 agent harness 将任意网页克隆为可评分的 React 全页面副本。
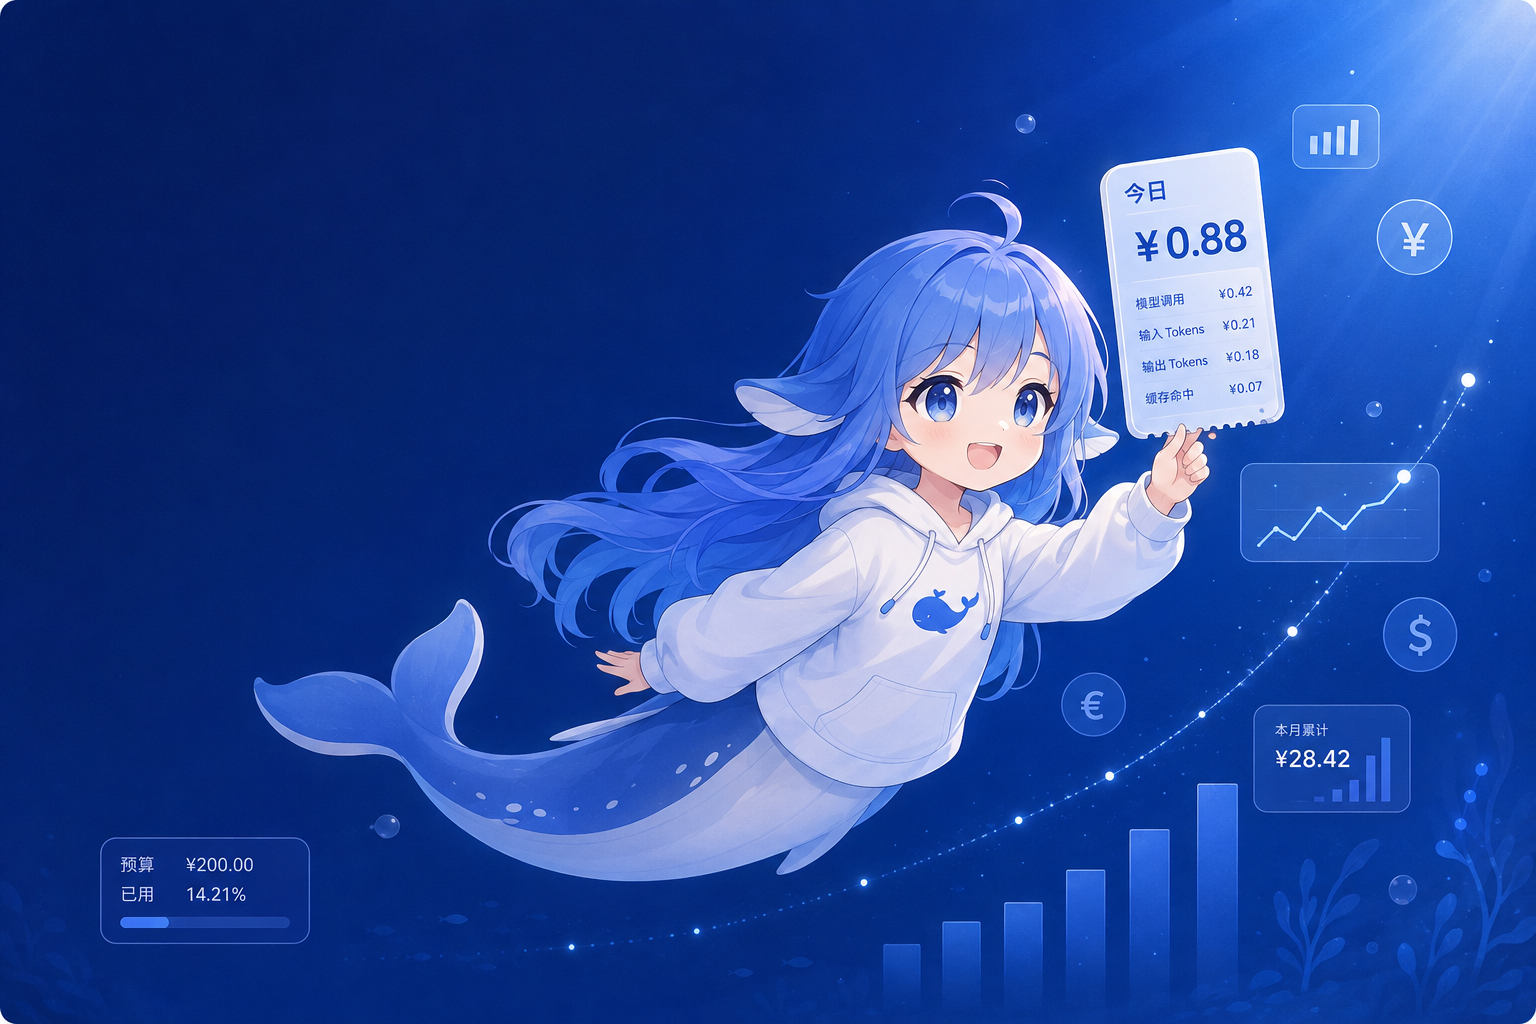
DeepSeek Harness 会话费用统计插件,中英双语界面,支持预算、官方与自定义 Provider 余额、OpenCode Go/Coding Plan 额度、峰谷计价与提醒、历史统计等。