dsh-voice-input
在终端中运行以下命令:
dsh plugin install moazzamak/dsh-voice-input
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install moazzamak/dsh-voice-input 安装本插件(源码:https://github.com/moazzamak/dsh-voice-input),安装后重启 DSH 并在 web 配置档下使用 Web GUI。
插件介绍
在 Web 界面里打字仍是多数人与 Agent 对话的主路径,但长指令、口述需求或边走边想时,键盘往往跟不上思路。更关键的是,许多语音方案会把音频送到云端,对本地部署与隐私敏感的场景并不友好。dsh-voice-input 面向 DeepSeek Harness 的聊天输入区,提供完全离线的本地听写:浏览器只负责录音,音频提交到本机 Harness 进程解码,识别结果追加到草稿里,由你自己检查后发送,不上传任何内容。
插件在输入框工具栏提供麦克风按钮:点按开始、再点结束,识别文本以空格追加到现有草稿,不会替你自动发送。模型只加载一次并保持热启动,后续录音主要承担解码开销;在默认 CPU 引擎上还可边说边出字——按静音切段做渐进识别,结束时再做整段转写与修正,减少半词被“补全”的错觉。转写过程中你仍可正常打字,已有内容会保留,实时文字插在其后。除界面外,同一引擎还以 voice_transcribe 工具形式供 CLI、SDK 或 ACP 会话转写本地音频文件。
识别之后可选“润色”:调用当前部署已选模型去掉口头禅、整理重复与标点,并尽量不改含义、不碰标识符与技术术语;失败或异常时会回退到原始识别文本。可在配置中关闭润色,或指定更轻量的模型路由,避免与主 Agent 抢大模型。默认 CPU(faster-whisper)渐进出字且无 GPU 常驻;需要时也可走 whisper.cpp Vulkan,便于在非 NVIDIA CUDA 环境下使用 GPU。
适合经常在 DSH Web GUI 里写长提示、希望口述指令又坚持数据不出本机的用户;也适合需要在无浏览器场景批量转写音频文件的集成与自动化流程。需已安装带 Web GUI 的 DSH、支持麦克风的 Chromium 系或 Firefox,以及用于一次性引擎准备的 Python 3.9+。
使用场景
- 在聊天输入框用麦克风口述长提示,再自行修改后发送
- 需要边说边看到草稿实时更新,减少等整段录完才出字
- 在无浏览器场景用 voice_transcribe 转写本地音频文件
适合人员
- 经常在 DSH Web GUI 与 Agent 对话、更习惯口述的用户
- 要求音频与文本不出本机、坚持本地推理的团队
- 需要在自动化流程中集成本地语音转写的开发者
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
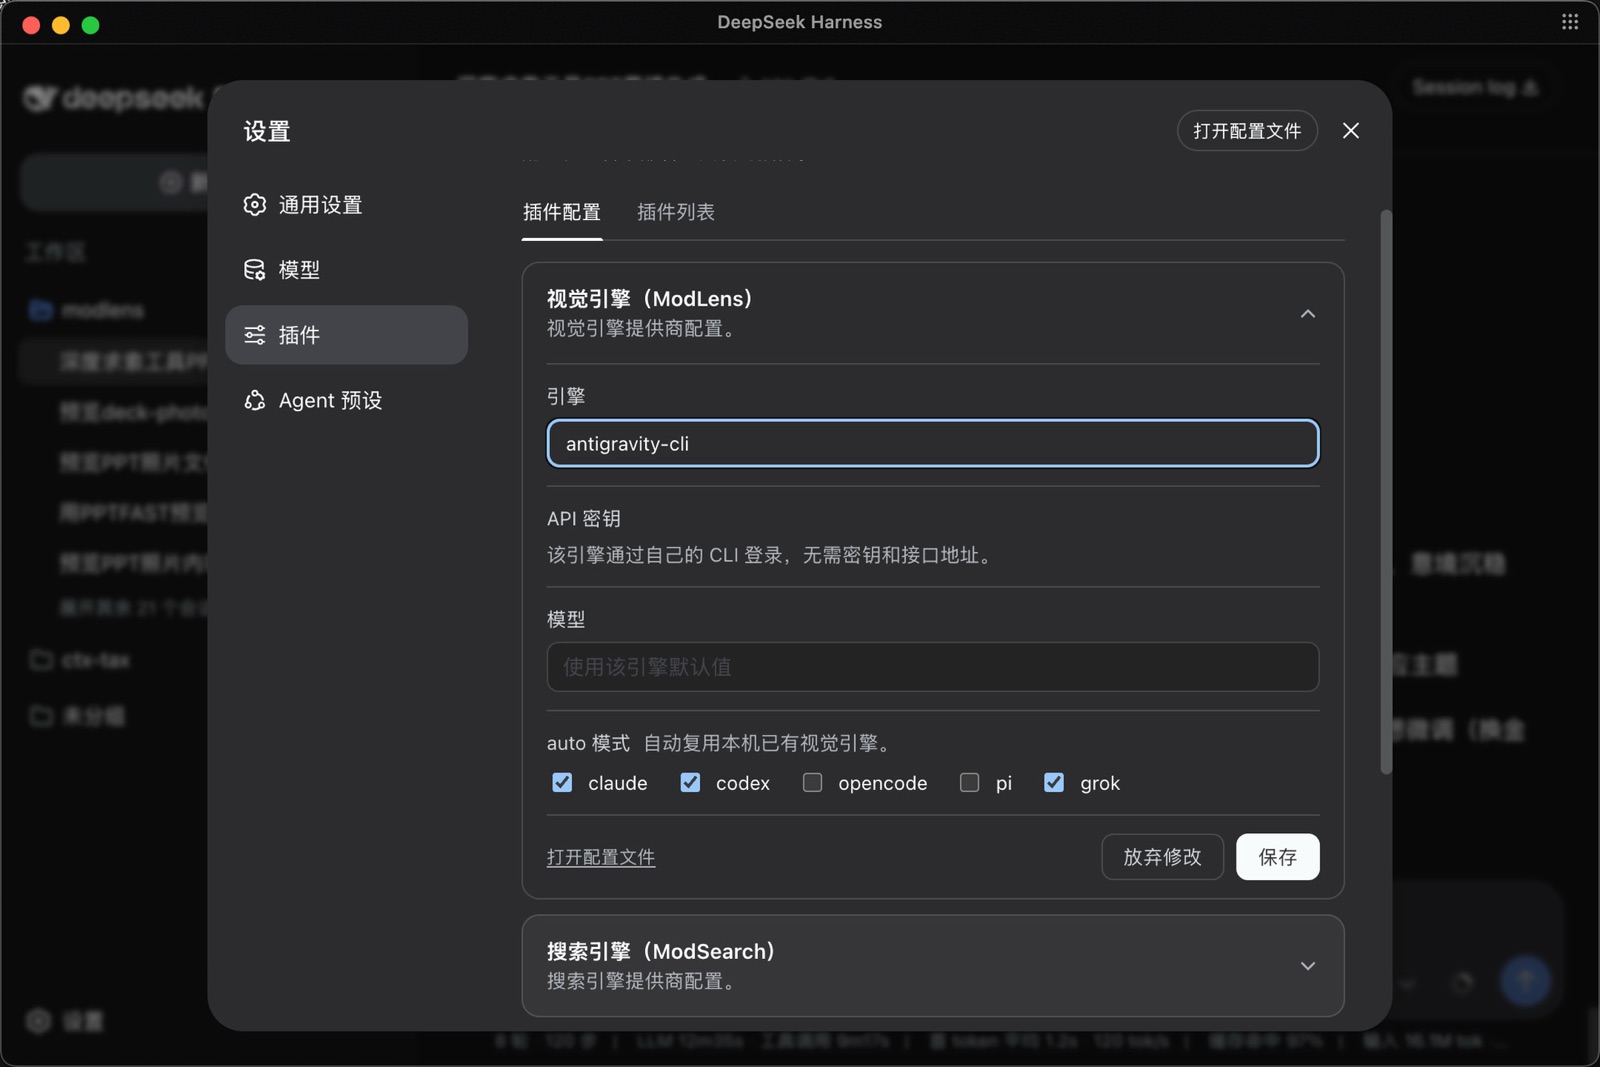
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
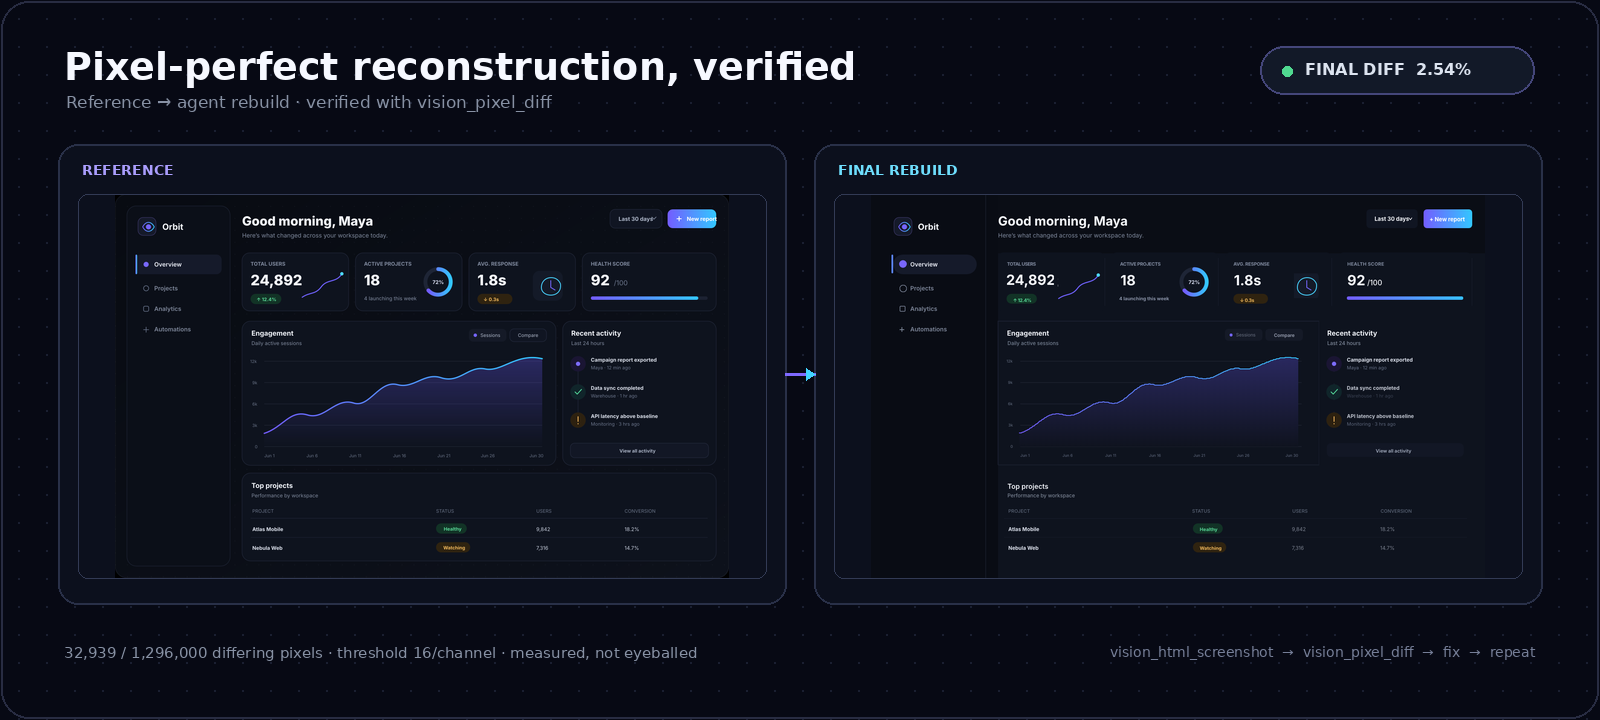
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。