dsh-tool-ocr
在终端中运行以下命令:
dsh plugin install yuehancn/dsh-tool-ocr
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install yuehancn/dsh-tool-ocr 安装本插件(源码:https://github.com/yuehancn/dsh-tool-ocr),装完后重启 dsh。
插件介绍
Agent 能顺畅读文本文件,却常常对发票截图、扫描合同或手机拍的表格束手无策——图里的字它只能猜。dsh-tool-ocr 把这一段补上:你把图片或 PDF 的绝对路径交给工具,插件先判断输入类型与 PDF 是否真有文字层,再选最快、最靠谱的路径把正文交回 Agent。
对带文字层的电子 PDF,插件用 poppler 直接抽取,不白跑 OCR;扫描件或图片型 PDF 会在文字层为空时栅格化页面,再调用你配置的 OCR 引擎;普通截图与照片则直接走 OCR。提供 ocr_read 完成读取与可选落盘,ocr_status 则在动手前探明本机哪些引擎可用,避免空等几十秒。返回里除 text 外还有 kind、engine、pages 与 note,方便 Agent 判断这次结果是否可信。
引擎由你在配置里定义:默认 native 只读 PDF 文字层;需要识图时改用 command 后端,tesseract、PaddleOCR 或公司内部 CLI 都能按 {input}、{output}、{lang} 约定接入。插件只读你指定的单个文件,不扫目录、不上传;OCR 以 spawn 调用本地命令,抽取文字仅写入 outputDir。
适合在桌面版或 Web 版 dsh 里经常让 Agent 处理票据、合同、报告扫描件的用户,以及希望 OCR 能力留在本机、按业务切换多套引擎的团队。
使用场景
- 让 Agent 读取发票或收据截图中的文字
- 从扫描合同或图片型 PDF 中抽取正文
- 在 OCR 前检查本机可用引擎与后端状态
适合人员
- 经常用 Agent 处理票据与扫描件的 dsh 用户
- 需要电子 PDF 与扫描件统一取字的工作流
- 希望 OCR 留在本机并可切换多套引擎的团队
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
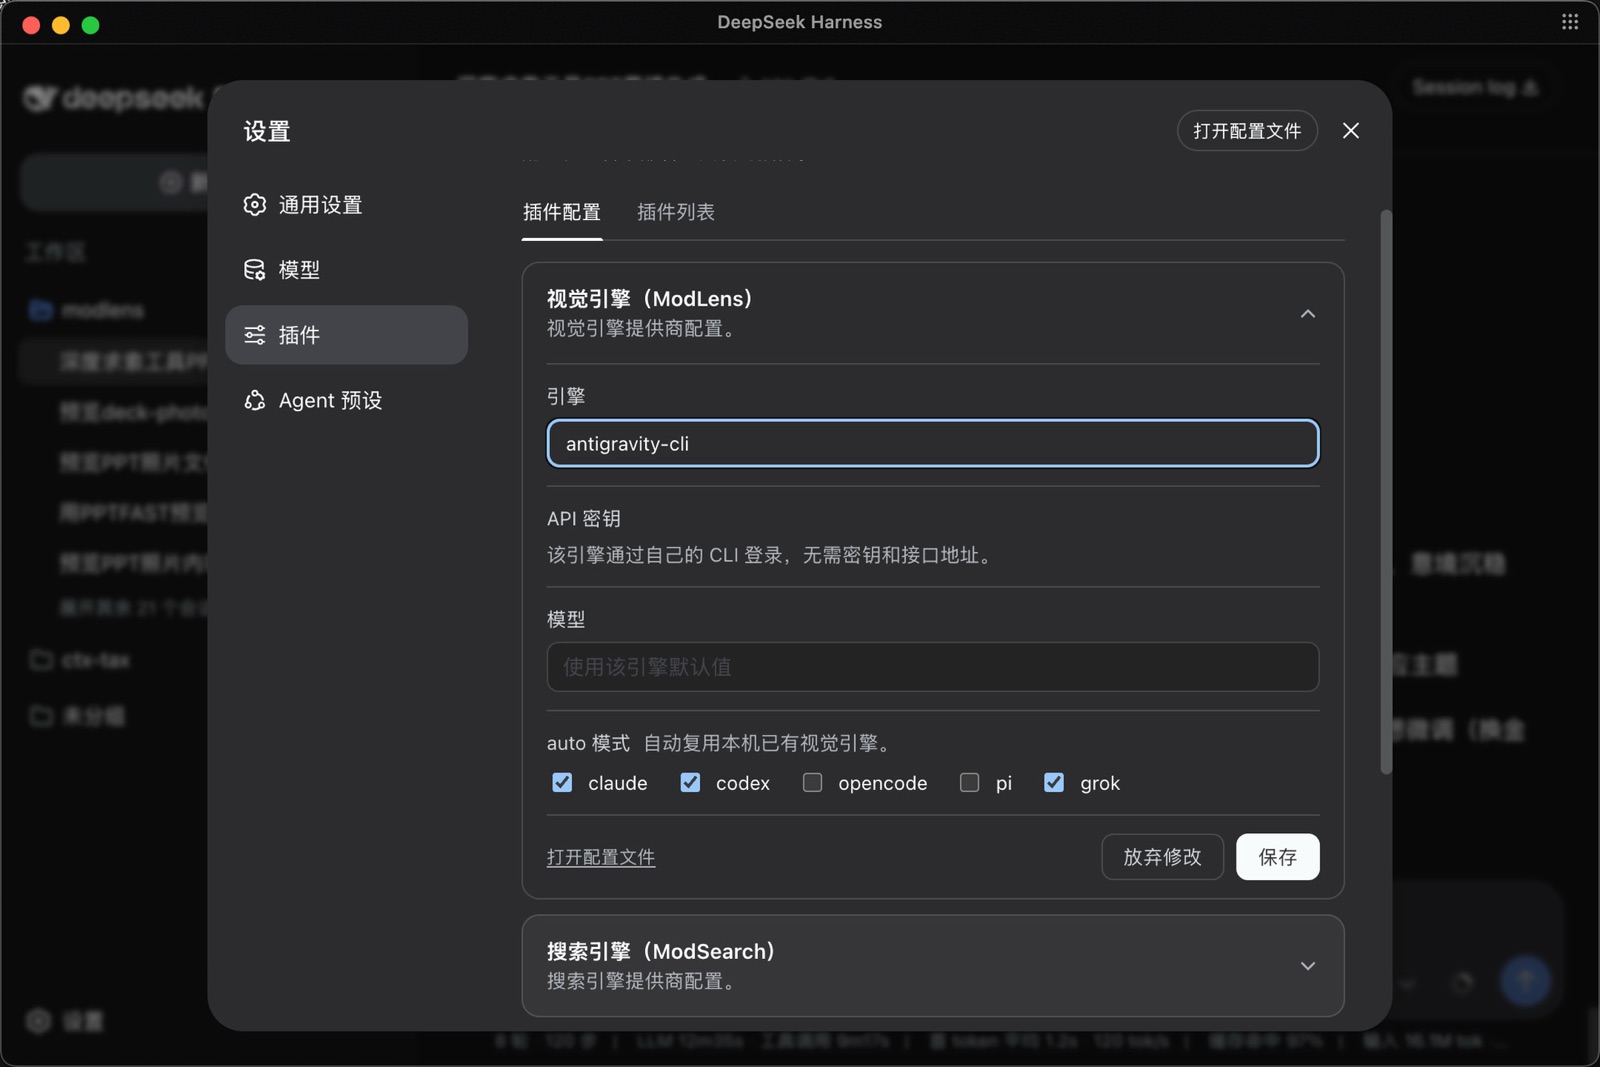
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
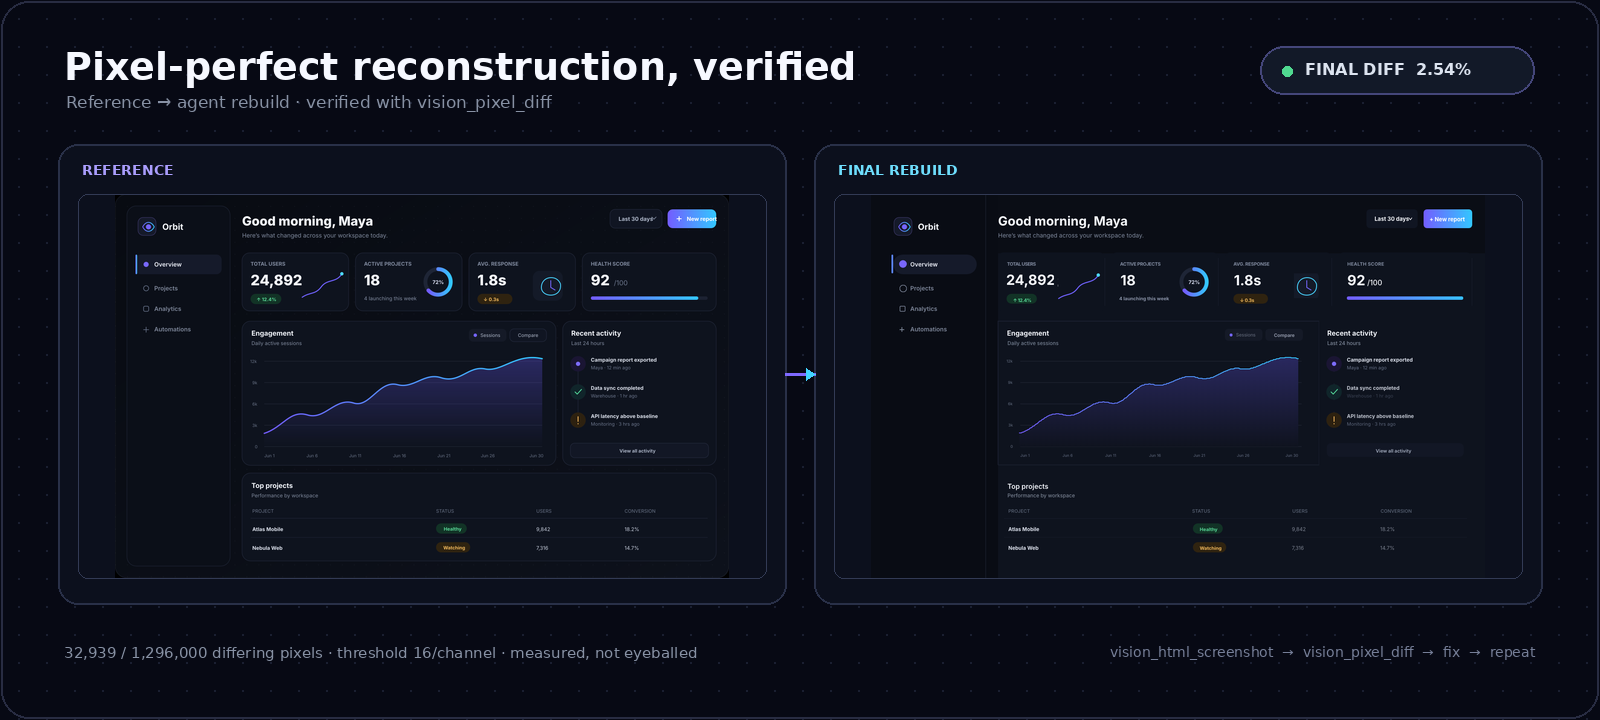
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。