dsh-model-deploy
在终端中运行以下命令:
dsh plugin install ethanrise/dsh-model-deploy
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中打开「插件 → 添加插件」,输入 https://github.com/ethanrise/dsh-model-deploy 或仓库路径 ethanrise/dsh-model-deploy,安装后重启 DSH 即可注册 model-deploy MCP 与技能。
插件介绍
选模型、调参、换框架之后,真正难回答的往往是:在我这台机器、这块 Jetson、那台远程工控机上,它能不能跑得动、延迟能不能接受?dsh-model-deploy 把这个问题落到可测量的部署基准上,而不是用纸面算力或别的机器上的经验值代替。
V0.1 围绕 ONNX 与 ONNX Runtime:先做静态检查(输入输出、形状、算子与参数量、动态输入等),再探测本机或目标机的 OS、CPU、内存、NVIDIA GPU、ORT 执行提供者与 SSH 能力。本地可跑预热与多轮推理,得到平均延迟、P50/P95/P99 与 FPS;对 Linux 工作站、Jetson 等 POSIX 目标,还可通过 SSH 无代理地把轻量 runner 与模型拷到临时目录执行、回收 JSON 并清理。结果会标明 ORT 实际使用的 provider,并在静默回退时给出 fallback 原因,避免把 CPU 数字误当成 GPU。
若你设定了最低 FPS、P95 上限或模型体积等约束,部署门禁会依据实测结果做校验。插件还提供 DSH/MCP 工具,方便在 Harness 工作流里串联检查、探测与基准,而不必每次手写脚本。
适合需要在真实硬件上验证 ONNX 推理表现的人:边缘设备与嵌入式(如 Jetson)、远程 Linux 工作站、以及要在上线前用同一套指标做「能不能过线」判断的开发者与 MLOps 工程师。TensorRT 构建、量化校准、Docker 执行器等能力有意留到后续版本。
使用场景
- 上线前在目标 Linux 或 Jetson 上实测 ONNX 延迟与 FPS
- 对比本机与远程工控机的 ORT 执行提供者与实测性能
- 用部署门禁校验是否满足最低 FPS 与 P95 延迟要求
适合人员
- 需要在真实硬件上验证 ONNX 推理是否达标的开发者
- 负责边缘与嵌入式部署的 MLOps 工程师
- 通过 SSH 管理远程 Linux 工作站的团队
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
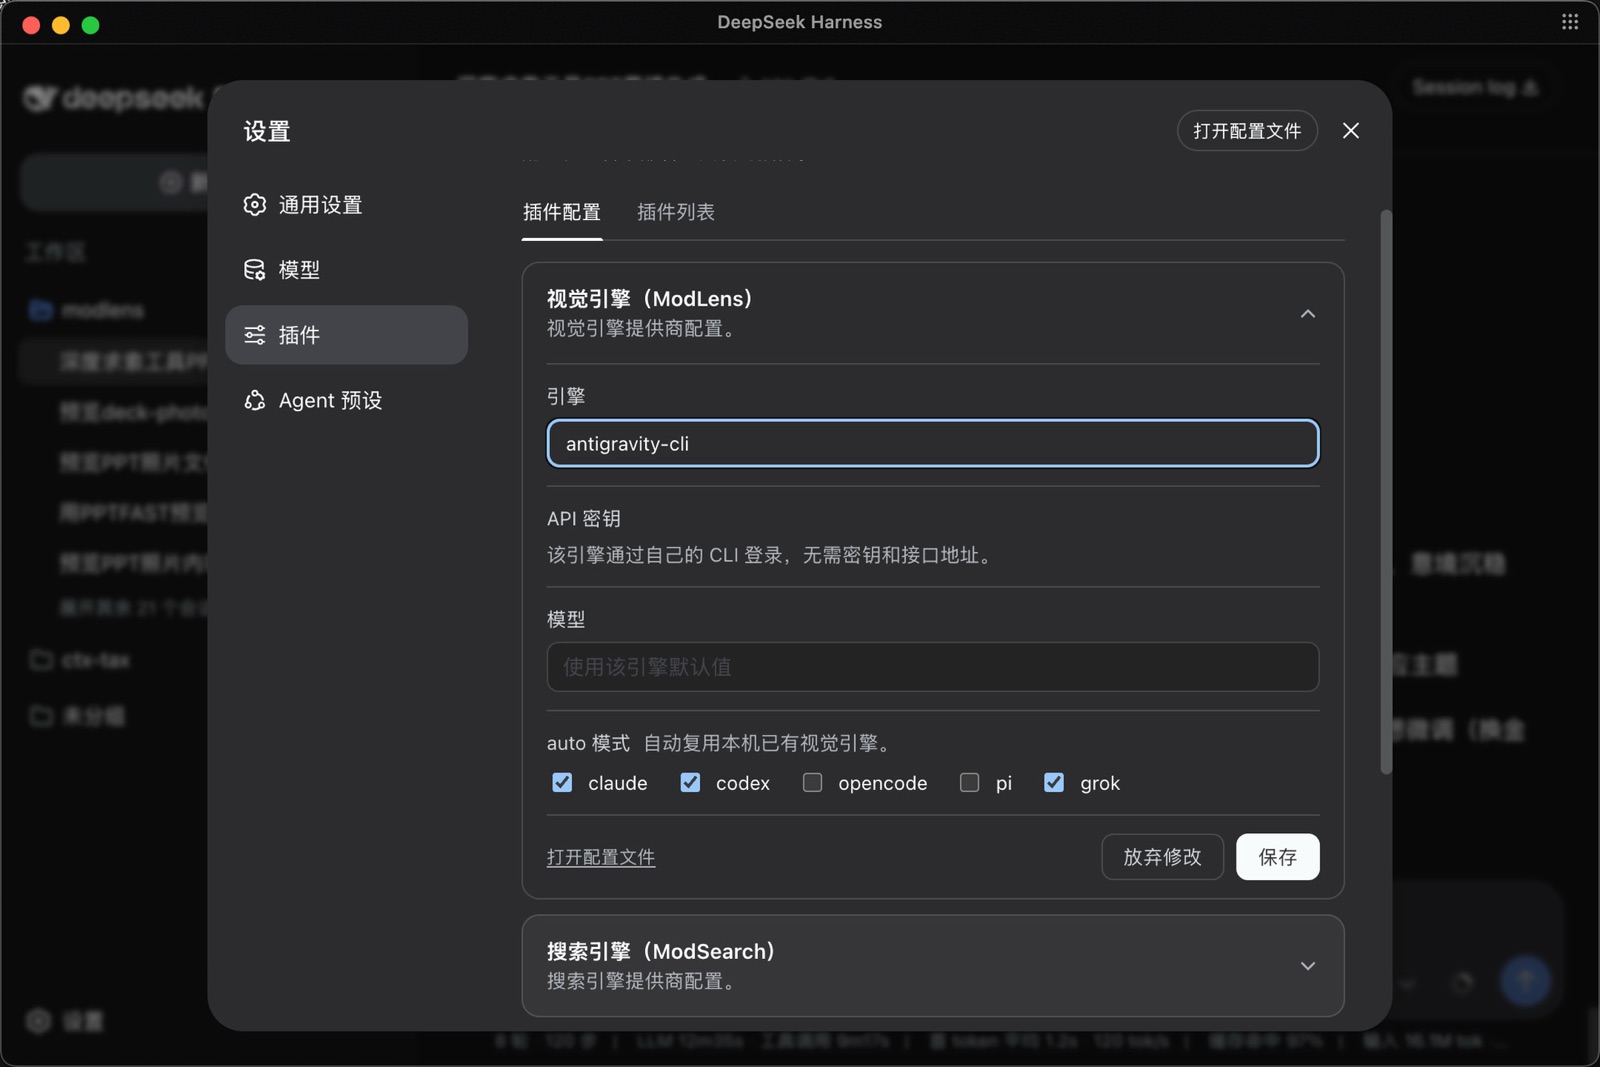
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
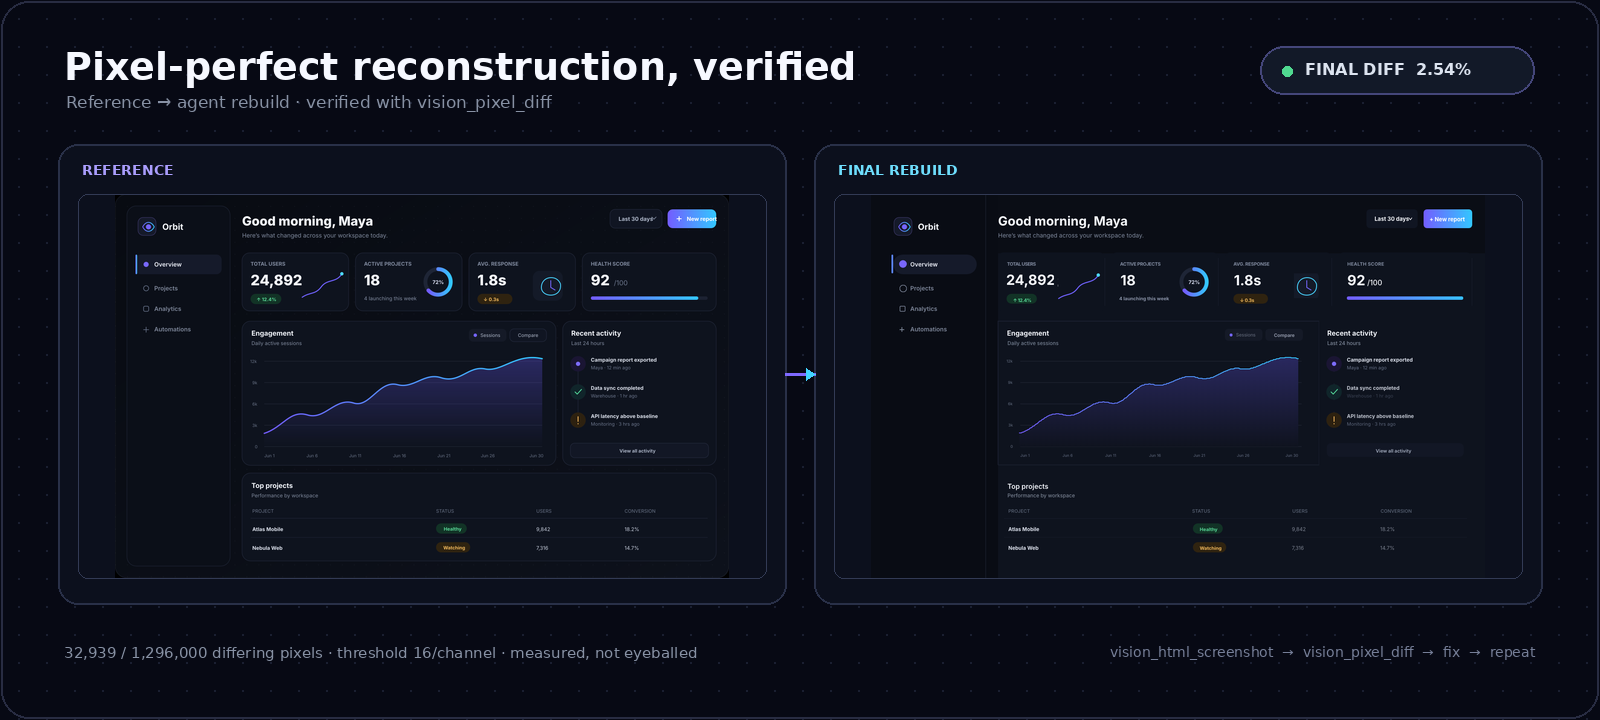
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。