dsh-compaction-effort-inherit
在终端中运行以下命令:
dsh plugin install rezon-aki/dsh-compaction-effort-inherit
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 侧栏打开「插件」→「添加插件」,粘贴仓库地址 https://github.com/rezon-aki/dsh-compaction-effort-inherit 安装,或在终端执行安装命令后重启 profile。
插件介绍
长对话在 DSH 里迟早会触发上下文压缩:官方 compaction-basic 会重放整段对话前缀去调摘要模型,本意是复用 provider 的 warm prefix cache。但它从会话请求头里只取了 provider 和 model,把 reasoningEffort 丢掉了;缺失的档位由 LLM 层用适配器默认值补上。对 DeepSeek 而言,前缀缓存按思考档位分桶——同前缀、同档位才能命中,会话跑在 max 时,每次压缩往往 cache_read 归零,整段上下文按未缓存价再付一遍。
dsh-compaction-effort-inherit 在 llm/stream 挂点上做一件事:当 purpose 为 compaction 时,从 session.requestHeader() 读出「上一个真正发出去的请求」所用的思考档位,并原地写回本次压缩调用的 options,让摘要请求与主对话落在同一缓存桶。非压缩请求在第一道判断就放行;监听体整体 fail-open,异常时直接放行,不阻断压缩。插件不 patch 官方 compaction、不写文件、不加工具,也不改摘要区间与保留策略。
适合在 DSH 里长期开高思考档位(尤其 max)、压缩频繁且关心输入 token 成本的用户。若会话档位本就与适配器默认一致,收益不明显;session-title 等强制 off 的路径也不在覆盖范围内。
使用场景
- 会话开在 max 或 high 且压缩较频繁
- 长对话触发 compaction 后输入 token 账单偏高
- 使用 DeepSeek 且希望压缩复用主对话前缀缓存
适合人员
- 在 DSH 里长期开高思考档位的开发者
- 关心压缩阶段输入费用的重度会话用户
- 已用官方 compaction-basic 且遇到缓存 miss 的用户
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
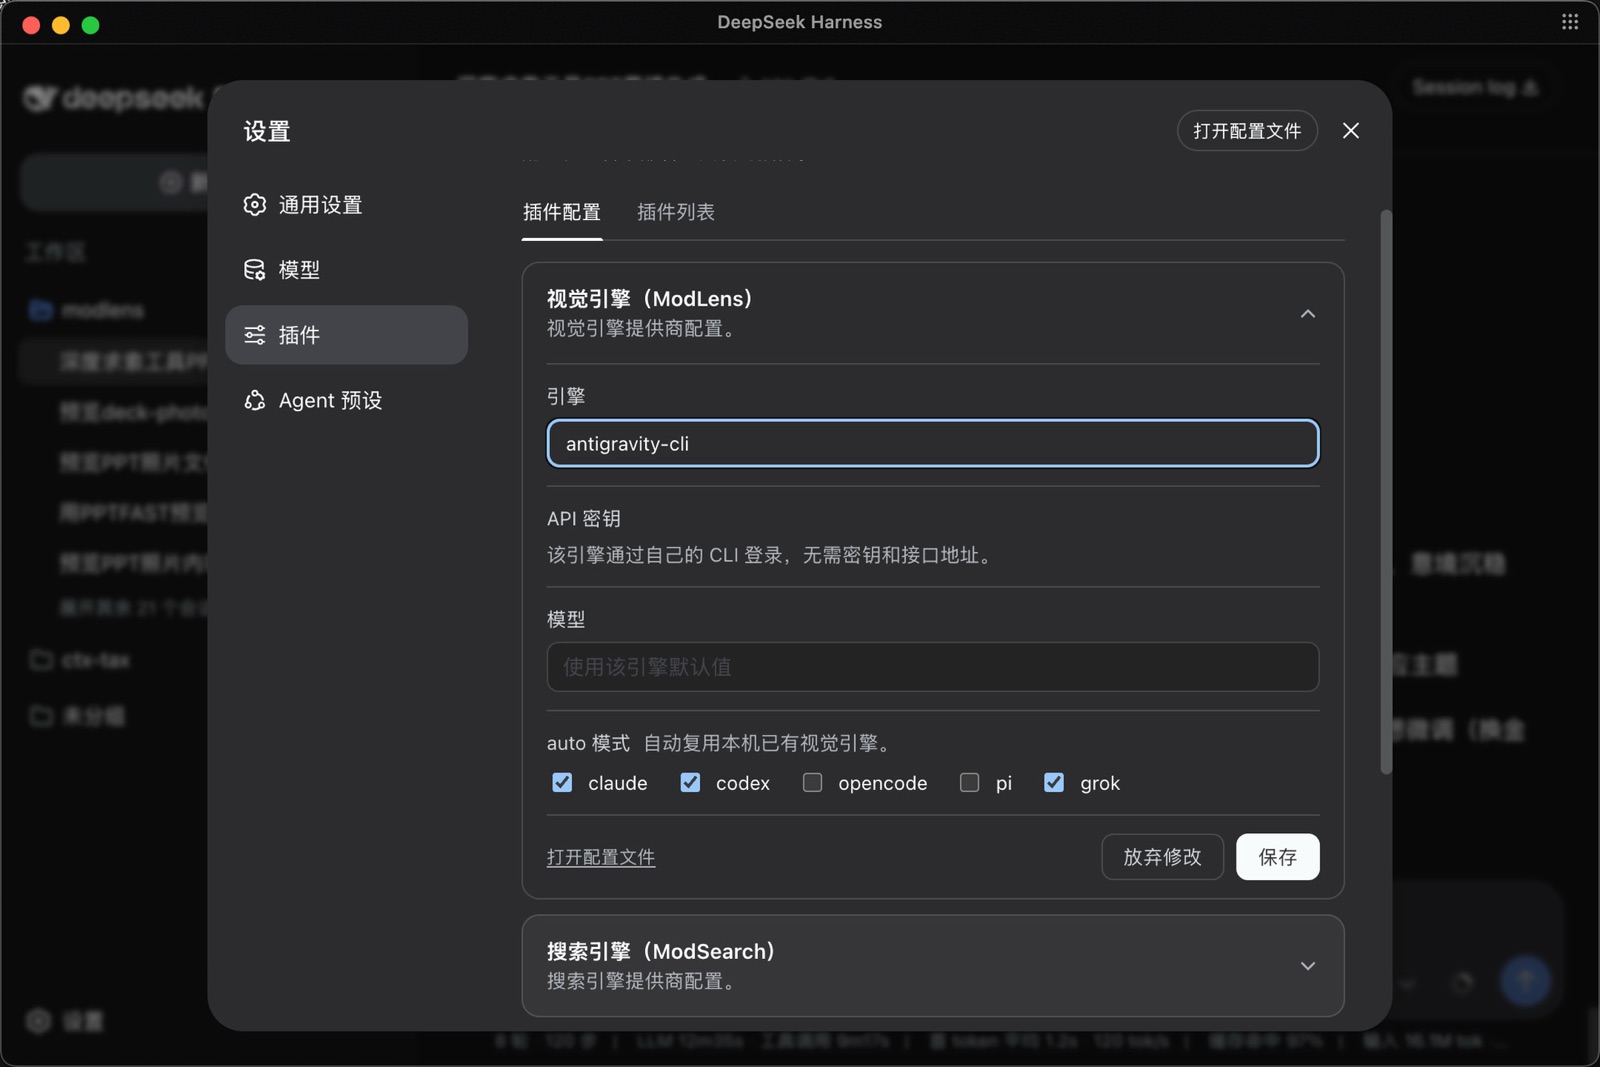
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
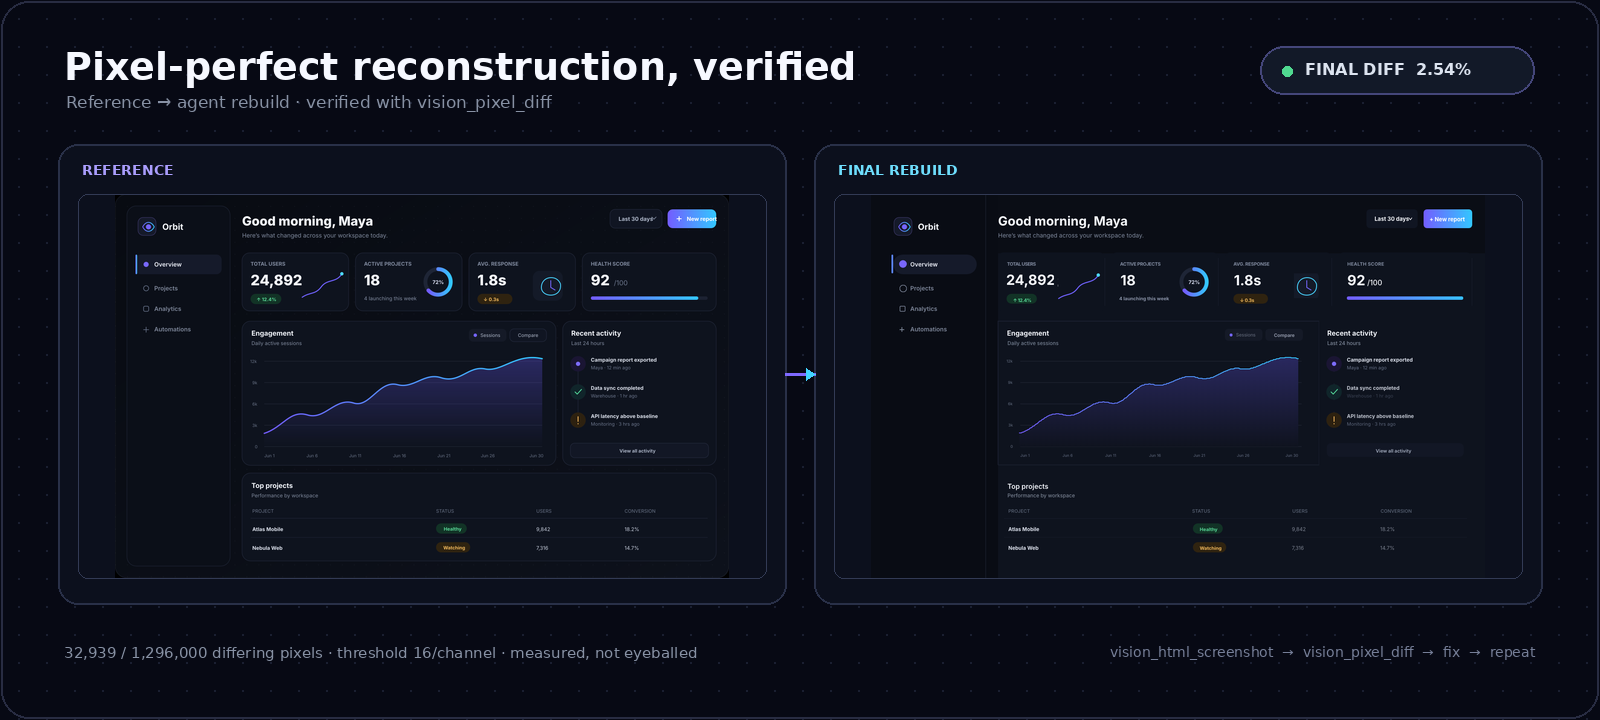
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。