dsh-voice-transcribe
在终端中运行以下命令:
dsh plugin install JackZo400/dsh-voice-transcribe
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install JackZo400/dsh-voice-transcribe,即可从 https://github.com/JackZo400/dsh-voice-transcribe 安装该插件。
插件介绍
在中文 IM 生态里,把别人发来的 QQ 或微信语音变成可用文字,麻烦往往不在「调一个 ASR 模型」,而在格式与文件头:扩展名写着 .amr 的其实是 SILK,常见 ffmpeg 解不了,QQ 落盘文件还常在最前面多一个字节。dsh-voice-transcribe 把这些前置步骤和转写串成一条本地流水线,让 DeepSeek Harness 里的 Agent 能直接「听懂」你交给它的音频或视频文件。
转写引擎固定为 SenseVoice(sherpa-onnx 跑 int8 ONNX),全程在本机完成,不调用云端 API。README 里的对比很直白:同一条短群语音上,SenseVoice 速度与体积都更友好,且在实测样例上与 QQ 官方转写一致;whisper 路径已从插件里拿掉,避免误以为还能切换。SILK 侧用纯 Python 的 pilk 解成 PCM 再封 WAV,顺带处理 QQ 的 0x02/0x03 前缀;非 SILK 的音频和视频则依赖系统里的 ffmpeg 抽音轨再转写。
在 dsh 里,Agent 会多一个 transcribe_media 工具,可对单个或多个本地文件批量转写(模型只加载一次)。专有名词没有 whisper 式的词表提示,只能靠可选的 fix 纠错表在结果上做替换——表要你自己维护,长词写在前面。超过约 28 秒的长音频会在相对安静处切片再拼接,纯静音或纯音乐不保证一定是空串,这些局限 README 都写明了。
更适合谁?你要的是对着电脑说话的实时输入,README 建议去看更成熟的 voice-input 类插件。这份专做「别人在 QQ/微信里发来的语音文件」:个人号机器人路线(OneBot:NapCat、Lagrange、SnowLuma 等)往往没有平台自带的 asr_refer_text,才需要本地 SILK 解码加转写;官方 QQ 机器人路线通常不必装这一套。只接受本地路径,不提供 URL 下载,也少一个 SSRF 面。
使用场景
- 把 QQ/微信发来的 SILK 语音转成文字供 Agent 理解
- 批量转写本地音频或视频音轨,模型只加载一次
- 个人号 OneBot 机器人处理群友语音消息
适合人员
- 使用 NapCat/Lagrange 等个人号 QQ 机器人的 dsh 用户
- 需要本地 ASR、不想为转写付 API 费用的开发者
- 经常处理中文 IM 语音文件格式的运维或插件作者
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
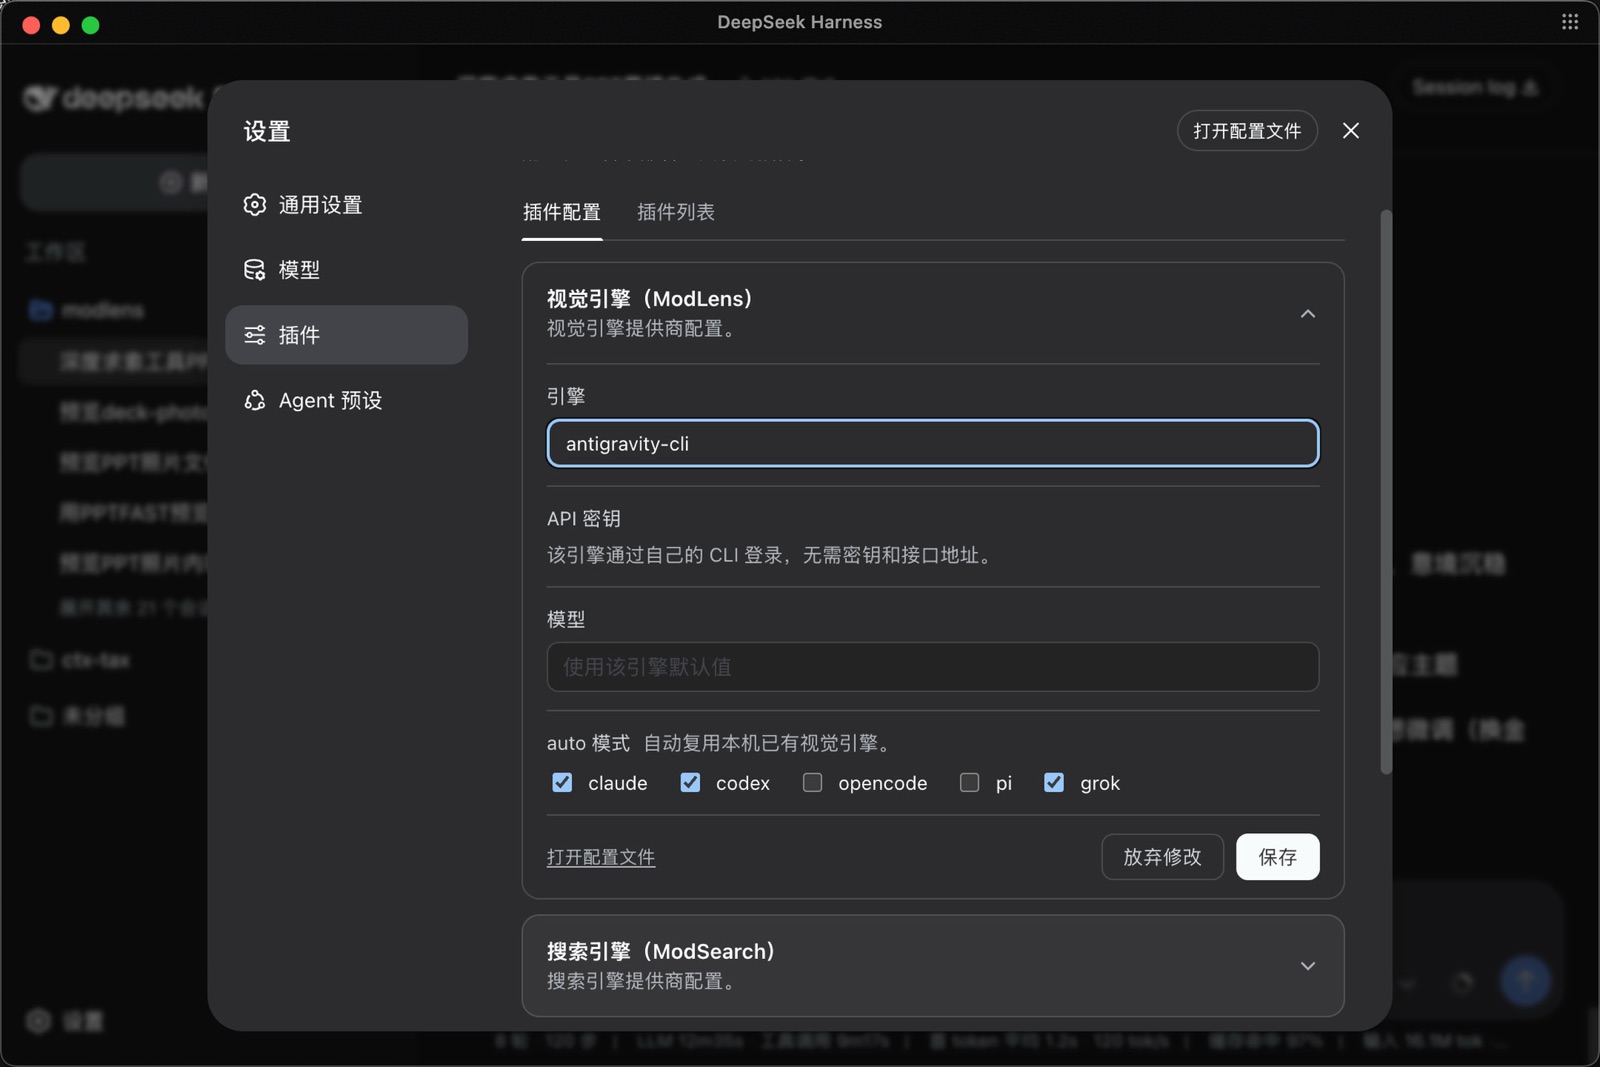
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
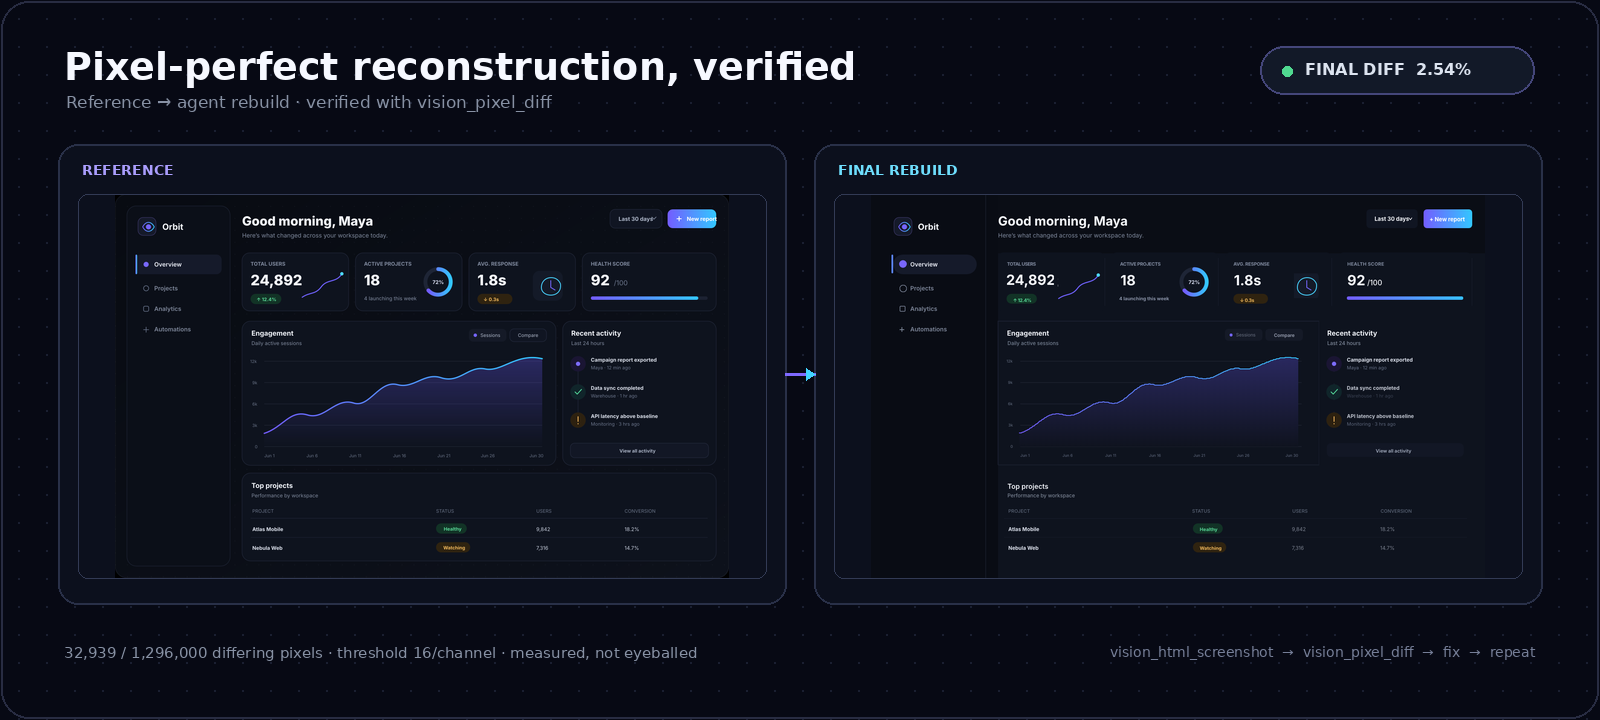
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。