dsh-llm-fidelity
在终端中运行以下命令:
dsh plugin install philipho01/dsh-llm-fidelity
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中运行 dsh plugin install philipho01/dsh-llm-fidelity,或从 https://github.com/philipho01/dsh-llm-fidelity 安装后在插件设置中启用。
插件介绍
把 Agent 接到第三方模型或网关时,任务进行到一半却因某个可选参数被拒而整轮对话中断,是很多人踩过的坑:temperature、max_tokens、reasoning effort、stop 等各家说法不一,换一家提供商往往又要重来一遍。更隐蔽的是用量统计:流式结束时网关送来全零快照把真实数字抹掉,或同一帧被记两次,看板与账单对不上却说不清差在哪。
dsh-llm-fidelity 挂在每条 LLM 请求的 llm/stream 通路上,在毫秒级内根据服务商返回的明确错误信息修正被拒绝的可选标量并重发,同一次请求内完成,你通常只会觉得回答在继续。插件会按「提供商 + 模型」在进程内记住约一小时的偏好,同一路径上同类错误至多遇到一次。用量侧则逐帧守护统计:后续帧不能抹掉先前已上报的字段,全零占位不能覆盖真实合计,重复快照不会双计;未上报的数字绝不捏造。
设计上只动可选参数(温度、推理强度、stop、maxTokens 等),不碰消息、系统提示、工具与约束;上下文溢出、配额、鉴权与网络问题照常透传。不注册模型路由、不替换官方或社区适配器,与 dsh-llm-retry 等分工明确——429 与 5xx 留给重试插件,参数类 400/422 由本插件处理。
适合在 DeepSeek Harness 里用多种 OpenAI 兼容网关、Azure、LiteLLM 等跑编码 Agent 的开发者与团队:默认开箱即用,需要时再在配置里开关用量守护、参数自适应与学习缓存等行为。
使用场景
- Agent 因 temperature 或 max_tokens 被拒导致整轮失败
- 用量看板被全零快照抹掉或与账单不一致
- 切换 LiteLLM、Azure 等兼容网关时反复踩参数差异
适合人员
- 在 DSH 上对接多家 OpenAI 兼容模型的开发者
- 需要可信 token 用量对账的团队
- 不想为每个网关手写参数映射的 Agent 用户
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
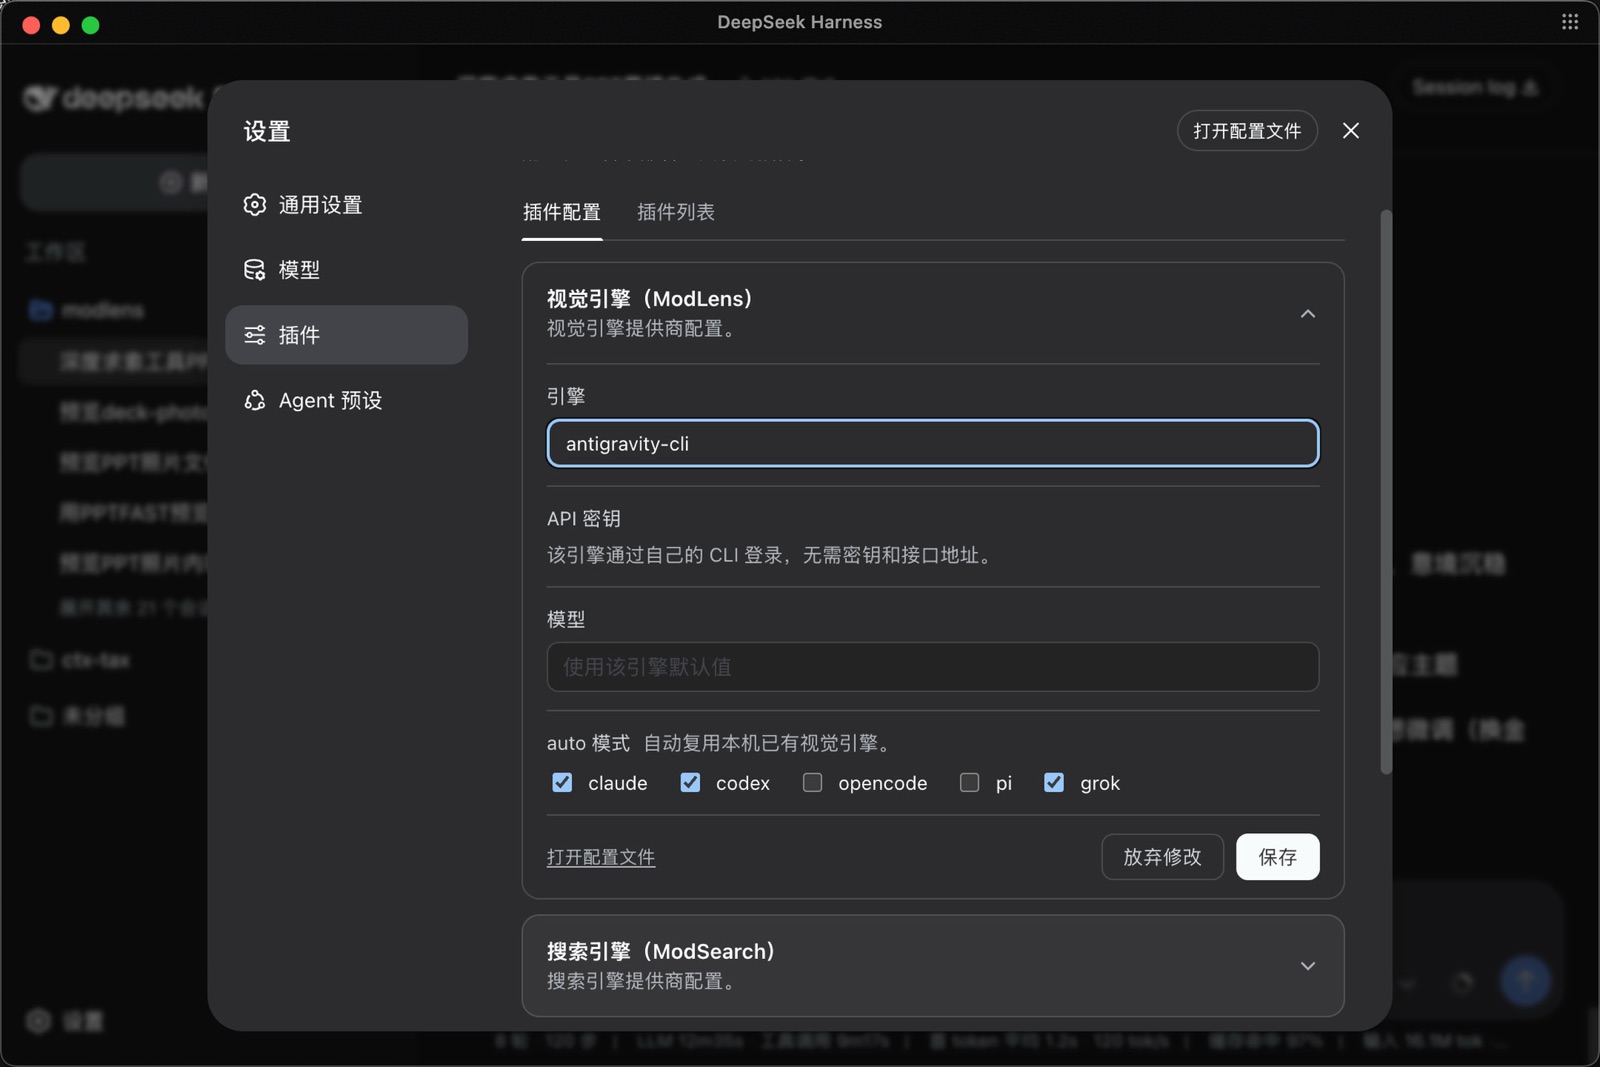
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
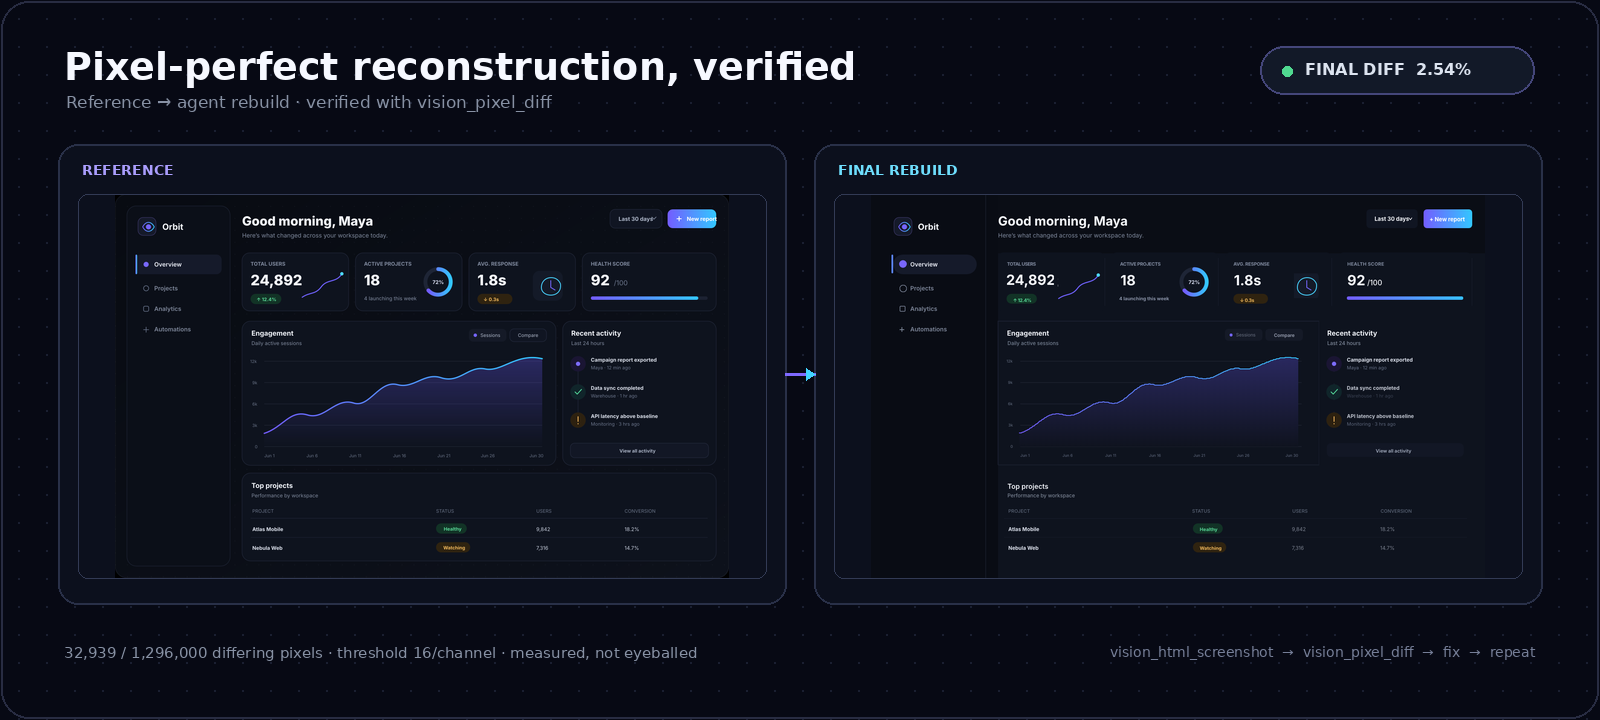
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。