dsh-context-compressor
在终端中运行以下命令:
dsh plugin install AllShadowAnan/dsh-context-compressor
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install AllShadowAnan/dsh-context-compressor 安装本插件;源码仓库为 https://github.com/AllShadowAnan/dsh-context-compressor。
插件介绍
DeepSeek Harness 会在对话变长时自动压缩上下文,但内置策略是固定的:大约在当前模型声明窗口的 80% 处触发,并保留约 16% 的原文尾部。对多数日常会话这很合理,却没法按你的预算、路由或端点特性把「那条线」画在自己想要的位置。
dsh-context-compressor 是外置 profile 插件,在 Harness 原有压缩能力之上增加可配置的触发条件,二选一:绝对 token 上限,或占模型上下文窗口的比例。达到条件后仍走同一套压缩流程——先尝试截短超预算的工具结果,再对更早的历史做区域摘要,并尽量保留最近一段原文。插件自带「设置 → 上下文压缩」页面,偏好写在界面里即可;总开关关闭时,行为与安装前一致,仍只由内置相对阈值驱动。
适合需要控制成本与延迟上限、同一会话可能路由到窗口差异很大的模型、或第三方与自建端点窗口声明不可靠的用户。也想在「更早压缩省 token」与「更晚压缩少丢上下文」之间微调比例的人,会用它替代写死的 80%。设置页还提供实时读数,便于对照当前阈值、会话估算 token 与最近压缩结果。
使用场景
- 需要为单次会话设定绝对 token 上限以控制成本与延迟
- 同一会话可能路由到上下文窗口差异很大的模型
- 第三方或自建端点的声明窗口不可靠,想用固定上限兜底
适合人员
- 希望微调压缩时机、而非接受固定 80% 阈值的用户
- 在多模型混合路由下需要稳定触发线的团队
- 通过设置页管理偏好、不想改配置文件的 Harness 用户
相关插件
为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
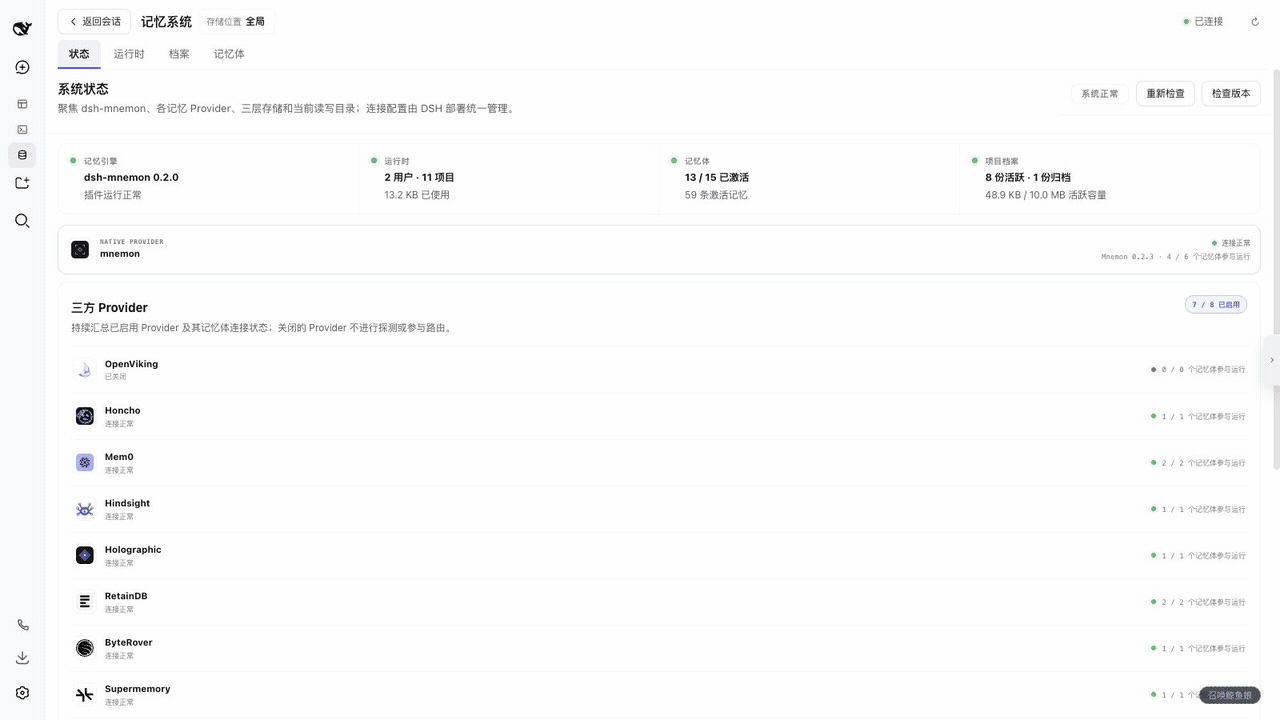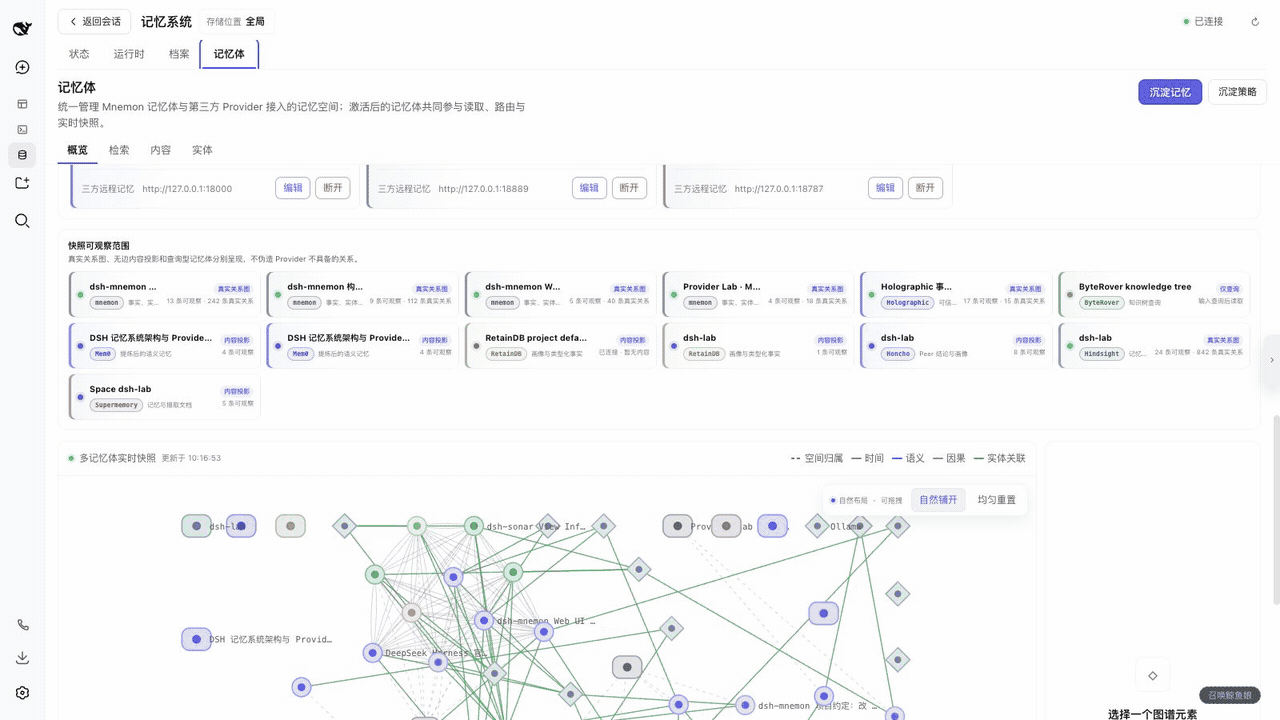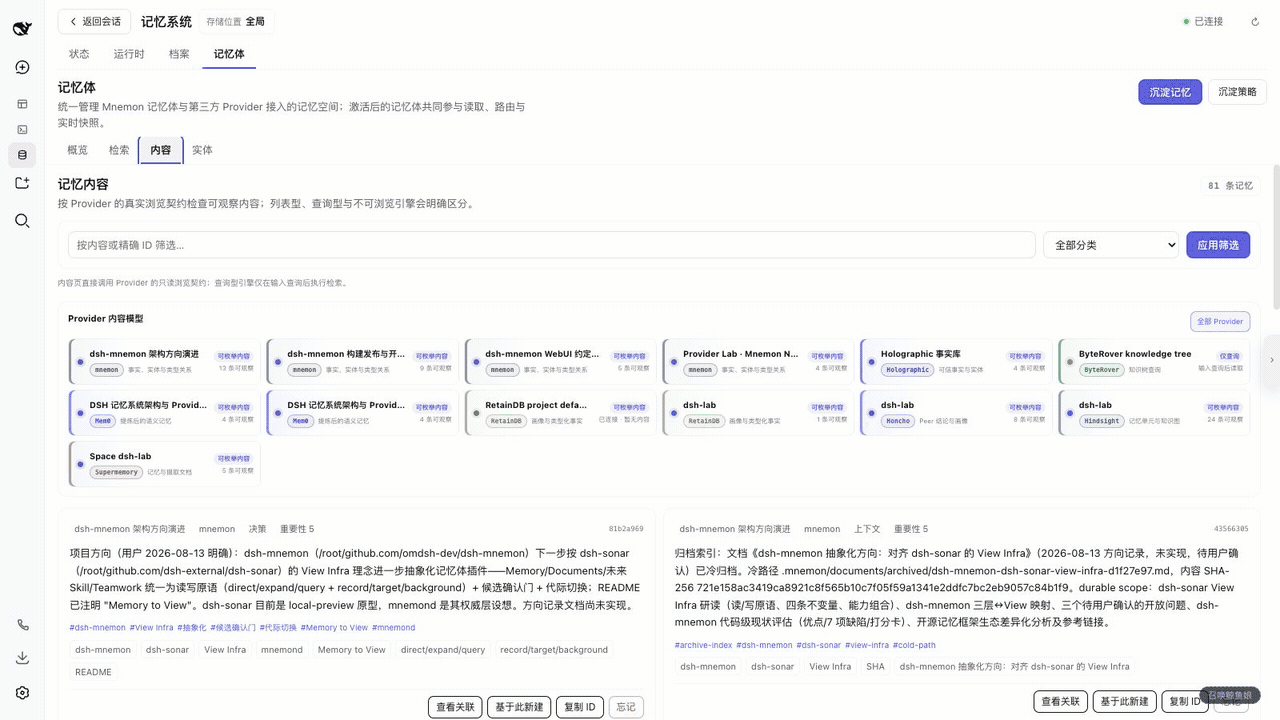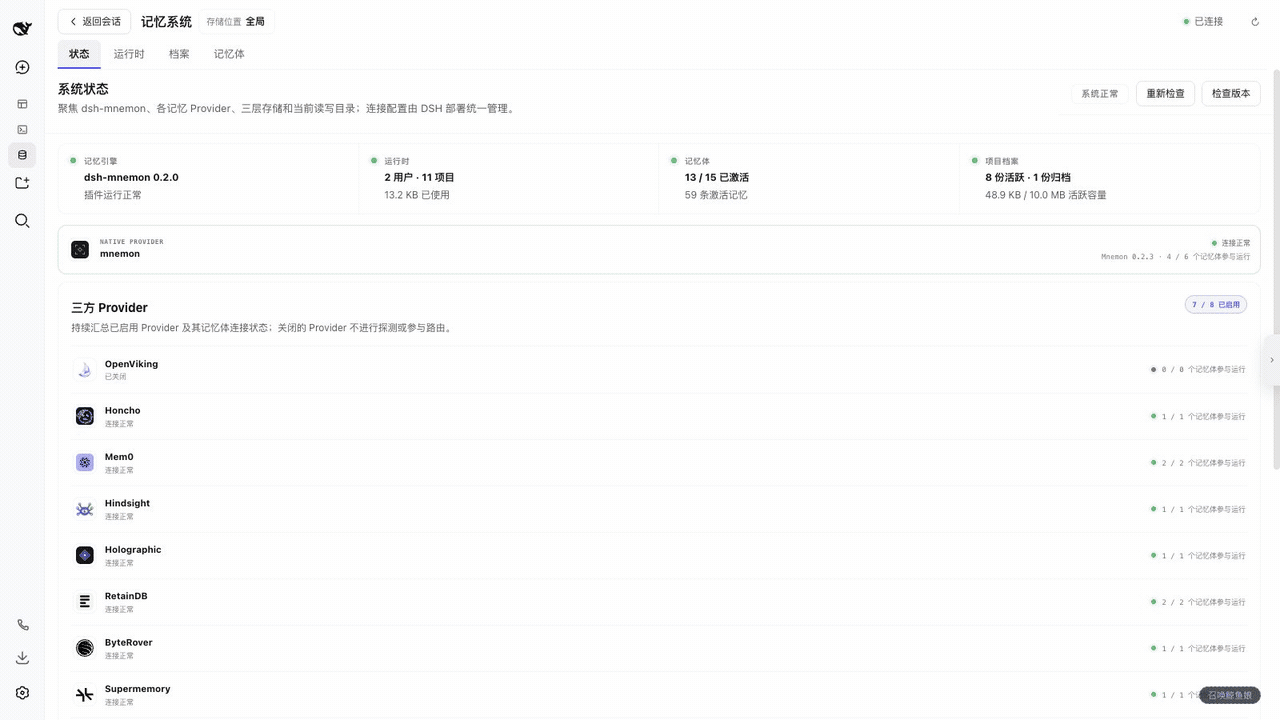
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。