dsh-llm-multimodal
在终端中运行以下命令:
dsh plugin install xiaokaizhou/dsh-llm-multimodal
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install xiaokaizhou/dsh-llm-multimodal,即可从 https://github.com/xiaokaizhou/dsh-llm-multimodal 安装该多模态生成插件。
插件介绍
在 DSH 对话里做创作时,文本、出图、出片、看图问答、配音和配乐往往要换不同工具或手写 API,模型与协议也容易对不上。dsh-llm-multimodal 把六类能力收进同一套聊天工具:generate_text、generate_image、generate_video、generate_vision、generate_tts、generate_music,多数模态走 OpenAI 兼容端点,文本则走 harness 的 LlmRuntime,由你在「设置 > 模型」里配置的网关统一承接。
插件会从 llm-pi-ai 设置里按模型 id 关键词自动识别可用模型,对话中描述需求即可调用,无需为每个工具单独维护模型列表。图像与视频覆盖常见 OpenAI 风格生成接口;视觉理解支持多图输入与本地路径自动转换;语音与音乐按模态分离选型,并可在支持时做参考音频音色克隆。若搭配 dsh-media-studio,生成物可默认写入活跃项目的素材目录并带回画布信息,配合 media-preview 在聊天里预览本地媒体。
适合已在 DSH 里配置多模态或 OpenAI 兼容网关的创作者、产品与设计同学,以及希望在同一对话流里完成「生成 → 落盘编排 → 预览」的团队。当前版本通过 llm-pi-ai 发现模型,视频任务采用轮询且等待时间较长,需确保所用 provider 支持对应兼容接口。
使用场景
- 在对话里用自然语言生成文案、配图或短视频草稿
- 上传图片或本地路径,让模型做视觉理解与问答
- 需要配音、BGM 或音效时,在同一聊天流里调用语音与音乐工具
适合人员
- 已在 DSH 配置 llm-pi-ai 与 OpenAI 兼容网关的用户
- 希望在对话中完成图文影音创作的内容创作者
- 使用 dsh-media-studio 做素材落盘与画布编排的团队
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
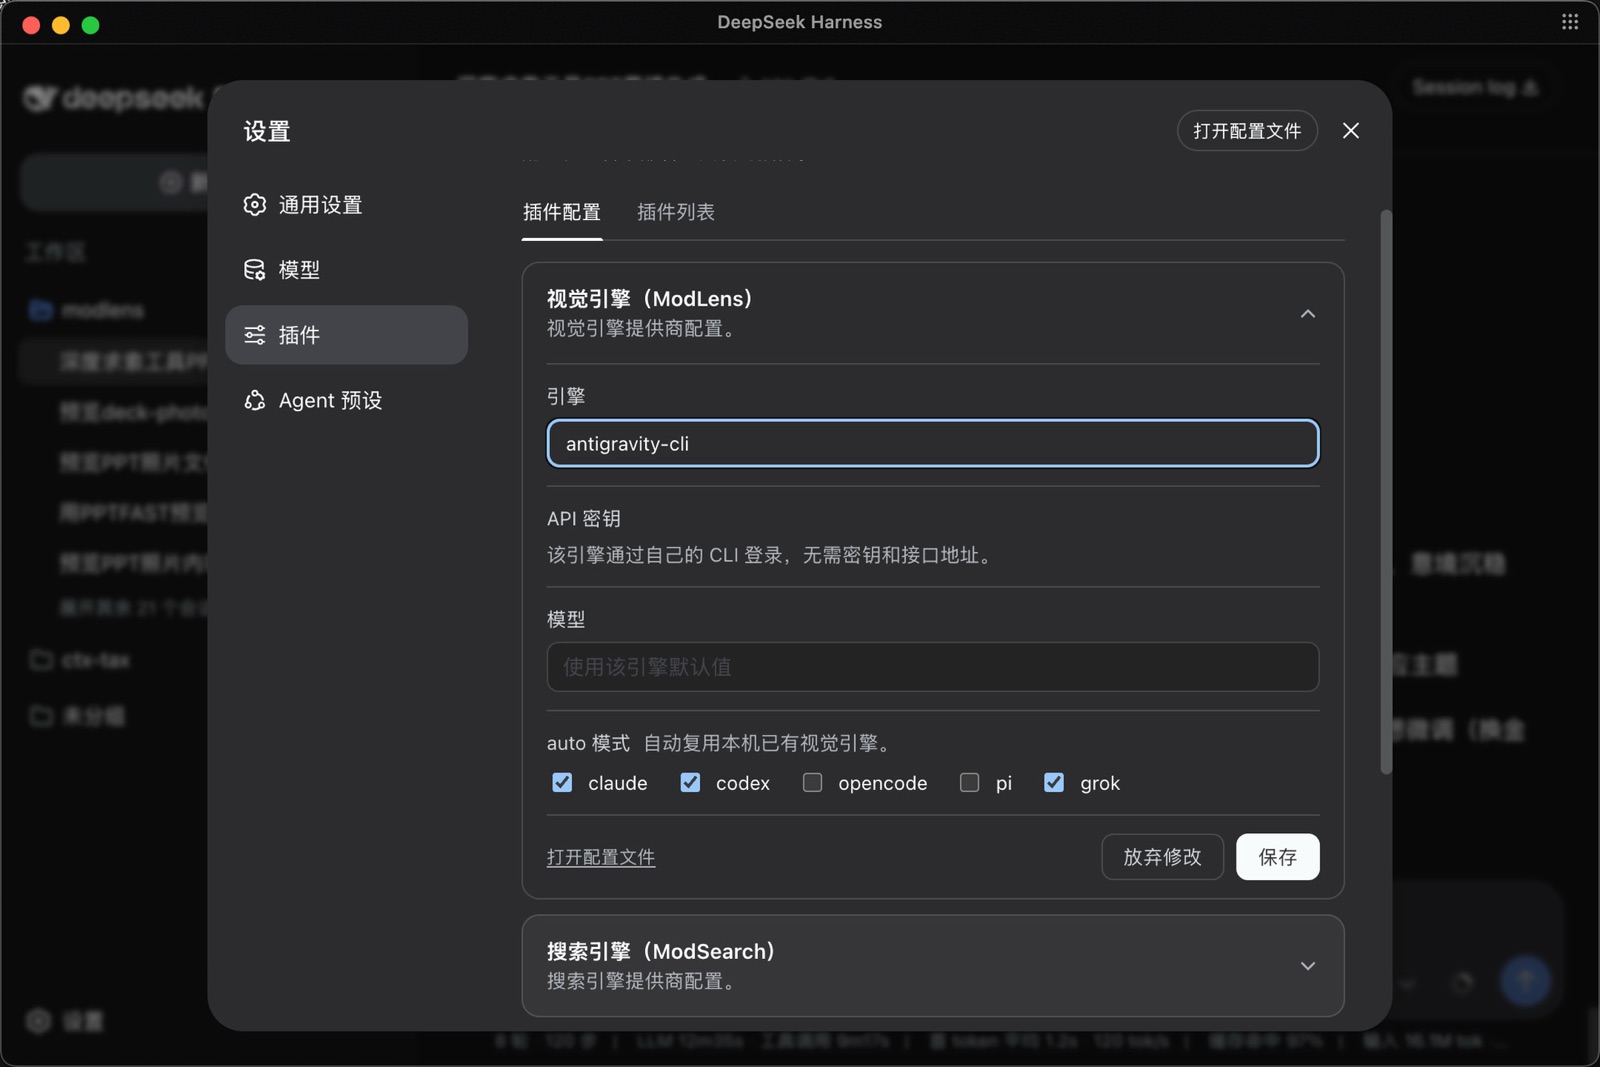
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
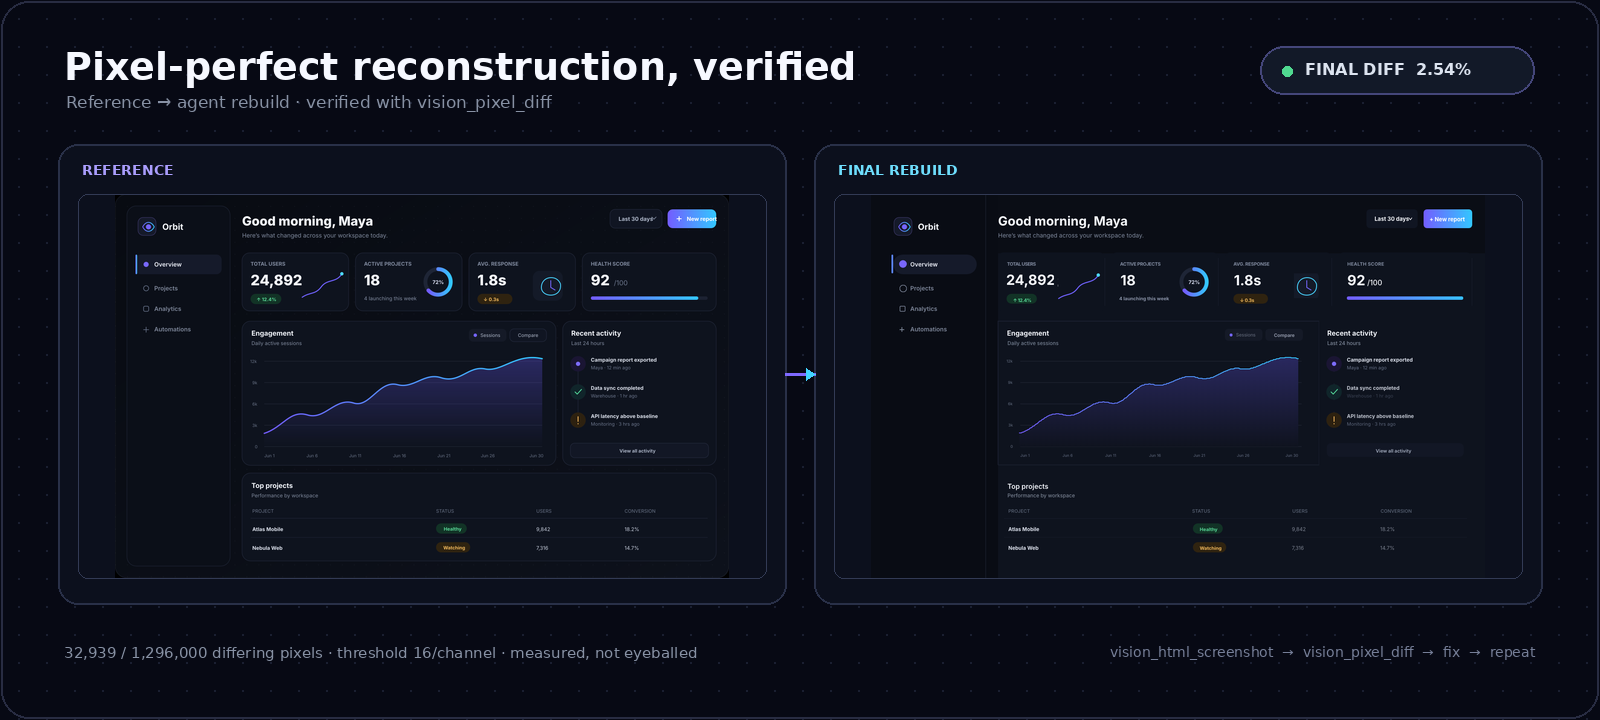
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。