dsh-stepwise-distill
在终端中运行以下命令:
dsh plugin install yunxiyang/dsh-stepwise-distill
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install yunxiyang/dsh-stepwise-distill 安装本插件,源码仓库为 https://github.com/yunxiyang/dsh-stepwise-distill。
插件介绍
长对话会让上下文越来越「胖」:模型反复读到已经想完的思路、已经写进文件的补丁和脚本正文,而真正需要跟进的用户请求只占提示词的一小块。dsh-stepwise-distill 要做的不是删历史,而是改写「给模型看什么」——同一段对话,少带它已经处理过的冗余,多带它继续干活所需的信息。
插件分两步运作:最新一步仍保留原始消息;更早的每一步在完成后会多一次模型调用,在看见完整当前上下文的前提下,为那一步写下完整记录(不是一两句摘要)。记录写好后,该步的原始消息不再进入后续请求的投影,但事件日志只追加、不删除,需要时仍可通过 history_read 按序号取回原始字节。
代价是明确的:默认开启的 stepSummary(以及 turn 侧的 turnSummary)会让每一步多约一轮模型往返,且摘要请求的输入大致接近你本来就要发的那次请求,整体输入 token 往往接近翻倍。短任务可能更慢、更贵;对话越长,省下的重复展示越多,越适合需要跨很多步、上下文容易「淹没任务」的会话。
适合愿意用时间与 token 换上下文密度的开发者:长任务、多工具调用、助手输出里工具参数占比很高的场景。若只做短对话,可在配置里关闭 stepSummary 与 turnSummary,避免额外开销。
使用场景
- 跨很多步的编码或重构,助手输出里补丁和脚本正文反复占满上下文
- 工具调用密集的任务,结论已在文件里但每轮仍重发完整参数
- 会话越长越容易「淹没」用户请求,需要保留任务脉络而非全文回放
适合人员
- 愿意用约双倍 token 与时间换更稠密上下文的 DeepSeek Harness 用户
- 经常跑长任务、多轮工具调用的开发者
- 需要完整事件日志且偶尔用 history_read 回溯原文的人
相关插件
为编码智能体提供跨工具记忆层,索引本地已有会话历史,在文件编辑、命令执行前后自动召回相关上下文,无需手动检索。
面向 AI 代理的可追溯、可搜索跨会话记忆插件,将对话知识构建为带类型知识图谱,按需召回相关子图而非重放全部历史,原生集成 DeepSeek Harness。
为 DSH 的 AI 赋予跨会话长期记忆,管理待办与技能,并支持多会话协同、外部 AI 派单与无限画板,越用越懂你。
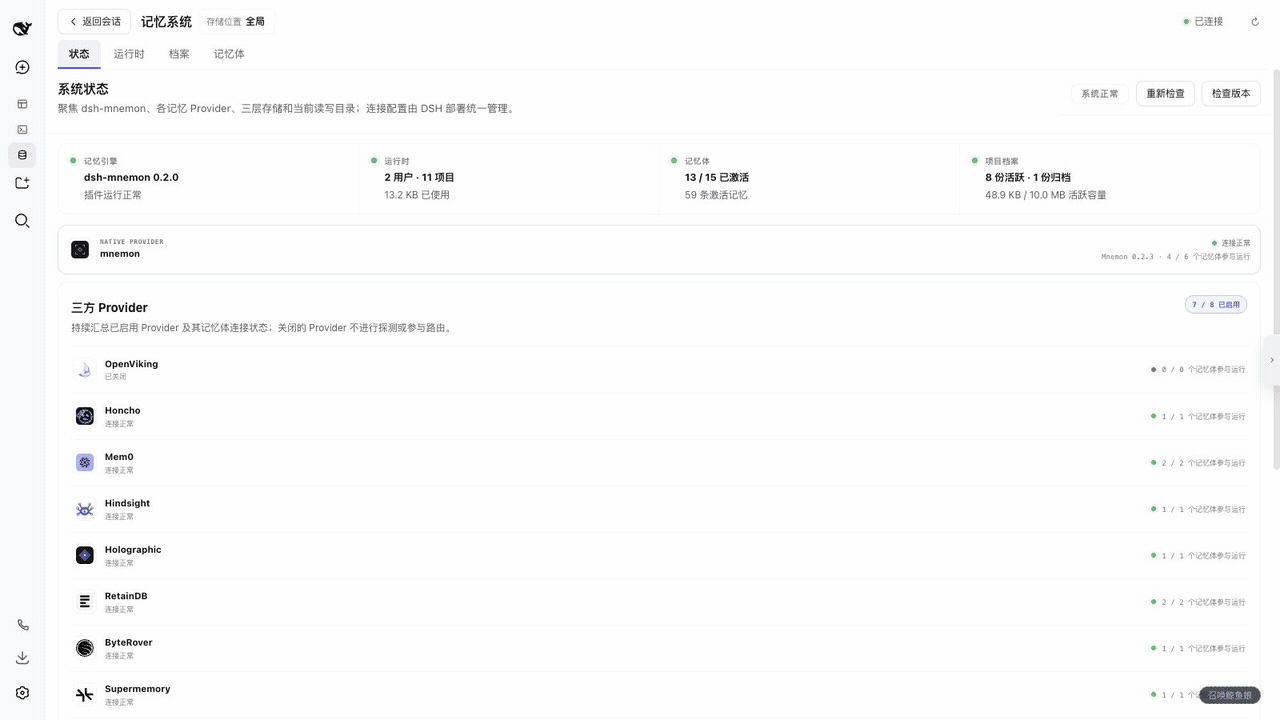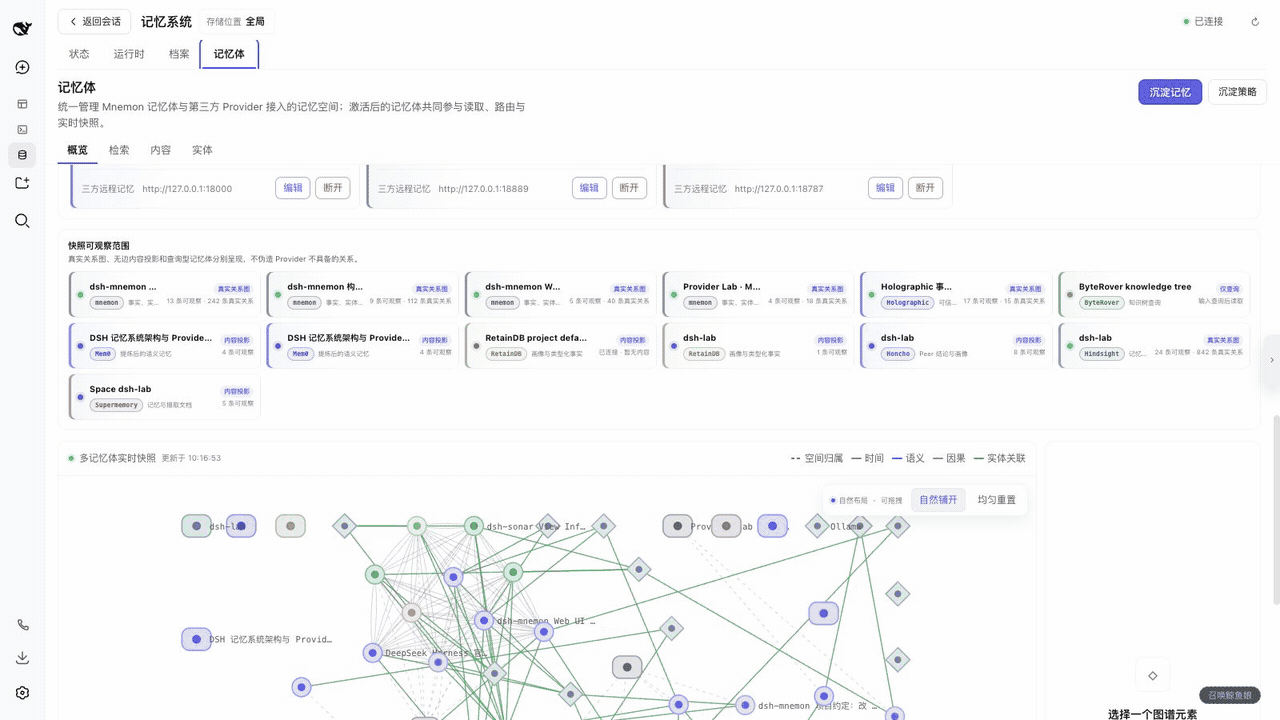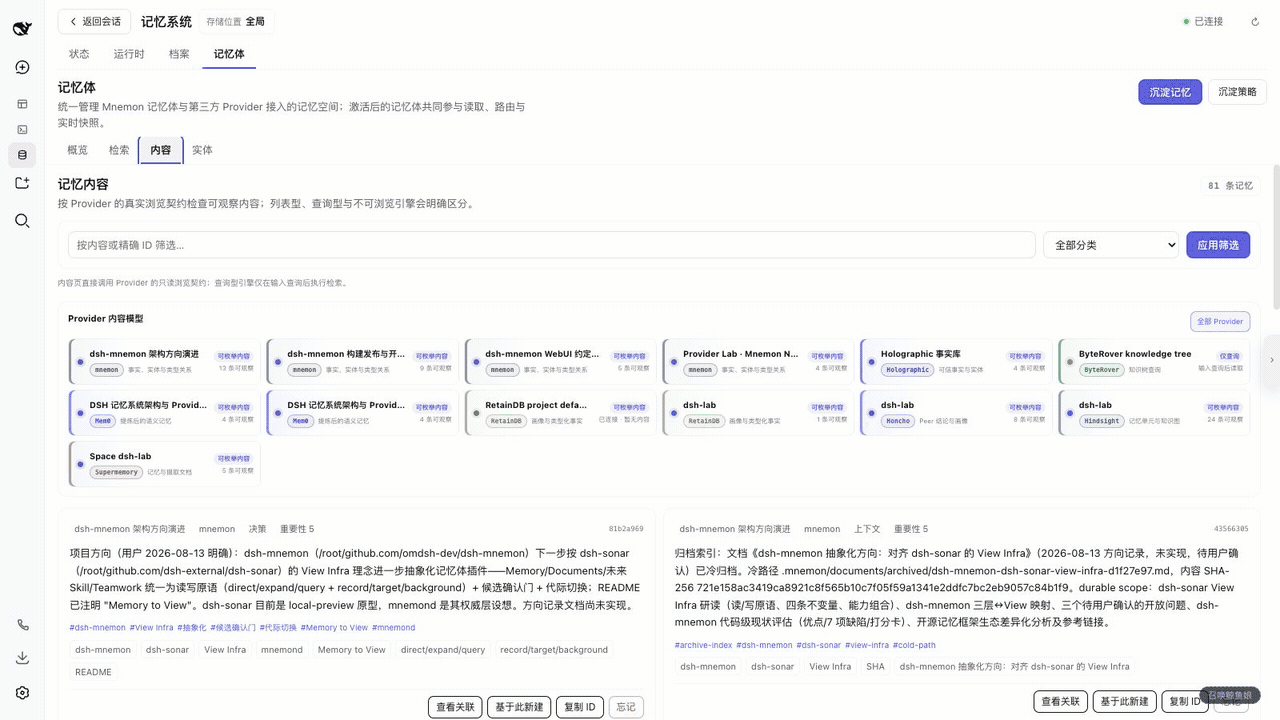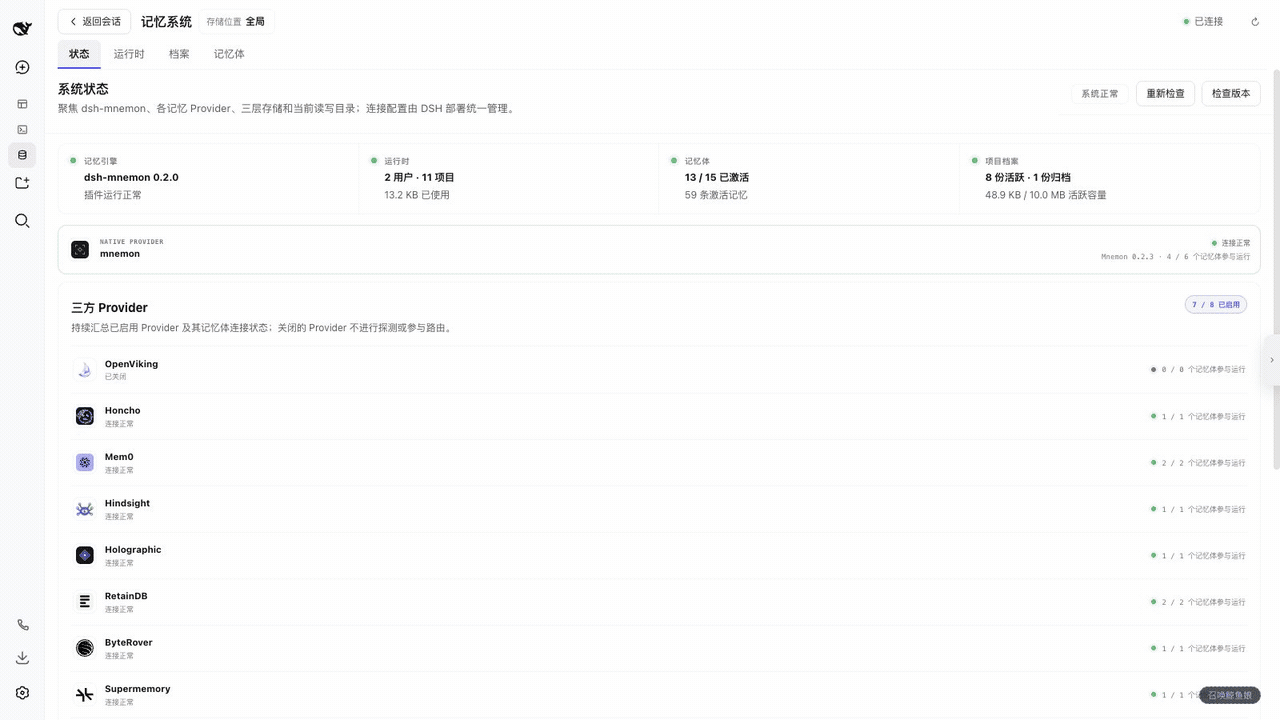
dsh-mnemon 为 DeepSeek Harness 提供三层可插拔、Agent 驱动的记忆系统:运行时上下文、项目文档、可替换记忆空间,支持九种长期提供商。