dsh-plugin-local-infer
在终端中运行以下命令:
dsh plugin install cybtachyon/dsh-plugin-local-infer
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中打开 Plugins → Add Plugin,粘贴 https://github.com/cybtachyon/dsh-plugin-local-infer 安装,或在终端执行 dsh plugin install cybtachyon/dsh-plugin-local-infer。
插件介绍
在自有硬件上跑本地大模型,往往要在多套推理引擎、繁杂启动参数和手写配置之间来回折腾,还容易在显存和上下文上踩坑。dsh-plugin-local-infer 是 DeepSeek Harness 的本地推理管理插件,面向希望在特定硬件上榨出比开箱方案更高性能的用户,把选引擎、选模型、调参、部署和接入 DSH 收拢到同一套界面里。
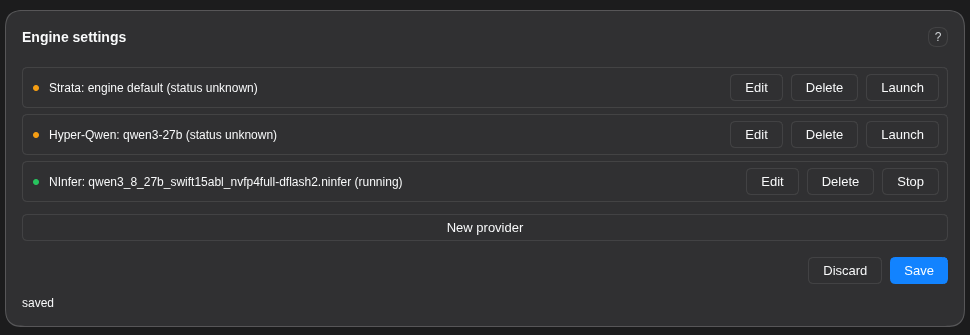
你可以在 Engine settings 里按字段类型调整参数,并实时查看 VRAM 预估:权重、KV cache、开销与工作区会对照当前显卡给出 fits / tight / over 的判断,以及可容纳的最大上下文。当参数或组合对检测到的硬件不安全时,会以醒目告警提示;系统依赖缺失时也会列出用途与安装方式,满足条件后才能启动。
Launch 会拉取或构建引擎、下载模型并做健康检查;确认可用后 Register 可将服务登记为 DSH 模型(也可设为 Agent 默认),变更可追踪、可撤销。当前支持 NInfer、Hyper-Qwen(vLLM)、llama.cpp、Strata 等引擎,配置持久化在本地,浏览器只展示已保存的值。
适合已在 Linux(Debian/Ubuntu、Arch 等)上搭建本地推理、希望少改 yaml、少手工维护启动脚本,又需要显存与硬件风险提示的 DSH 用户;macOS 可走 CPU/docker 路径,部分平台仍在完善或未经充分验证。
截图预览
使用场景
- 在自有 GPU 上选型并启动 NInfer、llama.cpp 等引擎
- 调参时对照显存预估,避免上下文或量化超出显卡容量
- 推理服务健康后一键注册为 DSH 可用模型
适合人员
- 希望在特定硬件上跑本地大模型的 DSH 用户
- 不想手写 yaml 与启动脚本、需要统一管理的自建推理者
- 需要硬件与显存风险提示的 Linux 本地部署用户
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
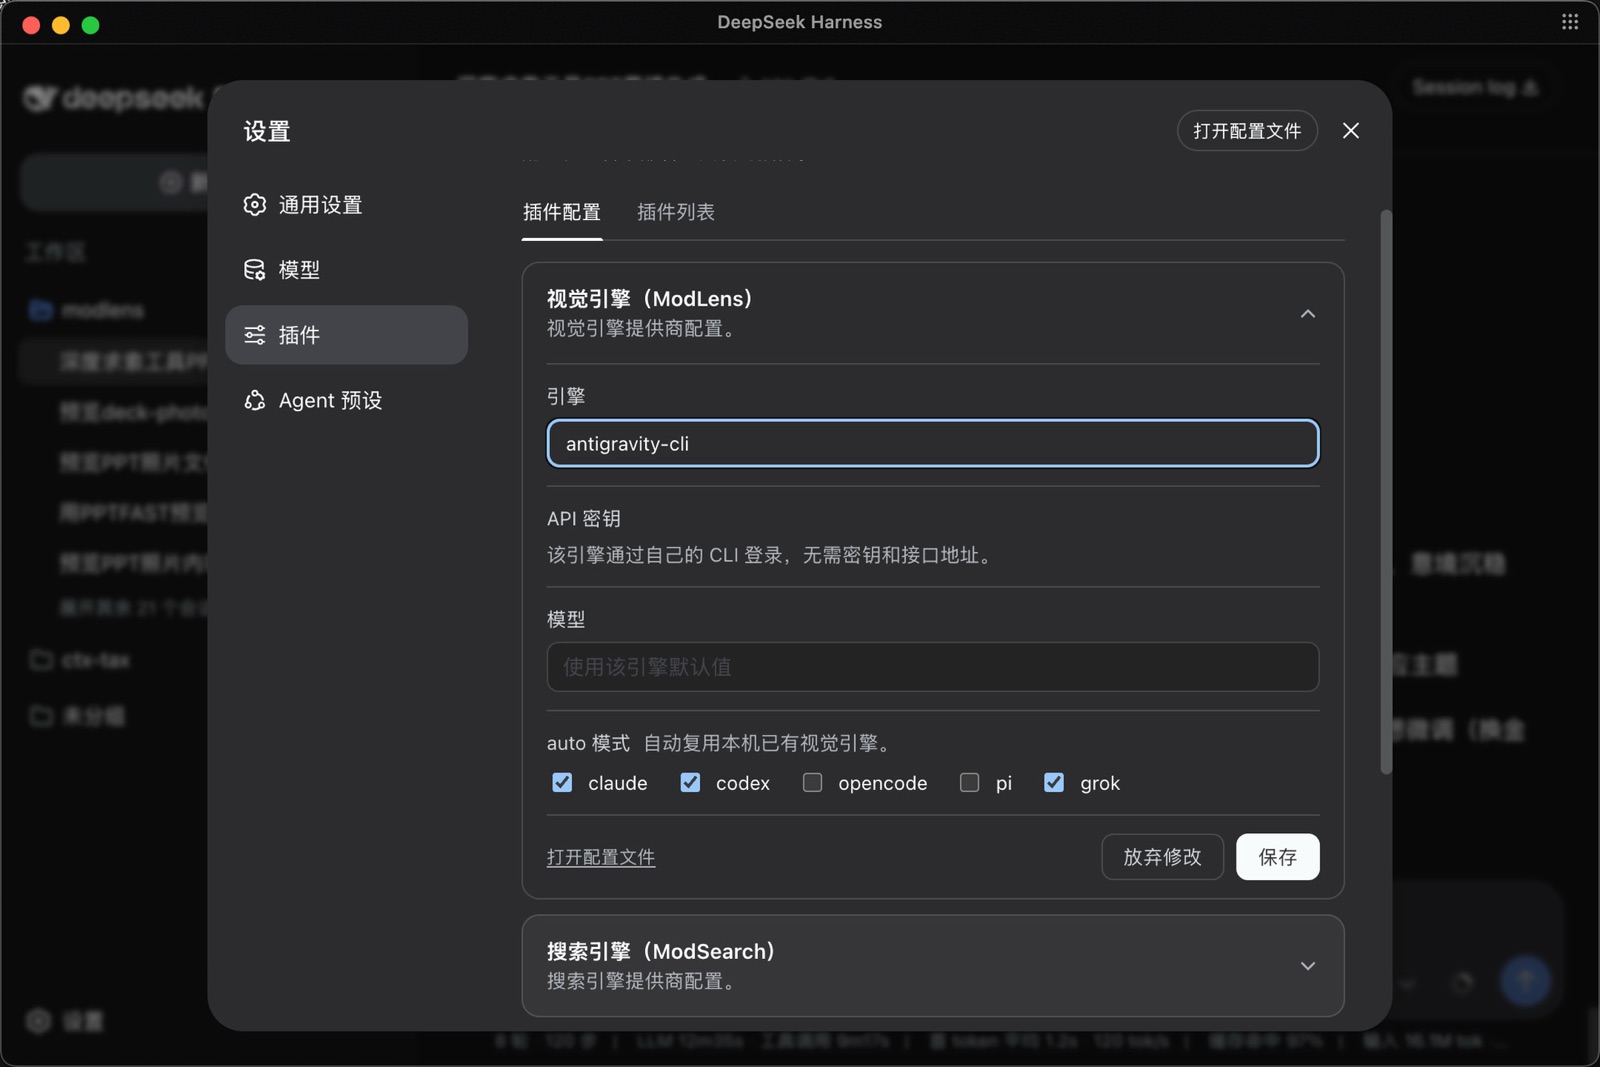
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
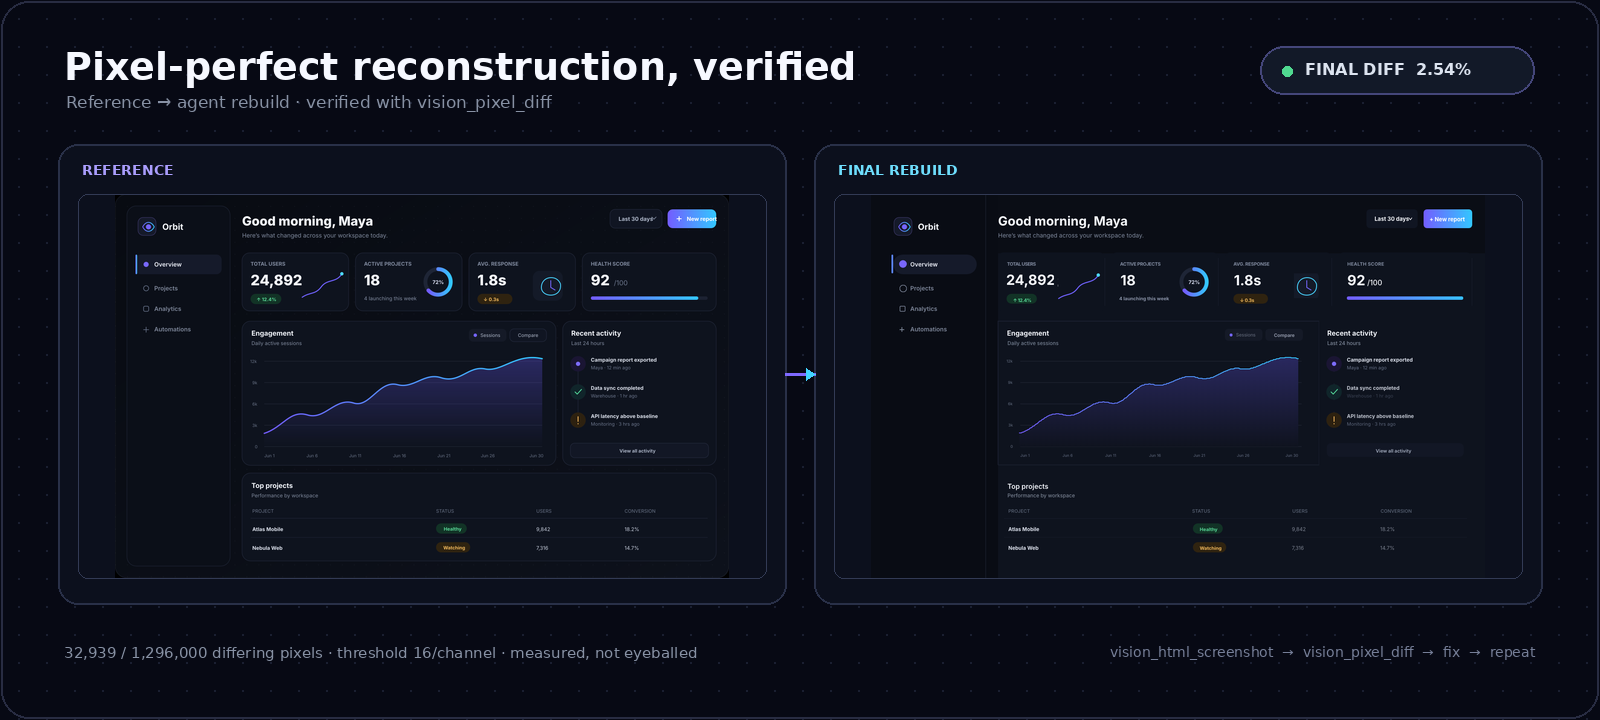
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。