context-guardian
在终端中运行以下命令:
dsh plugin install LuminariSoftwares/context-guardian
将以下提示词粘贴到 DeepSeek Harness 对话框中:
在 DeepSeek Harness 中执行 dsh plugin install LuminariSoftwares/context-guardian,或按 https://github.com/LuminariSoftwares/context-guardian 文档在 agent preset 中启用原生压缩引擎。
插件介绍
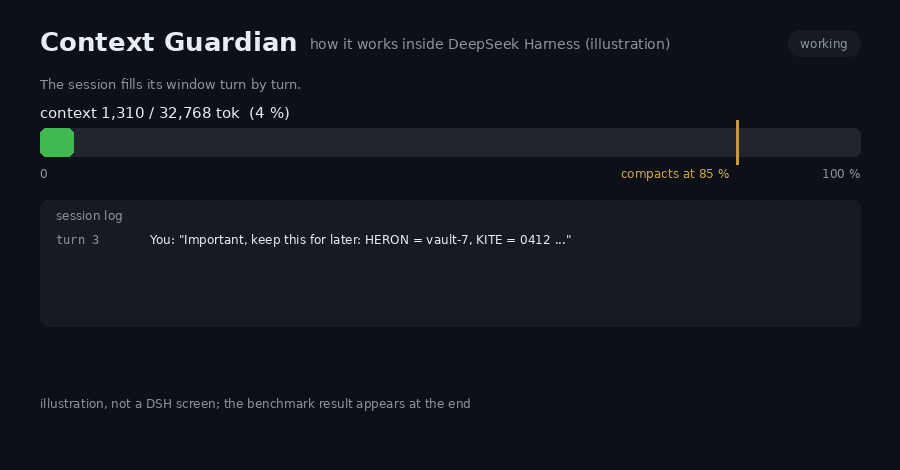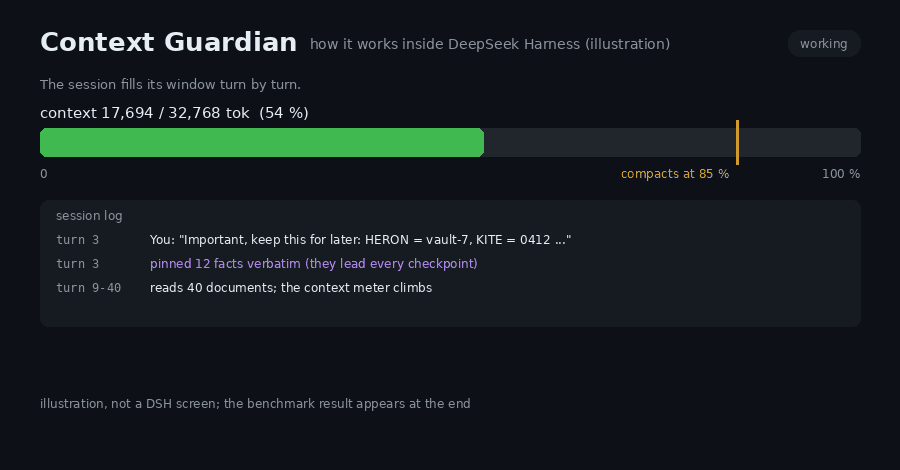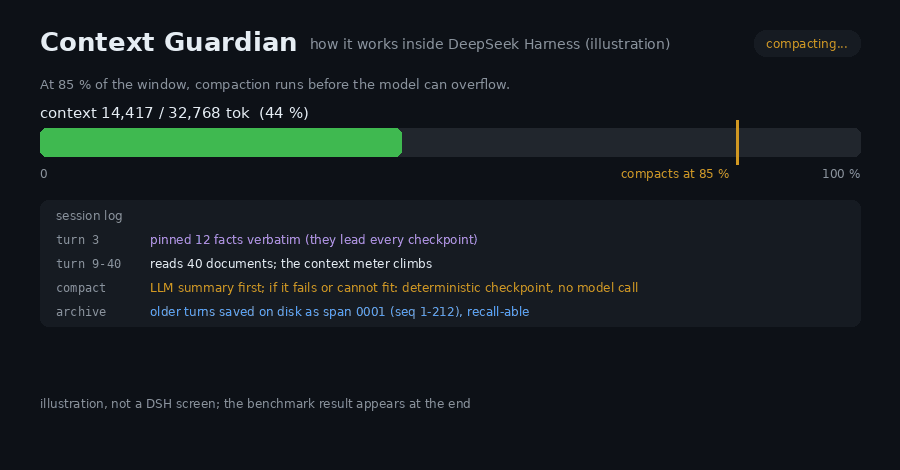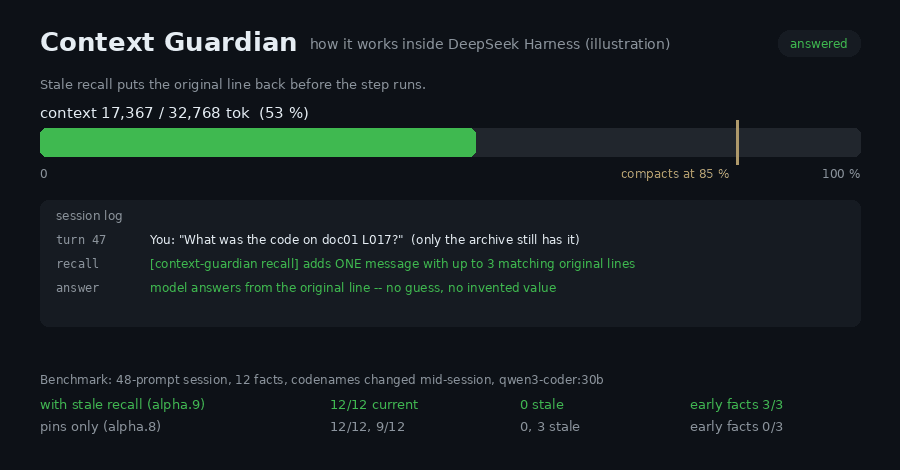
用 Ollama、LiteLLM 或 LM Studio 跑本地模型时,Claude Code 一类工具自带的自动压缩往往因 token 统计不准而从不触发,会话会一直涨到后端直接拒绝请求,中间没有缓冲,上下文一断就得重来。Context Guardian 针对的就是这个缺口:它自己估算上下文用量,在窗口被撑满之前主动压缩,并把完整原文留在磁盘上,而不是让对话随一次硬错误一起消失。
项目提供两条接入路径,理念一致。面向任意 CLI 或 Agent 的代理层挂在 OpenAI 兼容后端(Ollama、LiteLLM、Headroom、vLLM、LM Studio 等)前面,处理 /v1/chat/completions;DeepSeek Harness 用户则可在 agent preset 里启用原生 engine。两边都会在压缩后保留归档,并采用 fail open 策略——摘要失败或装不下时,会走确定性 checkpoint 等回退,尽量不让整段会话一起挂掉。DSH 侧还支持 pins、stale recall 把被压掉的早期细节捞回来,handoff 文件便于换会话续工。
若你长期用本地小窗口模型做编码或长对话,又厌倦了「突然 token limit、只能开新会话」的体验,这个插件值得试。代理路径适合 Continue、Cline、OpenCode 等把 OPENAI_BASE_URL 指到本地的用户;DSH 用户可与 Tool Guardian 搭配,一个管对话压缩,一个管工具 schema 与结果占窗,互不抢文件。
截图预览
使用场景
- 本地 Ollama 长会话在触顶前被代理自动压缩,避免硬拒绝
- DSH 中小窗口模型频繁压缩时仍保留 pins 与 stale recall
- Continue、Cline 等客户端把 Base URL 指向 Guardian 代理继续编码
适合人员
- 用本地小上下文跑编码 CLI 的开发者
- DeepSeek Harness 长对话用户
- 需要磁盘归档与召回的 Agent 运维者
相关插件
在 dsh 安装即用,无需账号与 API Key,免费不限量调用 DeepSeek V4.1 Flash、Kimi K3 等前沿模型,并含 OpenAI 兼容本地网关。
集运行时热注入、任务感知模式路由与会话级分级协议于一体,实现免重启装配、P1-P23实测路由及红队门审计,保障长程推理勤勉度。
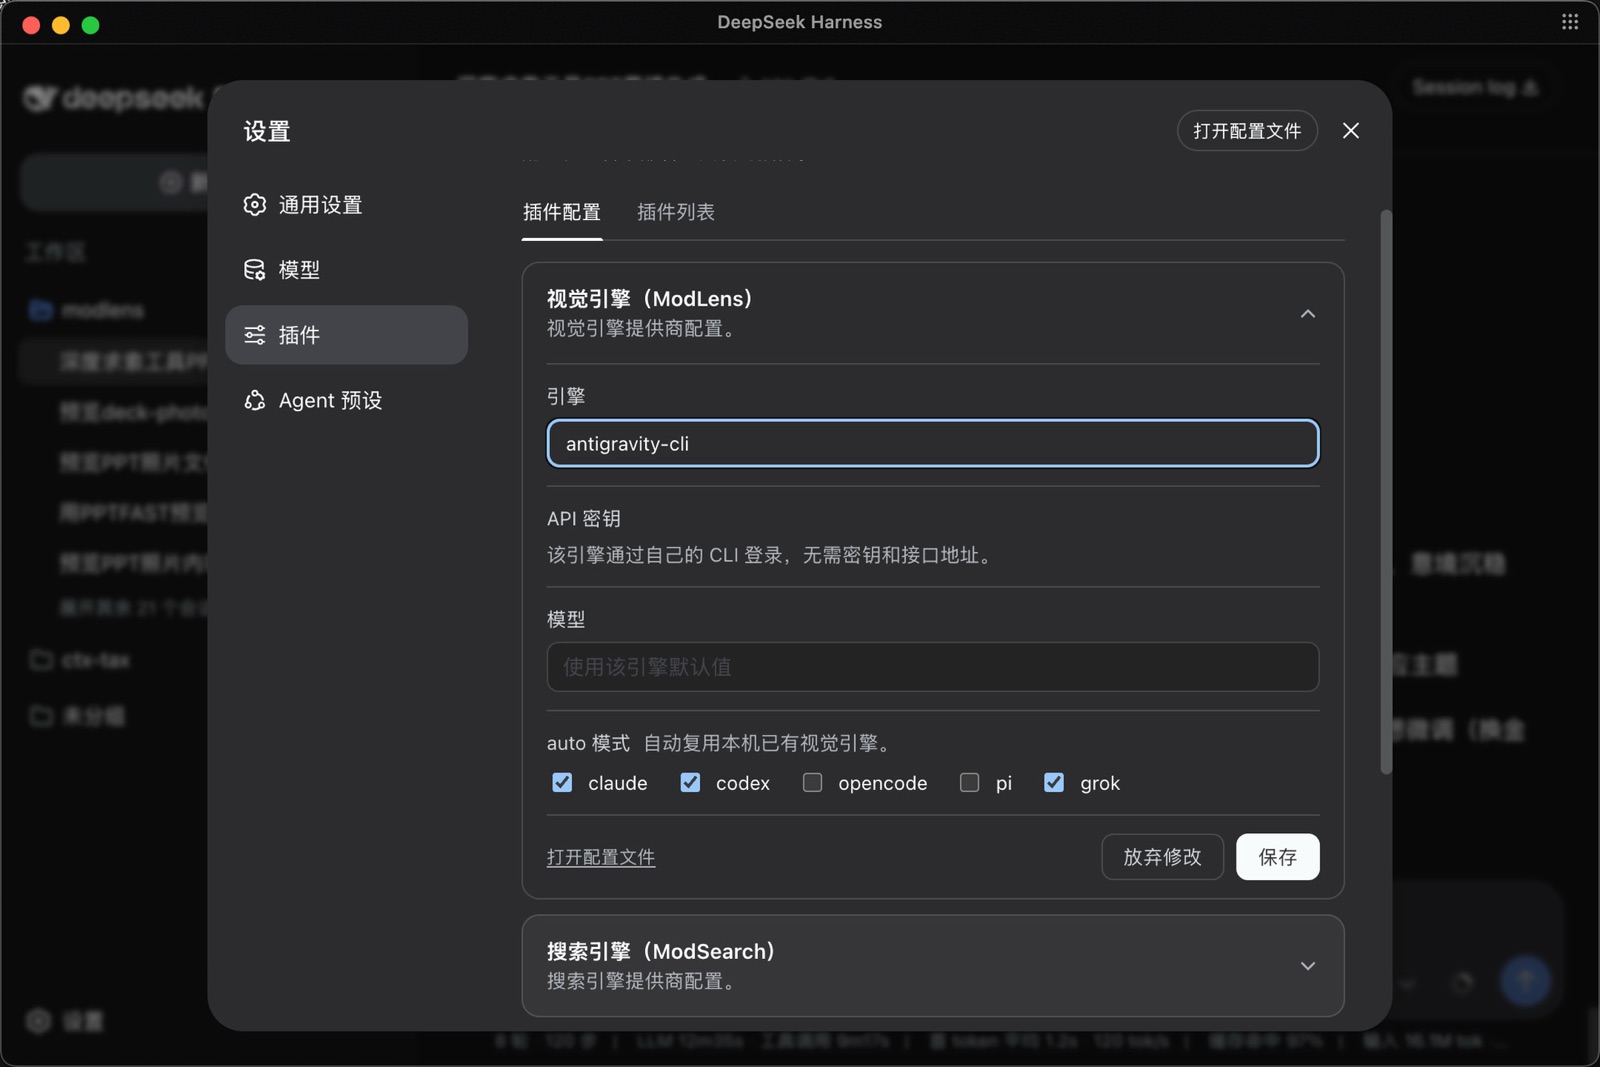
ModLens 是 DeepSeek Harness 的视觉插件,让纯文本模型直接读取聊天中粘贴的图片,无需保存文件或传路径,零配置并支持多引擎。
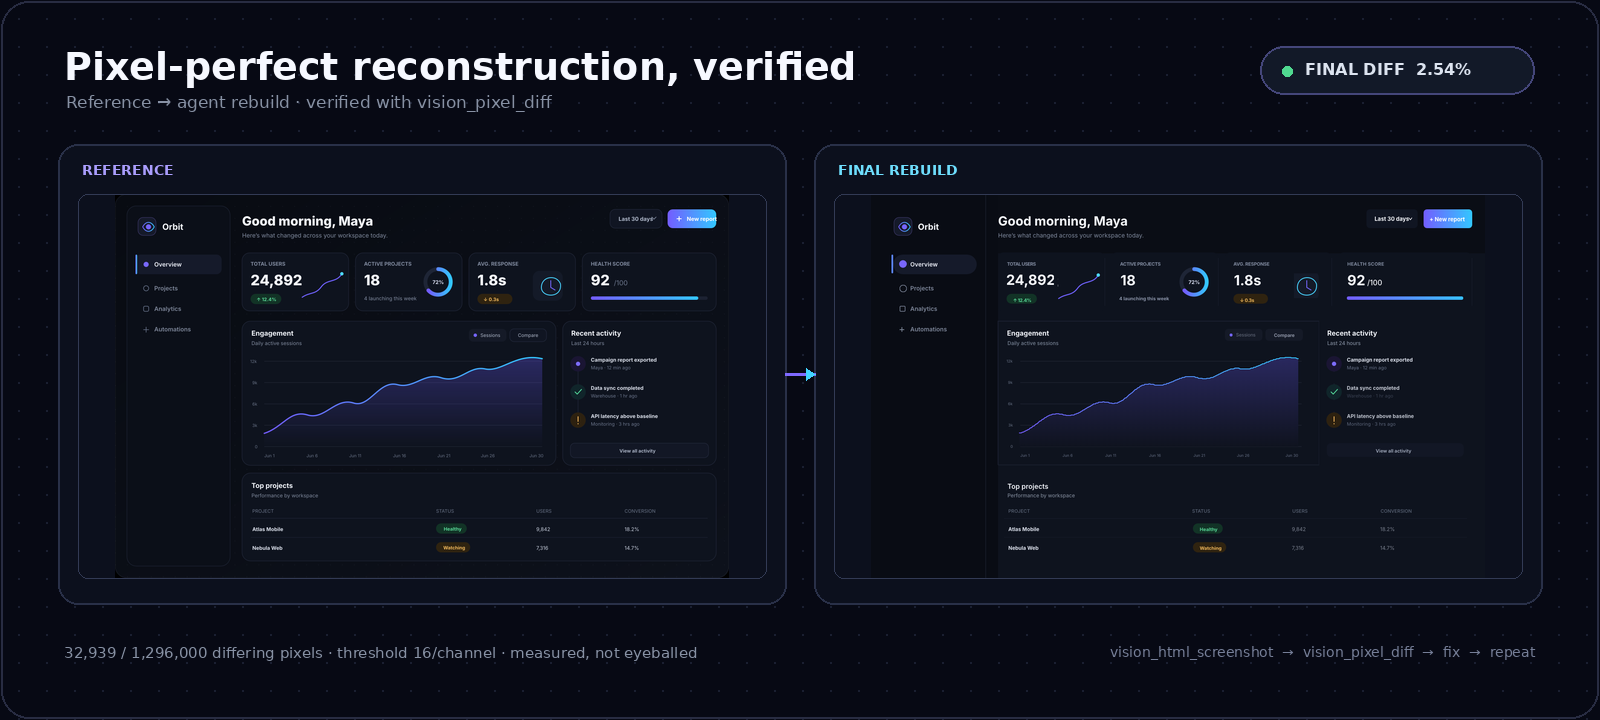
为DeepSeek Harness文本代理提供按需视觉能力:内置免费无密钥视觉链与14个视觉工具,图像作为工具调用路由到视觉模型,像素保真,无需Python,一键安装。